Bài GMP kết thúc với một cạm bẫy: số OS thread (M) có thể tăng vọt khi goroutine chặn trong syscall thật. Vậy sao một server Go xử lý được hàng chục nghìn kết nối đồng thời mà không tạo hàng chục nghìn thread? Vì I/O mạng không phải syscall blocking bình thường — nó đi qua netpoller, cơ chế tích hợp epoll (Linux) / kqueue (BSD) vào scheduler. Bài này mổ xẻ netpoller và đo thật sự khác biệt khổng lồ giữa I/O mạng và syscall thường.
Cơ chế: chặn goroutine, không chặn thread
Khi một goroutine gọi conn.Read() mà socket chưa có dữ liệu, thay vì chặn cả OS thread trong kernel, runtime làm năm bước:
- Đăng ký file descriptor (fd) với hệ thống thông báo sự kiện của OS —
epolltrên Linux,kqueuetrên BSD/macOS. - Park goroutine — gỡ nó khỏi M (OS thread) và cất đi.
- Thả M — thread được giải phóng để chạy goroutine khác ngay lập tức.
- Scheduler định kỳ gọi
epoll_wait(trong vòng tìm việc và trong sysmon) để hỏi OS những fd nào đã sẵn sàng. - Khi fd có dữ liệu, goroutine tương ứng được đánh thức và đưa lại vào hàng đợi để chạy tiếp.
Kết quả: N goroutine chờ mạng chỉ cần một nhúm M giữ chỗ, không phải N thread. Đây là chìa khóa để Go giải bài C10k/C1M — hàng trăm nghìn kết nối đồng thời trên một pool thread nhỏ.
ln, _ := net.Listen("tcp", "127.0.0.1:0")
go func(conn net.Conn) {
    buf := make([]byte, 16)
    conn.Read(buf)   // CHẶN chờ dữ liệu -> netpoller park goroutine, KHÔNG giữ M
}(c)
// mở 5000 kết nối, đếm NumGoroutine vs threads (schedtrace)
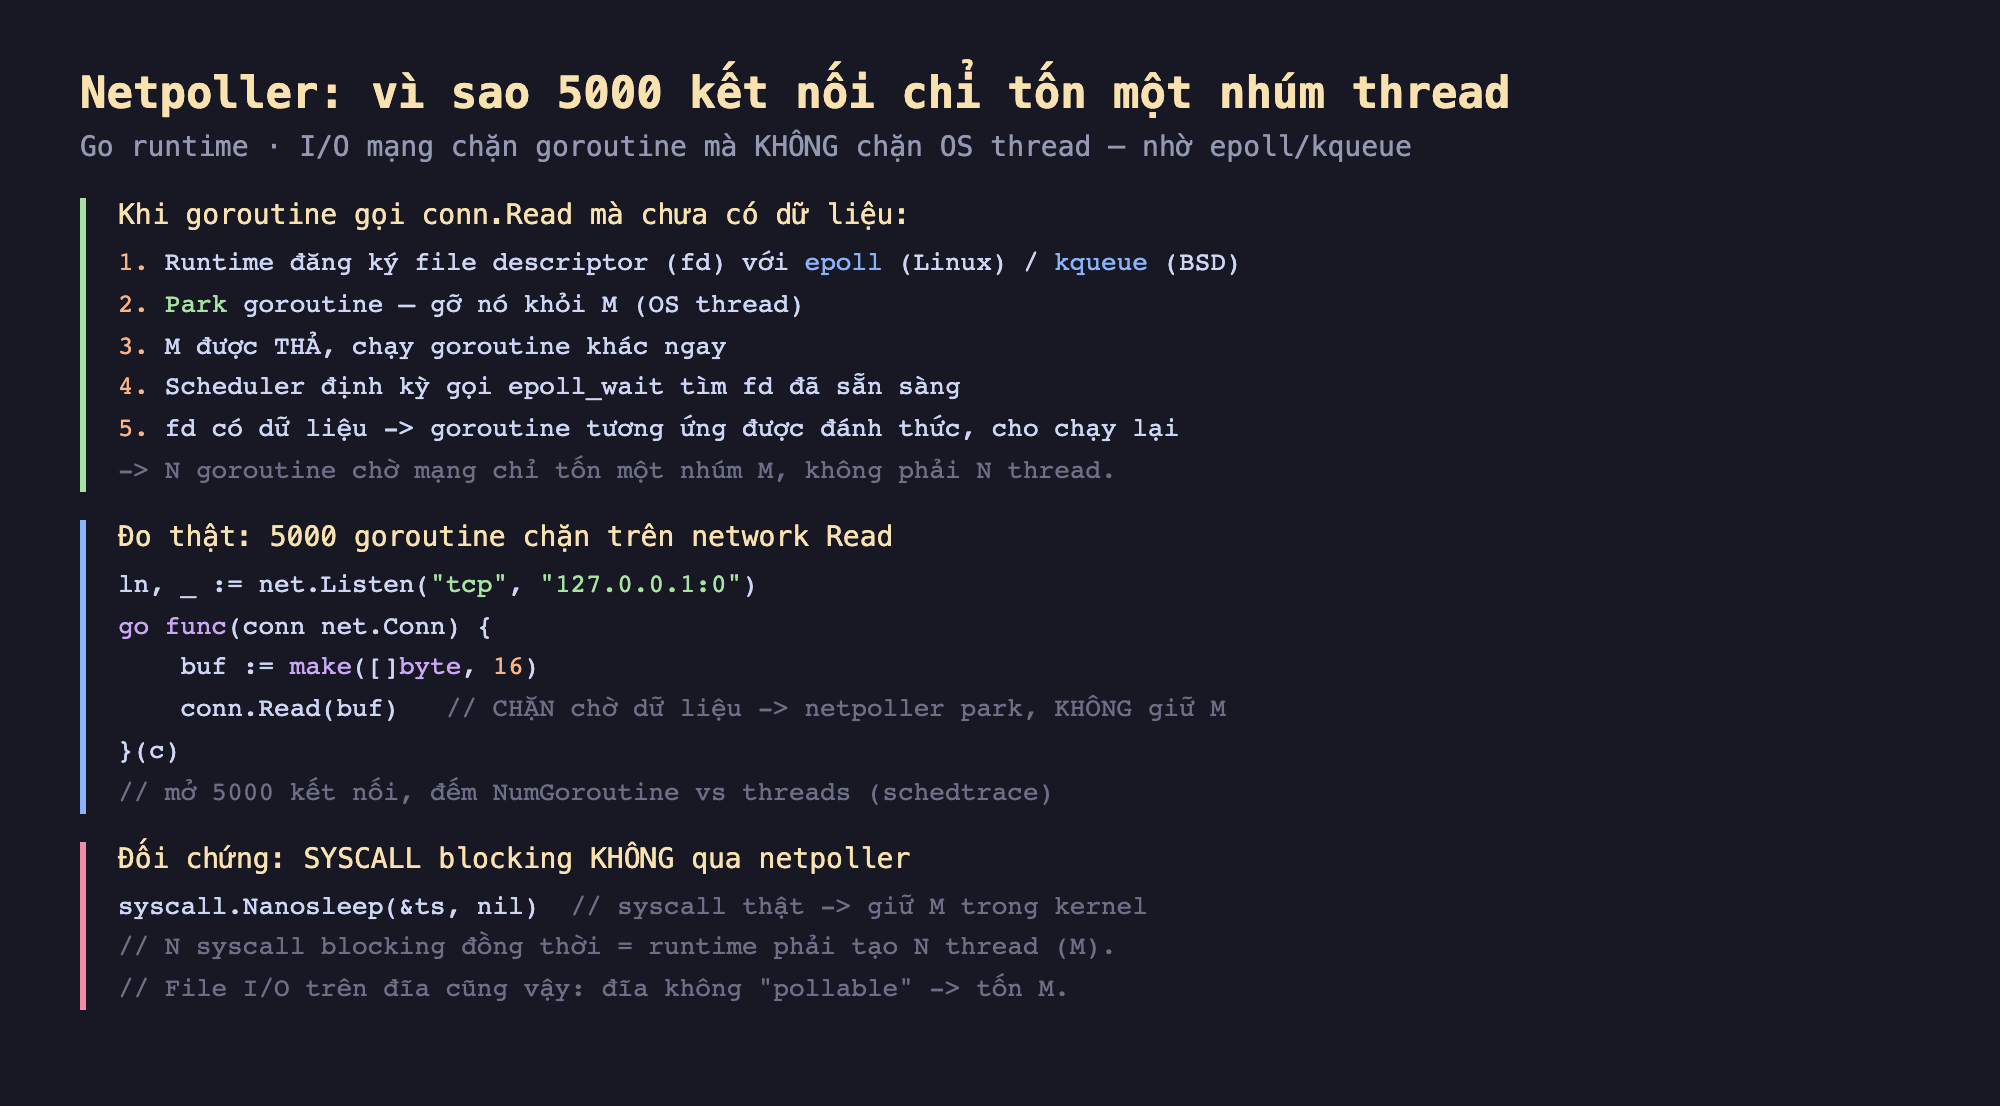
Hình 1: Năm bước của netpoller — đăng ký fd với epoll, park goroutine, thả M, poll tìm fd sẵn sàng, đánh thức goroutine. Kèm mã đo và đối chứng với syscall blocking.
Đo thật: 16 thread hay 203 thread
Tôi đo hai kịch bản đối lập trên cùng một máy:
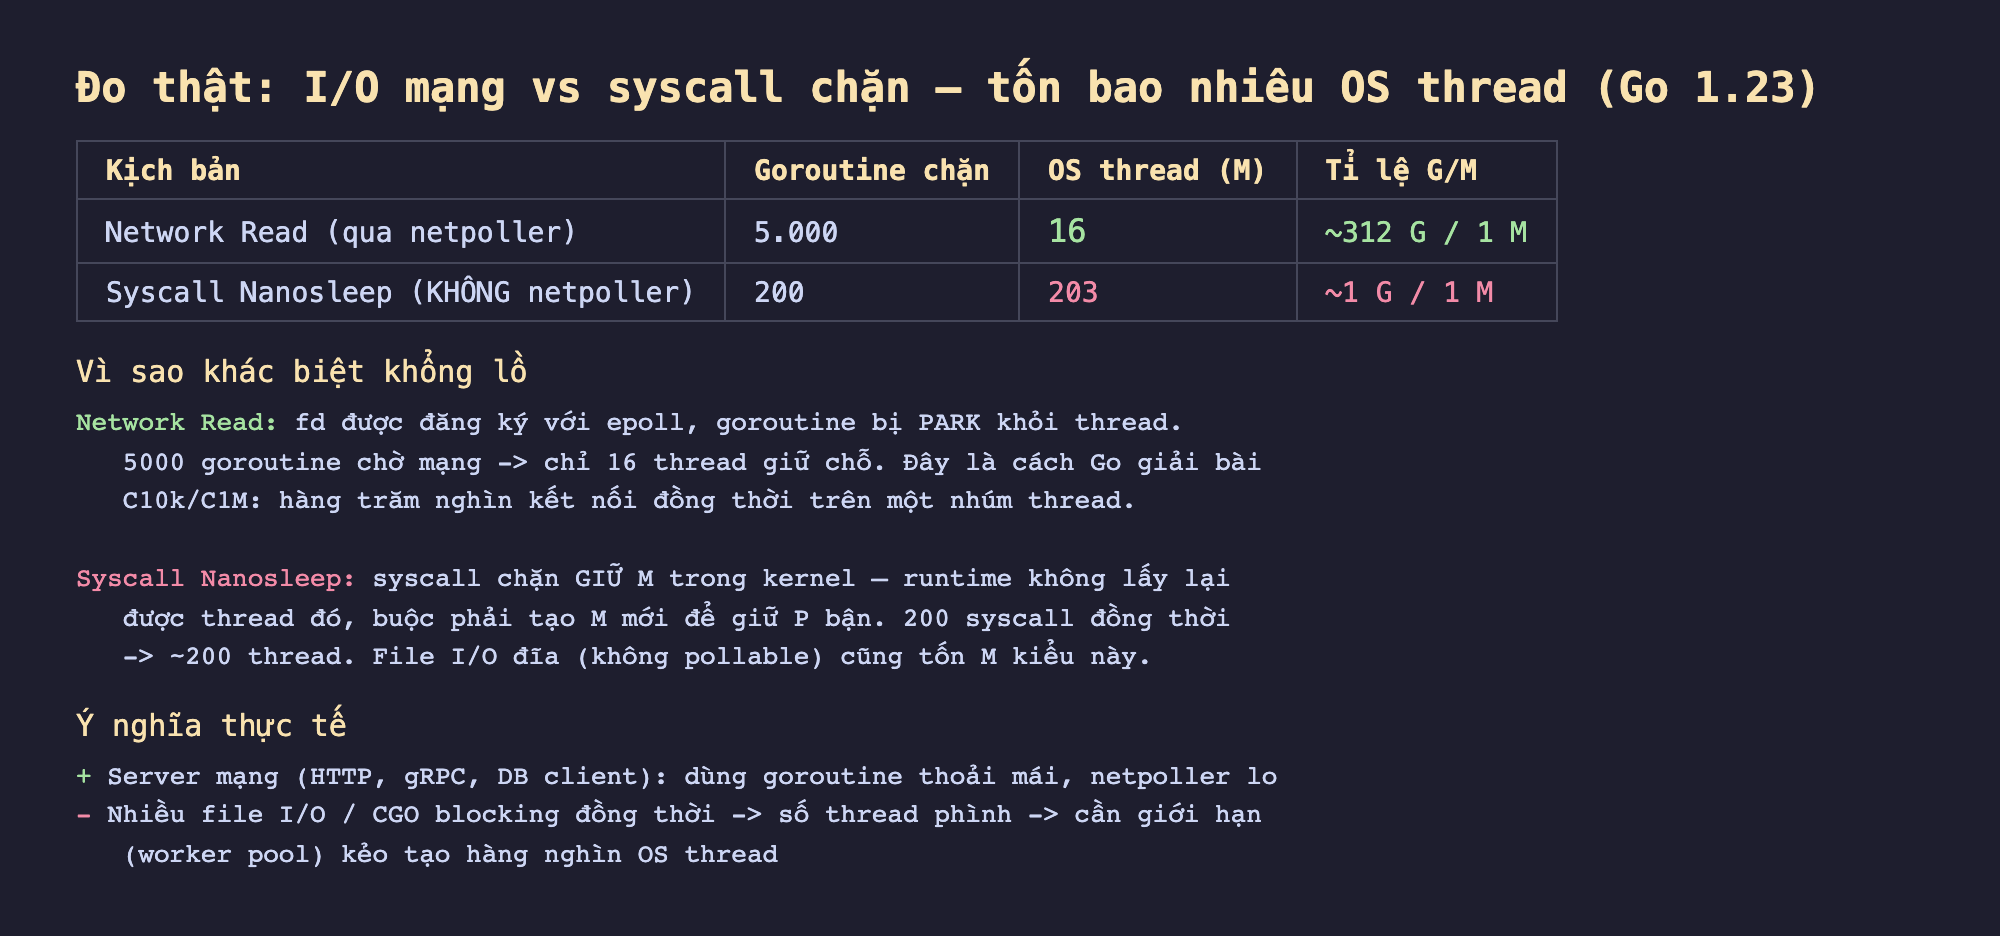
Hình 2: Network Read qua netpoller — 5000 goroutine chặn chỉ dùng 16 thread (~312 G/M). Syscall Nanosleep không qua netpoller — 200 goroutine chặn ngốn 203 thread (~1 G/M). Khác biệt là bản chất netpoller.
Con số thật:
- Network Read (qua netpoller): 5.000 goroutine chặn trên
conn.Read→ chỉ 16 OS thread. Tỉ lệ ~312 goroutine trên mỗi thread. - Syscall Nanosleep (không qua netpoller): 200 goroutine chặn trong một syscall thật → 203 thread — gần như một thread cho mỗi goroutine.
Khác biệt không phải tình cờ mà là bản chất:
- I/O mạng: fd được đăng ký với epoll, goroutine bị park khỏi thread. Thread rảnh chạy việc khác. 5000 kết nối chờ chỉ tốn 16 thread giữ chỗ.
- Syscall blocking:
syscall.Nanosleep(hay bất kỳ syscall chặn nào) giữ M trong kernel — runtime không lấy lại được thread đó, buộc phải tạo M mới để giữ P bận. 200 syscall đồng thời → ~200 thread. File I/O trên đĩa cũng như vậy: đĩa cứng không "pollable" với epoll, nên đọc file blocking tốn một M.
Ý nghĩa thực tế
Đây là kiến thức có sức nặng khi thiết kế hệ thống:
- Server mạng (HTTP, gRPC, client database qua TCP): cứ tạo một goroutine cho mỗi kết nối/request thoải mái. Netpoller lo phần chặn I/O, số thread giữ nhỏ. Đây là lý do mô hình "một goroutine mỗi request" của Go vừa đơn giản vừa mở rộng tốt tới hàng trăm nghìn kết nối.
- File I/O hoặc CGO blocking đồng thời: đây là điểm cần cẩn thận. Nếu bạn mở hàng nghìn goroutine cùng đọc/ghi file đĩa (hoặc gọi hàm C blocking), số OS thread có thể phình lên hàng nghìn — tốn bộ nhớ và làm scheduler nặng nề. Giải pháp: giới hạn số goroutine làm file I/O đồng thời bằng một worker pool hay semaphore (bài riêng sẽ đo).
Đánh đổi cần cân nhắc
Netpoller không miễn phí về độ trễ đánh thức. Goroutine bị park được đánh thức khi scheduler gọi epoll_wait và thấy fd sẵn sàng — có một độ trễ nhỏ giữa lúc dữ liệu tới và lúc goroutine chạy lại. Với đại đa số ứng dụng, độ trễ này không đáng kể; nhưng với hệ thống cần độ trễ cực thấp (high-frequency trading), người ta đôi khi dùng cơ chế polling riêng để tránh qua netpoller.
Không phải mọi fd đều pollable. Netpoller chỉ áp dụng cho socket, pipe, và các fd hỗ trợ epoll/kqueue. Regular file trên đĩa không pollable trên Linux — đó là lý do file I/O rơi vào mô hình "một thread mỗi thao tác blocking". Biết cái nào đi qua netpoller (mạng, pipe) và cái nào không (file đĩa, CGO) giúp bạn dự đoán số thread.
Số M vẫn có trần và có chi phí. Runtime giới hạn số M ở 10000 mặc định (runtime/debug.SetMaxThreads). Nếu file I/O blocking tạo quá nhiều M chạm trần này, chương trình sẽ panic. Ngay dưới trần, hàng nghìn thread cũng tốn bộ nhớ stack và làm kernel lập lịch nặng. Vì thế giới hạn concurrency cho blocking I/O là thực hành quan trọng.
Ba ý mang về
- Netpoller tích hợp epoll/kqueue vào scheduler để I/O mạng chặn goroutine mà không chặn thread: khi socket chưa sẵn sàng, runtime đăng ký fd với epoll, park goroutine khỏi M, và thả M chạy việc khác — đo thật 5000 goroutine chờ network Read chỉ dùng 16 thread.
- Syscall blocking (và file I/O đĩa) KHÔNG qua netpoller nên tốn một M mỗi thao tác: đo thật 200 goroutine chặn trong
syscall.Nanosleepngốn 203 thread — vì syscall giữ M trong kernel, buộc runtime tạo M mới; đĩa không pollable cũng vậy. - Thực tế: server mạng cứ dùng goroutine thoải mái (netpoller lo), nhưng giới hạn concurrency cho file I/O và CGO blocking bằng worker pool/semaphore để số OS thread không phình lên hàng nghìn — và nhớ netpoller có độ trễ đánh thức nhỏ, số M có trần mặc định 10000.
Bài tập làm thử
Bài 1 (đọc hiểu). Bài đo được hai kịch bản trên cùng một máy: 5.000 goroutine chặn trên conn.Read() (network) chỉ dùng 16 OS thread, còn 200 goroutine chặn trong syscall.Nanosleep (syscall thật) dùng tới 203 OS thread. Giải thích vì sao cùng là "goroutine bị chặn", hai con số M lại chênh lệch đến vậy.
Đáp án
Vì conn.Read() khi chưa có dữ liệu đi qua netpoller: fd của socket được đăng ký với epoll/kqueue, goroutine bị park (gỡ khỏi M), và M được thả ngay để chạy goroutine khác — không phải giữ một M cho mỗi goroutine chờ. Ngược lại, syscall.Nanosleep là một syscall blocking thật, giữ M trong kernel; runtime không lấy lại được M đó nên phải tạo M mới để giữ P bận, gần như một M cho mỗi goroutine chặn (~1 G/M so với ~312 G/M ở trường hợp network).
Bài 2 (sửa lỗi). Đoạn code dưới định giới hạn tối đa 10 goroutine đọc file đồng thời bằng một semaphore, nhưng chạy với danh sách hơn 10 file sẽ bị treo (deadlock) sau khi khởi động đúng 10 goroutine đầu:
func processAll(files []string) {
    sem := make(chan struct{}, 10) // giới hạn 10 goroutine đọc file cùng lúc
    var wg sync.WaitGroup
    for _, path := range files {
        sem <- struct{}{}
        wg.Add(1)
        go func(p string) {
            defer wg.Done()
            data, _ := os.ReadFile(p)
            process(data)
        }(path)
    }
    wg.Wait()
}
Lỗi ở đâu và sửa thế nào?
Đáp án
Goroutine không bao giờ trả lại chỗ trong sem sau khi đọc xong file — thiếu thao tác nhận (<-sem). Sau khi 10 goroutine đầu chiếm hết buffer của sem, dòng sem <- struct{}{} ở lần lặp thứ 11 chặn vĩnh viễn vì không ai giải phóng chỗ, khiến vòng lặp phân phối việc treo luôn. Sửa: giải phóng semaphore khi goroutine xong việc, ví dụ thêm defer func() { <-sem }() ngay đầu goroutine (trước hoặc sau defer wg.Done()).
Bài 3 (vận dụng). Một dịch vụ mở 500 goroutine, mỗi goroutine đọc một file lớn trên đĩa bằng os.ReadFile (blocking, không qua netpoller vì đĩa không pollable). Dựa trên tỉ lệ đo được trong bài (network ~312 G/M, syscall blocking ~1 G/M), dự đoán số OS thread (M) mà runtime cần tạo để phục vụ 500 goroutine đọc file đồng thời này, và so sánh với việc 500 goroutine đó thay vào đó đang chờ dữ liệu mạng.
Đáp án
Vì đọc file trên đĩa không pollable (không đi qua epoll/kqueue), nó có đặc tính giống syscall blocking (~1 G/M) hơn là network (~312 G/M): dự kiến số M sẽ gần tiệm cận 500 (mỗi thao tác đọc file blocking giữ riêng một M), khác hẳn nếu 500 goroutine đó chờ mạng thì chỉ cần một nhúm nhỏ M (theo tỉ lệ đo được, cỡ 1-2 thread) là đủ.
Bài 4 (bẫy/đánh đổi). Bài kết luận: "server mạng cứ dùng goroutine thoải mái, nhưng giới hạn concurrency cho file I/O và CGO blocking". Dựa trên nội dung bài, giải thích vì sao lời khuyên lại khác nhau giữa hai loại I/O này.
Đáp án
Vì I/O mạng (socket, pipe) đi qua netpoller — fd pollable với epoll/kqueue nên goroutine chặn không giữ M, mô hình "một goroutine mỗi request/kết nối" vừa đơn giản vừa mở rộng tốt tới hàng trăm nghìn kết nối. Ngược lại, file thường trên đĩa không pollable trên Linux, và lời gọi C blocking qua CGO cũng không qua netpoller — mỗi thao tác đó giữ riêng một M, nên hàng nghìn goroutine cùng làm việc này sẽ khiến số OS thread phình lên hàng nghìn, tốn bộ nhớ và làm kernel lập lịch nặng nề. Vì vậy cần giới hạn số goroutine làm việc này đồng thời bằng worker pool hoặc semaphore.
Bài 5 (bẫy/đánh đổi). Runtime Go giới hạn số M ở mức mặc định 10.000. Nếu một ứng dụng mở hàng chục nghìn goroutine cùng gọi hàm CGO blocking đồng thời, điều gì có thể xảy ra khi chạm trần này? Ngoài ra, netpoller có "miễn phí" hoàn toàn về độ trễ không?
Đáp án
Nếu số M cần tạo vượt trần mặc định (10.000, cấu hình qua runtime/debug.SetMaxThreads), chương trình sẽ panic. Và không, netpoller không miễn phí về độ trễ: goroutine bị park chỉ được đánh thức khi scheduler gọi epoll_wait và thấy fd sẵn sàng, nên có một độ trễ nhỏ giữa lúc dữ liệu tới và lúc goroutine chạy lại — không đáng kể với đa số ứng dụng, nhưng hệ thống cần độ trễ cực thấp (như giao dịch tần suất cao) đôi khi phải dùng cơ chế polling riêng để né qua netpoller.
Phần sau ta gặp "người gác đền" đã nhắc nhiều lần: Phần sau mổ xẻ sysmon — thread giám sát nền không gắn P, chịu trách nhiệm gửi tín hiệu preempt, thu hồi P khỏi syscall dài, và kích hoạt GC khi cần.
