Mở top, gõ uptime, hay liếc góc màn hình giám sát, bạn luôn thấy ba con số: load average: 3.54, 1.34, 0.49. Đây có lẽ là chỉ số hệ thống bị hiểu sai nhiều nhất. Rất nhiều người đọc nó như "phần trăm CPU" và hoảng khi thấy số lớn, hoặc yên tâm sai khi thấy số nhỏ. Sự thật tinh tế hơn — và quan trọng hơn — thế. Bài này (phần 10 loạt Debug) chạy thật để trả lời: ba con số đó đo gì, đọc chúng ra sao khi so với số core, và vì sao một máy có load cao ngất vẫn có thể không nghẽn CPU.
Ba con số: không phải %CPU
Điều đầu tiên phải gỡ: load average không phải phần trăm CPU. Nó là số tiến trình trung bình ở một trong hai trạng thái, tính trung bình trượt qua ba cửa sổ thời gian:
R(runnable/running): đang chạy trên CPU, hoặc đã sẵn sàng và đang xếp hàng chờ tới lượt CPU.D(uninterruptible sleep): đang kẹt trong kernel chờ một thao tác không thể ngắt — điển hình là I/O (đọc/ghi đĩa, mạng) chưa xong.
Ba số là trung bình của tổng R + D trong 1 phút, 5 phút, 15 phút gần nhất. Vì là trung bình trượt theo hàm mũ (EMA), con số 1-phút phản ứng nhanh với thay đổi, còn 15-phút mượt và trễ — nên load "leo dần" chứ không nhảy tức thì.
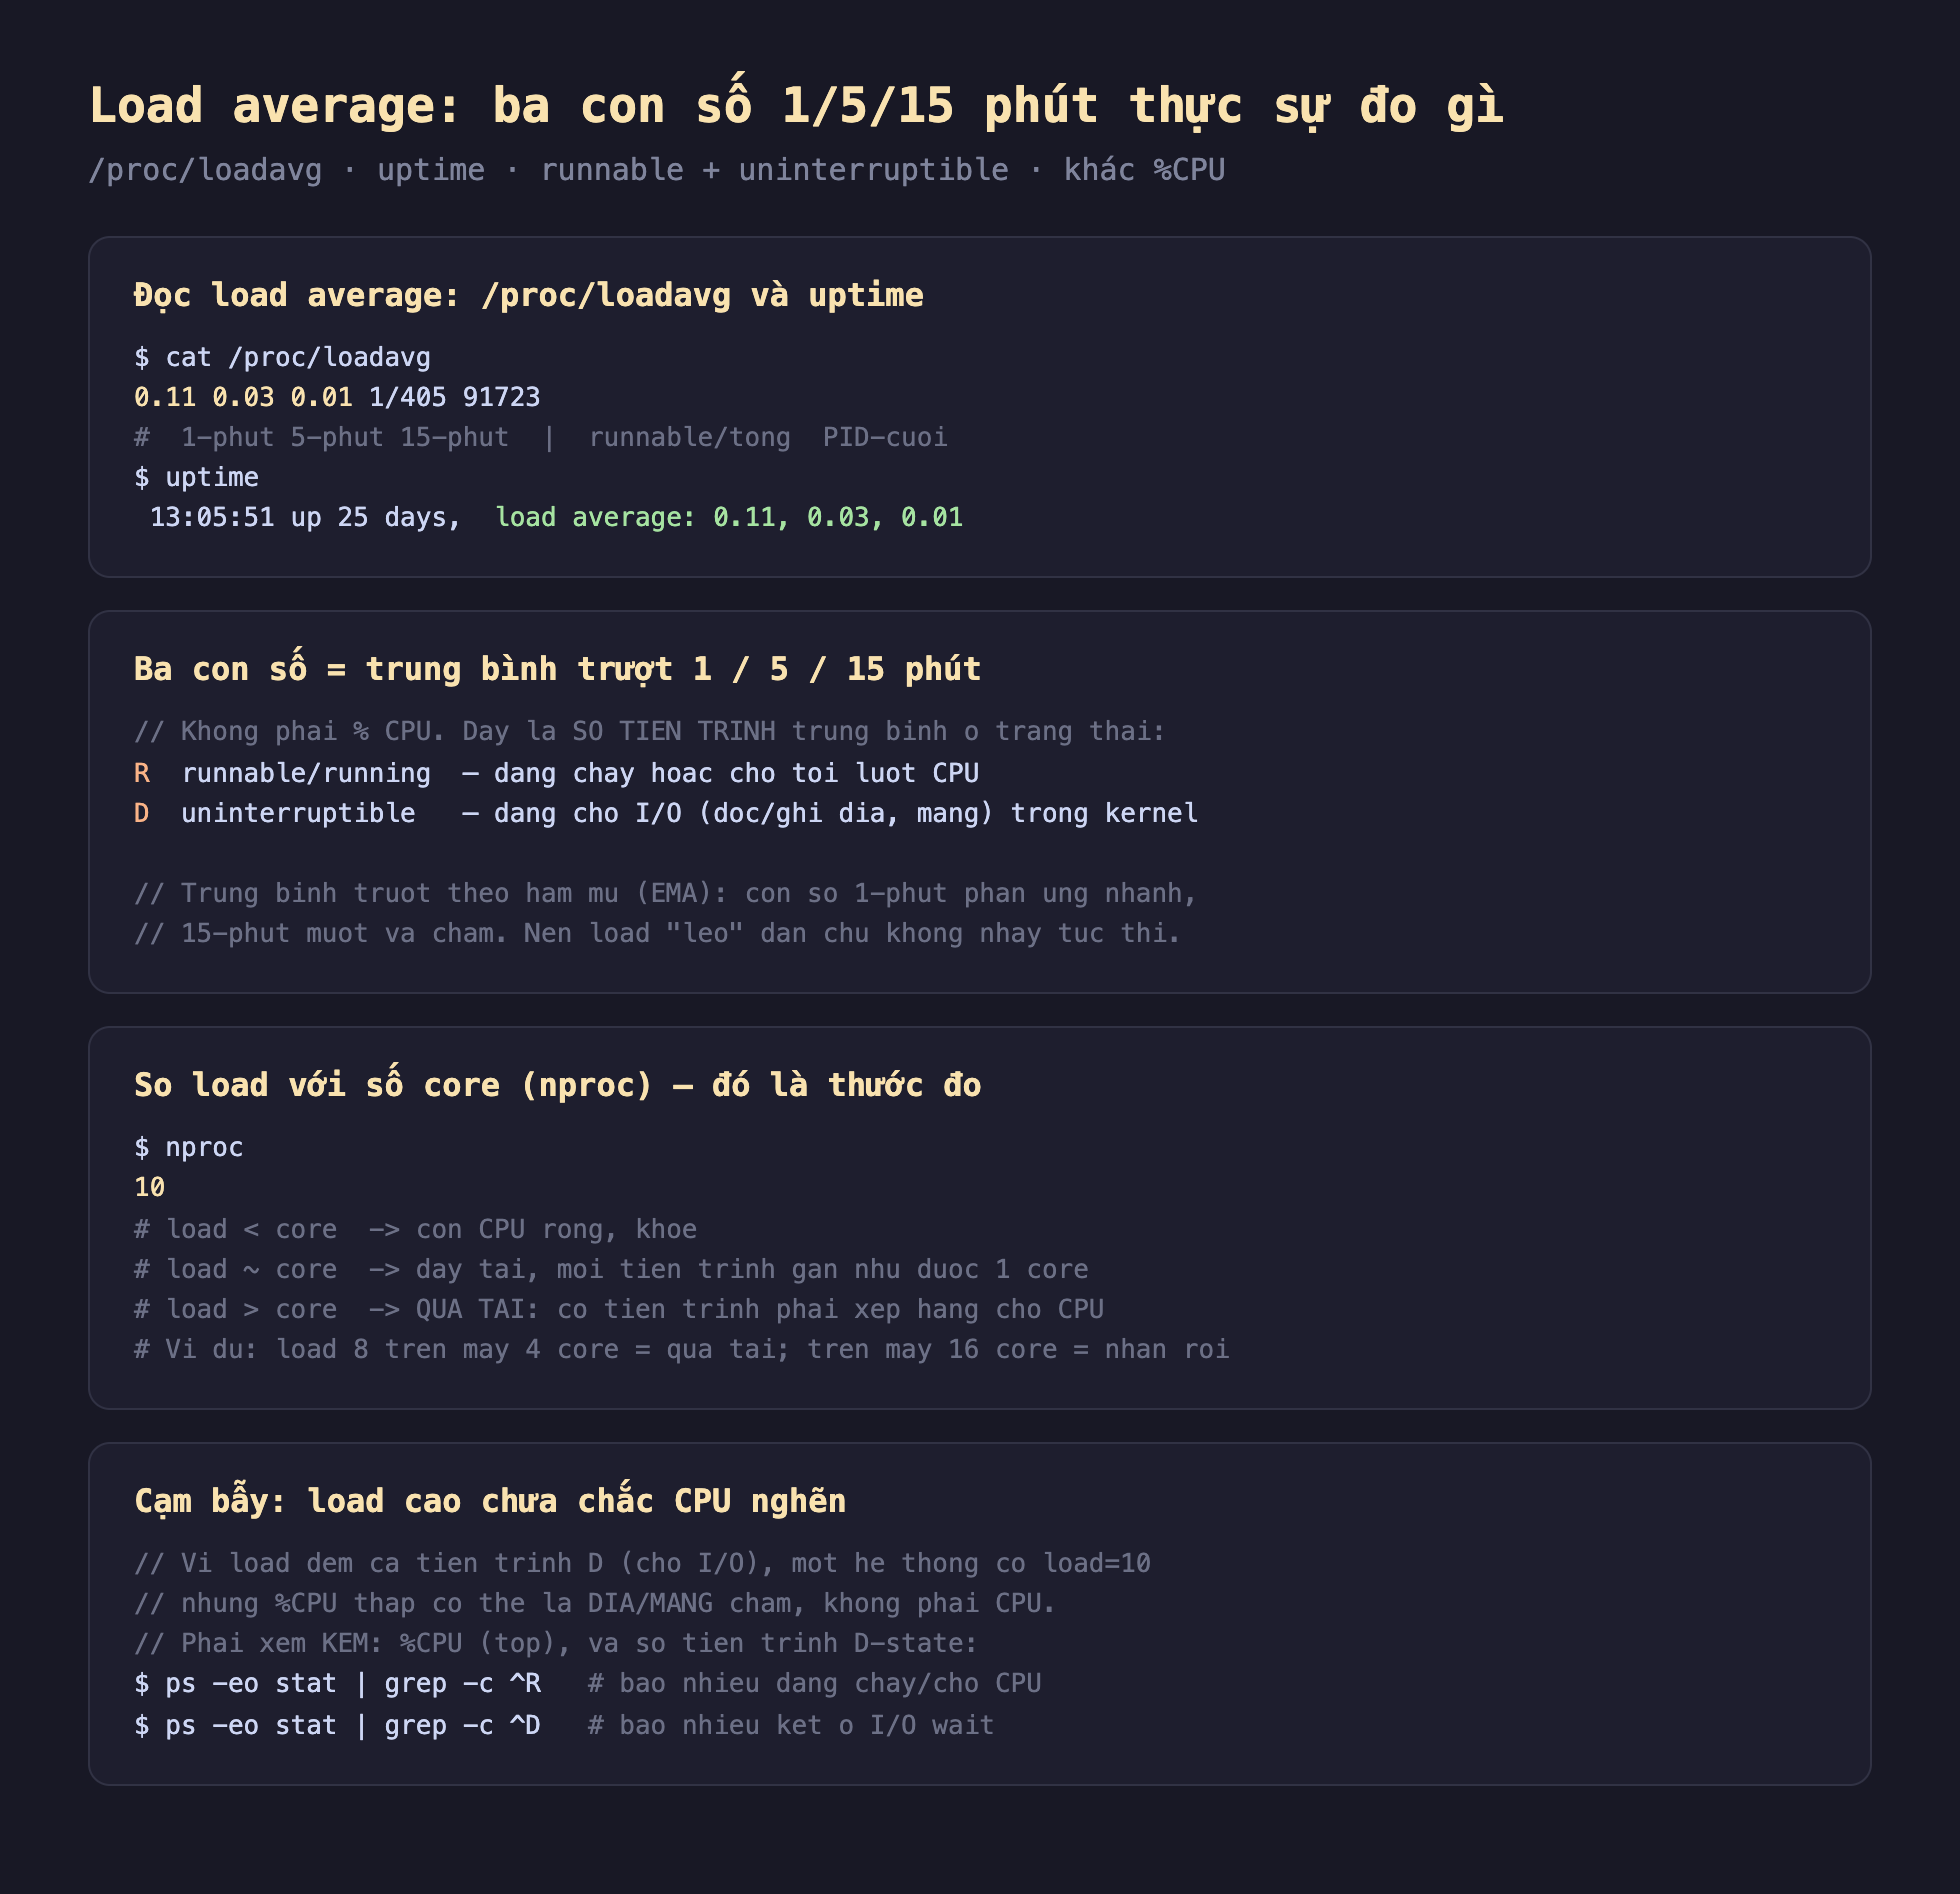
Hình 1: load average là số tiến trình trung bình ở trạng thái R (chạy/chờ CPU) hoặc D (chờ I/O), tính EMA qua ba cửa sổ 1/5/15 phút; thước đo là so với số core (nproc); cạm bẫy là load cao có thể do I/O chứ không phải CPU.
Đo thật: 4 tiến trình CPU-bound, load leo tới ~4
Máy lab có 10 core. Baseline nhàn rỗi cho load average: 0.11, 0.03, 0.01. Mình bật 4 tiến trình CPU-bound (yes > /dev/null, mỗi cái ăn trọn một core) rồi đọc /proc/loadavg mỗi 15 giây:
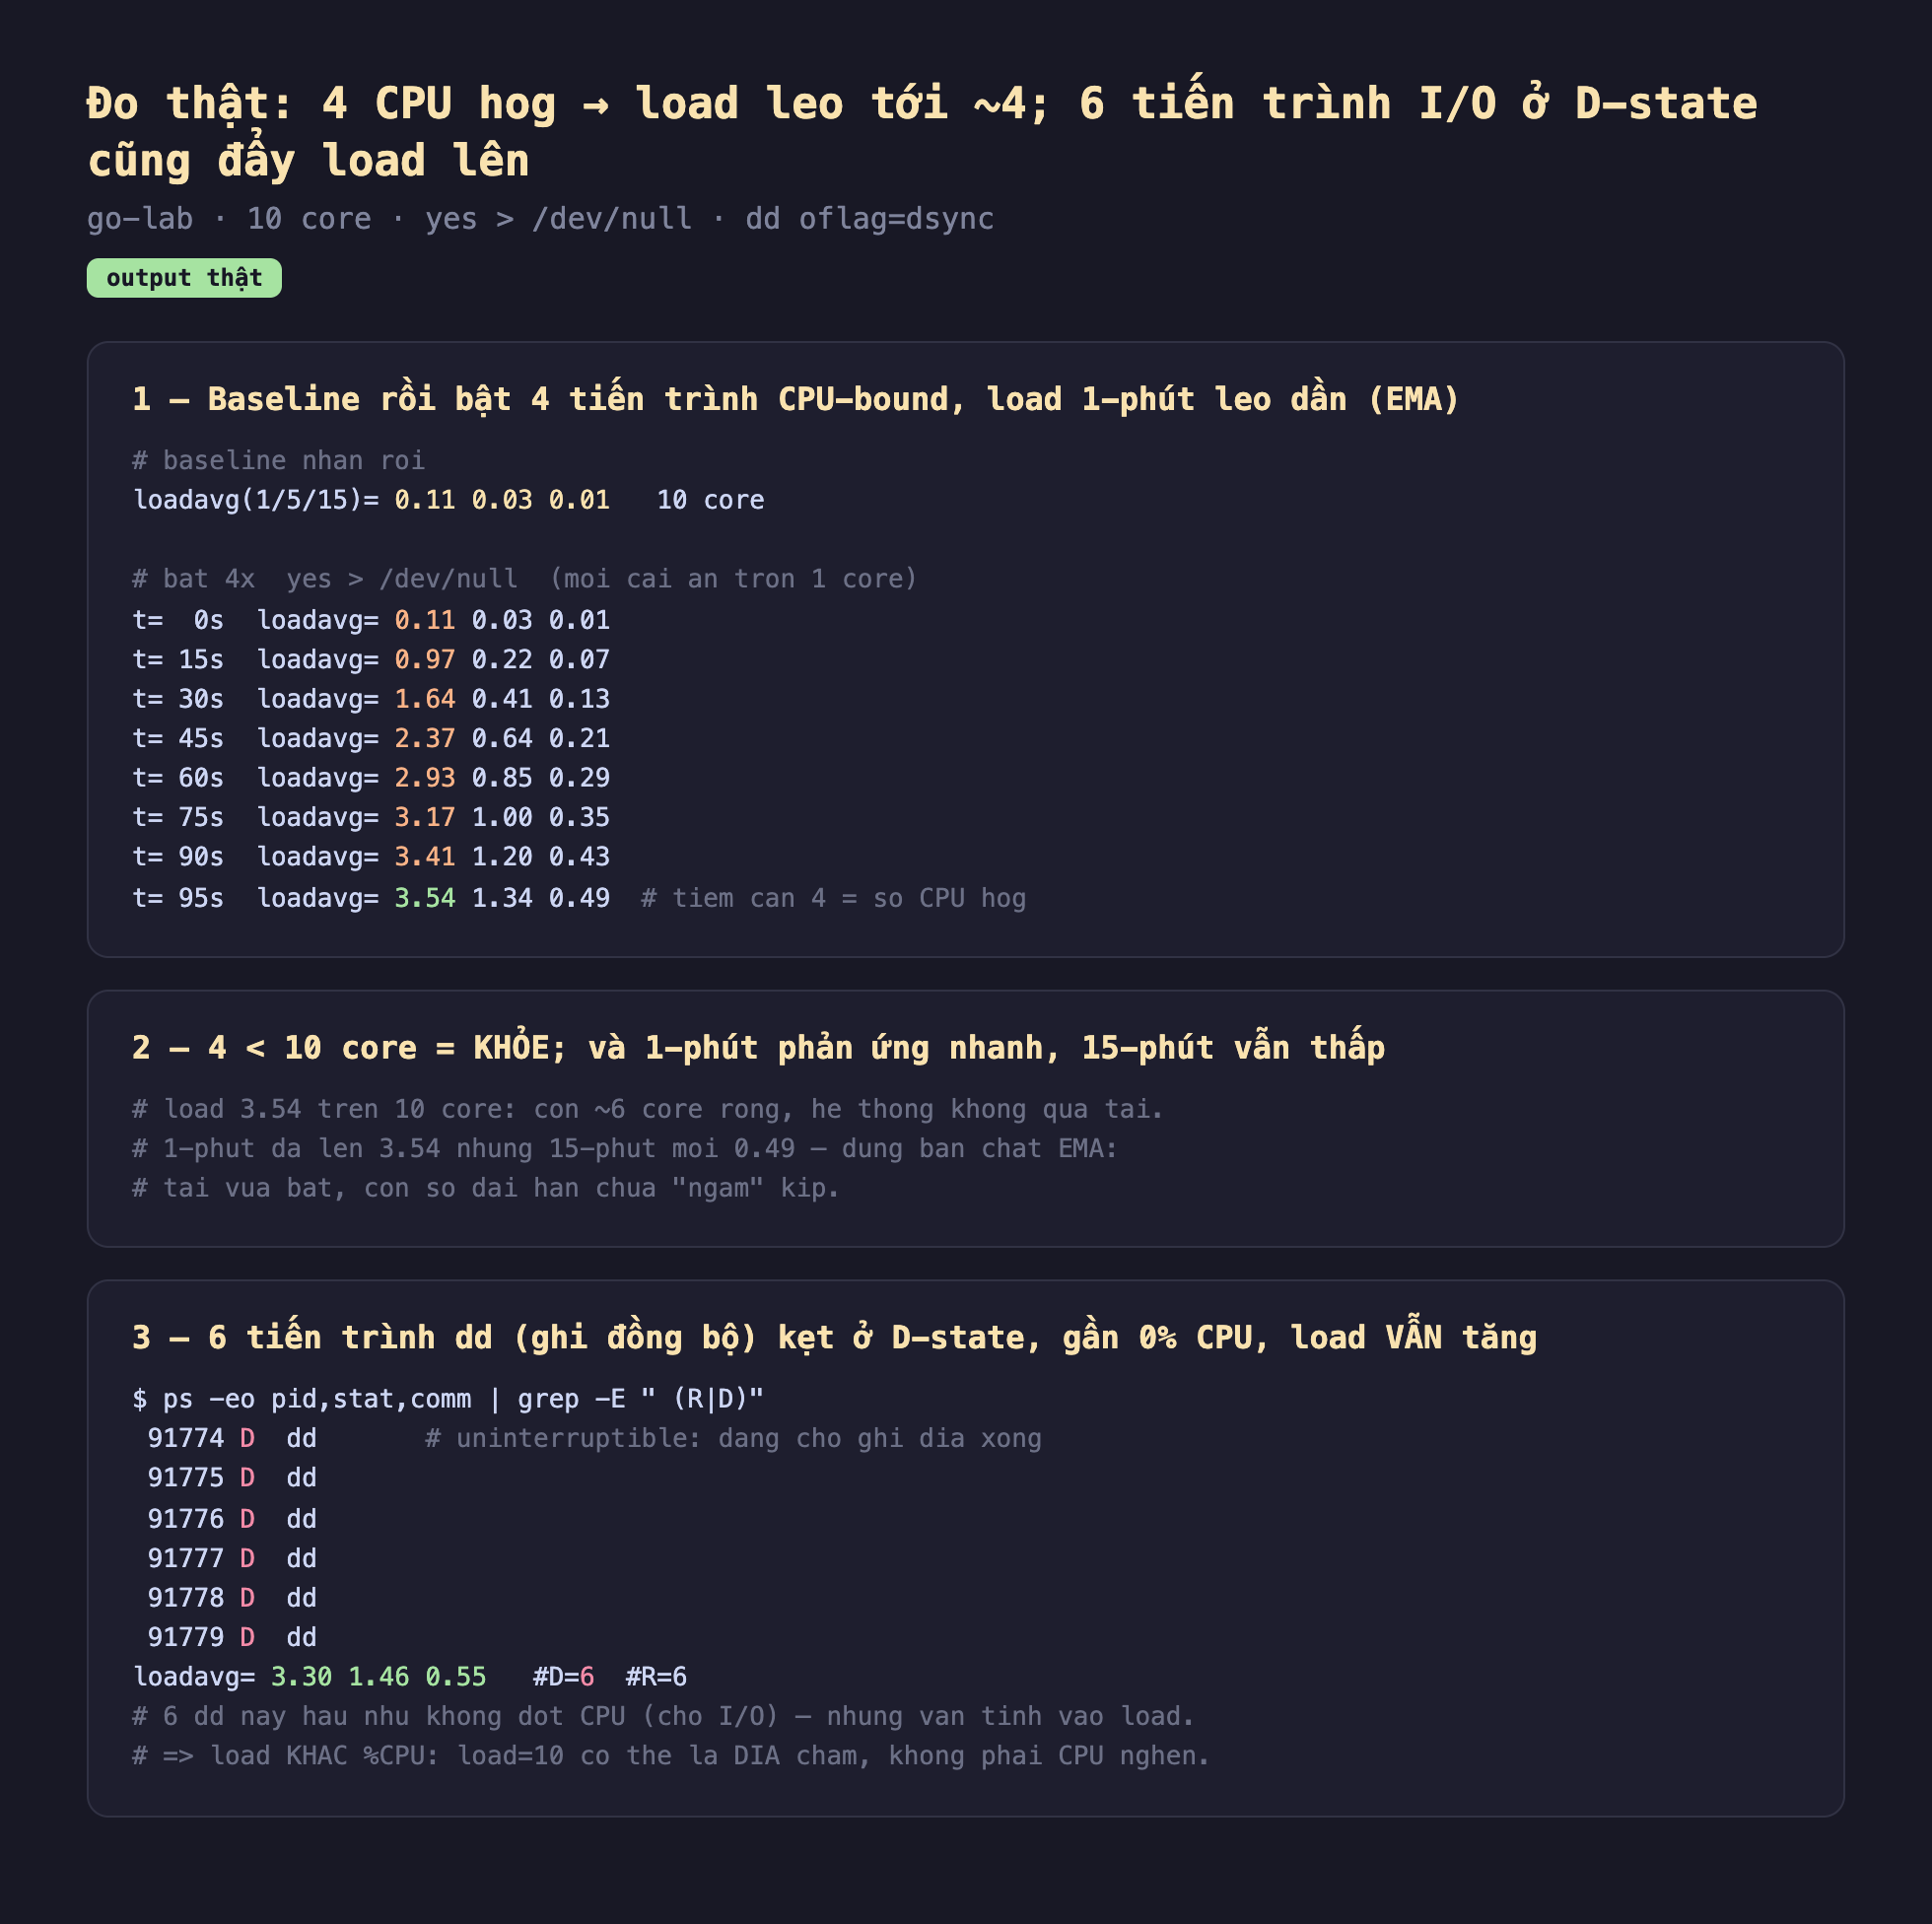
Hình 2: Chạy thật — 4 tiến trình CPU-bound làm load 1-phút leo từ 0.11 qua 0.97 → 1.64 → 2.37 → 2.93 → 3.17 → 3.41 tới 3.54 (tiệm cận 4 = số hog); rồi 6 tiến trình dd ghi đồng bộ kẹt ở D-state (gần 0% CPU) vẫn giữ load ở 3.30, #D=6.
- Load 1-phút leo dần, tiệm cận số tiến trình bận CPU: từ
0.11nó bò lên0.97, 1.64, 2.37, 2.93...rồi3.54sau ~95 giây, đang hướng tới 4 — đúng bằng số tiến trình CPU-bound. Nó leo chứ không nhảy phắt lên 4 vì là trung bình trượt: hằng số thời gian của cửa sổ 1-phút cỡ 60 giây. - 1-phút nhanh, 15-phút chậm: cùng lúc 1-phút đã
3.54thì 15-phút mới0.49. Đây là bản chất EMA — tải vừa mới bật, con số dài hạn chưa "ngấm" kịp. Ngược lại, nếu bạn thấy 15-phút cao thì đó là tải đã kéo dài. - So với số core mới là thước đo:
3.54trên 10 core nghĩa là còn ~6 core rỗng — hệ thống không quá tải, mỗi tiến trình vẫn được một core riêng. Cùng con số3.54đó trên máy 2 core thì đã quá tải nặng (mỗi core gánh gần 2 tiến trình).
Cạm bẫy lớn nhất: load cao ≠ CPU nghẽn
Đây là điều tách người đọc load đúng khỏi người đọc sai. Load đếm cả tiến trình D (chờ I/O), nên một load cao có thể hoàn toàn không phải chuyện CPU. Mình chứng minh: chạy 6 tiến trình dd ghi đồng bộ (oflag=dsync — mỗi lần ghi phải chờ dữ liệu xuống đĩa mới trả về). Kết quả ps cho thấy cả 6 kẹt ở trạng thái D:
$ ps -eo pid,stat,comm | grep -E " (R|D)"
 91774 D  dd     # uninterruptible: đang chờ ghi đĩa xong
 91775 D  dd
 ...            # tổng 6 tiến trình dd ở D-state
loadavg= 3.30 1.46 0.55   #D=6  #R=6
Sáu tiến trình dd này gần như không đốt CPU — chúng ngồi chờ đĩa. Vậy mà chúng vẫn được tính vào load. Nếu bạn chỉ nhìn con số load mà kết luận "CPU đang nghẽn", bạn sai hướng hoàn toàn: thủ phạm ở đây là I/O đĩa, không phải CPU. Đây chính là lý do một database server có thể hiện load average: 20 trong khi top cho thấy CPU chỉ 15% bận — 20 đó phần lớn là các query đang chờ đĩa.
Cách đọc đúng: khi thấy load cao, luôn xem kèm:
%CPU(quatop): nếu CPU cũng cao → đúng là nghẽn CPU.- Số tiến trình
D(ps -eo stat | grep -c ^D): nếu nhiều → nghẽn ở I/O (đĩa/mạng), không phải CPU.
Đánh đổi cần cân nhắc
Trong container, /proc/loadavg là load của host, không phải của riêng container. Load average là con số cấp kernel, mà container chia sẻ kernel với host. Nên load bạn đọc trong một container phản ánh toàn bộ máy chủ, gồm cả tải từ các container khác. Đừng dùng nó để đo tải riêng của service trong container — hãy dùng docker stats (đọc theo cgroup) hoặc số liệu ứng dụng. Con số trong bài này là load của host lab (đang chạy nhiều thứ), nên baseline 0.11 và các mức đo phản ánh cả nền hệ thống, không chỉ tiến trình mình bật.
Load là chỉ số sàng lọc, không phải chẩn đoán cuối. Nó trả lời "hệ thống có bị dồn việc không" chứ không nói "việc gì, ở đâu". Load cao chỉ là tín hiệu để đào tiếp: CPU-bound thì dùng top/ps --sort=-%cpu (bài trước) rồi perf/profiling (bài sau); I/O-bound thì dùng /proc/<pid>/io/iotop. Đừng dừng ở con số load.
"Load bằng số core là ranh giới" chỉ đúng gần đúng. Quy tắc load < core = khỏe là hướng dẫn tốt, nhưng thực tế mượt hơn: một hệ thống I/O-bound có thể chịu load cao hơn số core mà vẫn phản hồi tốt (vì các tiến trình D không tranh CPU), trong khi một hệ CPU-bound đã bắt đầu trễ ngay khi load tiệm cận số core. Dùng số core làm mốc tham chiếu, nhưng luôn soi kèm bản chất tải (CPU hay I/O).
Ba ý mang về
- Load average = số tiến trình trung bình ở trạng thái
RhoặcD, không phải %CPU: đo thật 4 tiến trình CPU-bound làm load 1-phút leo từ0.11tới3.54(tiệm cận 4 = số hog), theo đường EMA — 1-phút nhanh, 15-phút vẫn0.49vì tải mới bật. - So với số core mới ra ý nghĩa:
3.54trên 10 core là khỏe (còn ~6 core rỗng); cùng số đó trên 2 core là quá tải.load < corekhỏe,load > corecó tiến trình phải xếp hàng chờ CPU. - Load cao chưa chắc CPU nghẽn: đo thật 6 tiến trình
ddkẹt ởD-state(chờ đĩa, gần 0% CPU) vẫn đẩy load lên — vì load đếm cả tiến trình chờ I/O. Luôn xem kèm%CPUvà số tiến trìnhDđể biết nghẽn ở CPU hay ở I/O.
Nguồn
- man7.org — proc(5) (
/proc/loadavg): https://man7.org/linux/man-pages/man5/proc.5.html - man7.org — uptime(1): https://man7.org/linux/man-pages/man1/uptime.1.html
- Brendan Gregg — Linux Load Averages: Solving the Mystery: https://www.brendangregg.com/blog/2017-08-08/linux-load-averages.html
Phần sau ta đo một thứ mà con số trung bình luôn giấu đi: latency và percentile — vì sao "trung bình 20ms" có thể che một p99 tệ hại 500ms, và cách đo p50/p95/p99 cho đúng.
