Mười một phần trước của sê-ri này mổ xẻ container Linux từ bên trong, mỗi phần một cơ chế và mỗi kết luận một phép đo thật: namespace cô lập tiến trình và mạng, cgroups giới hạn CPU, bộ nhớ, I/O và số tiến trình, OverlayFS xếp lớp image, capabilities và seccomp siết quyền, file descriptor và RLIMIT chặn rò rỉ, PID 1 xử lý tín hiệu và thu dọn zombie, rồi bộ nhớ với sự khác biệt giữa RSS và page cache. Bài cuối này không đo một cơ chế mới mà làm một việc khác: gom tất cả thành một checklist cấu hình thực chiến, rồi kiểm chứng nó bằng cách áp hết lên một container và đọc lại từng nút điều chỉnh để chắc chắn mọi cờ đều có tác dụng. Mục tiêu là biến hiểu biết về cơ chế thành những quyết định cụ thể bạn áp dụng được ngay cho Dockerfile và lệnh chạy của mình.
Checklist: từ mỗi phép đo thành một quyết định cấu hình
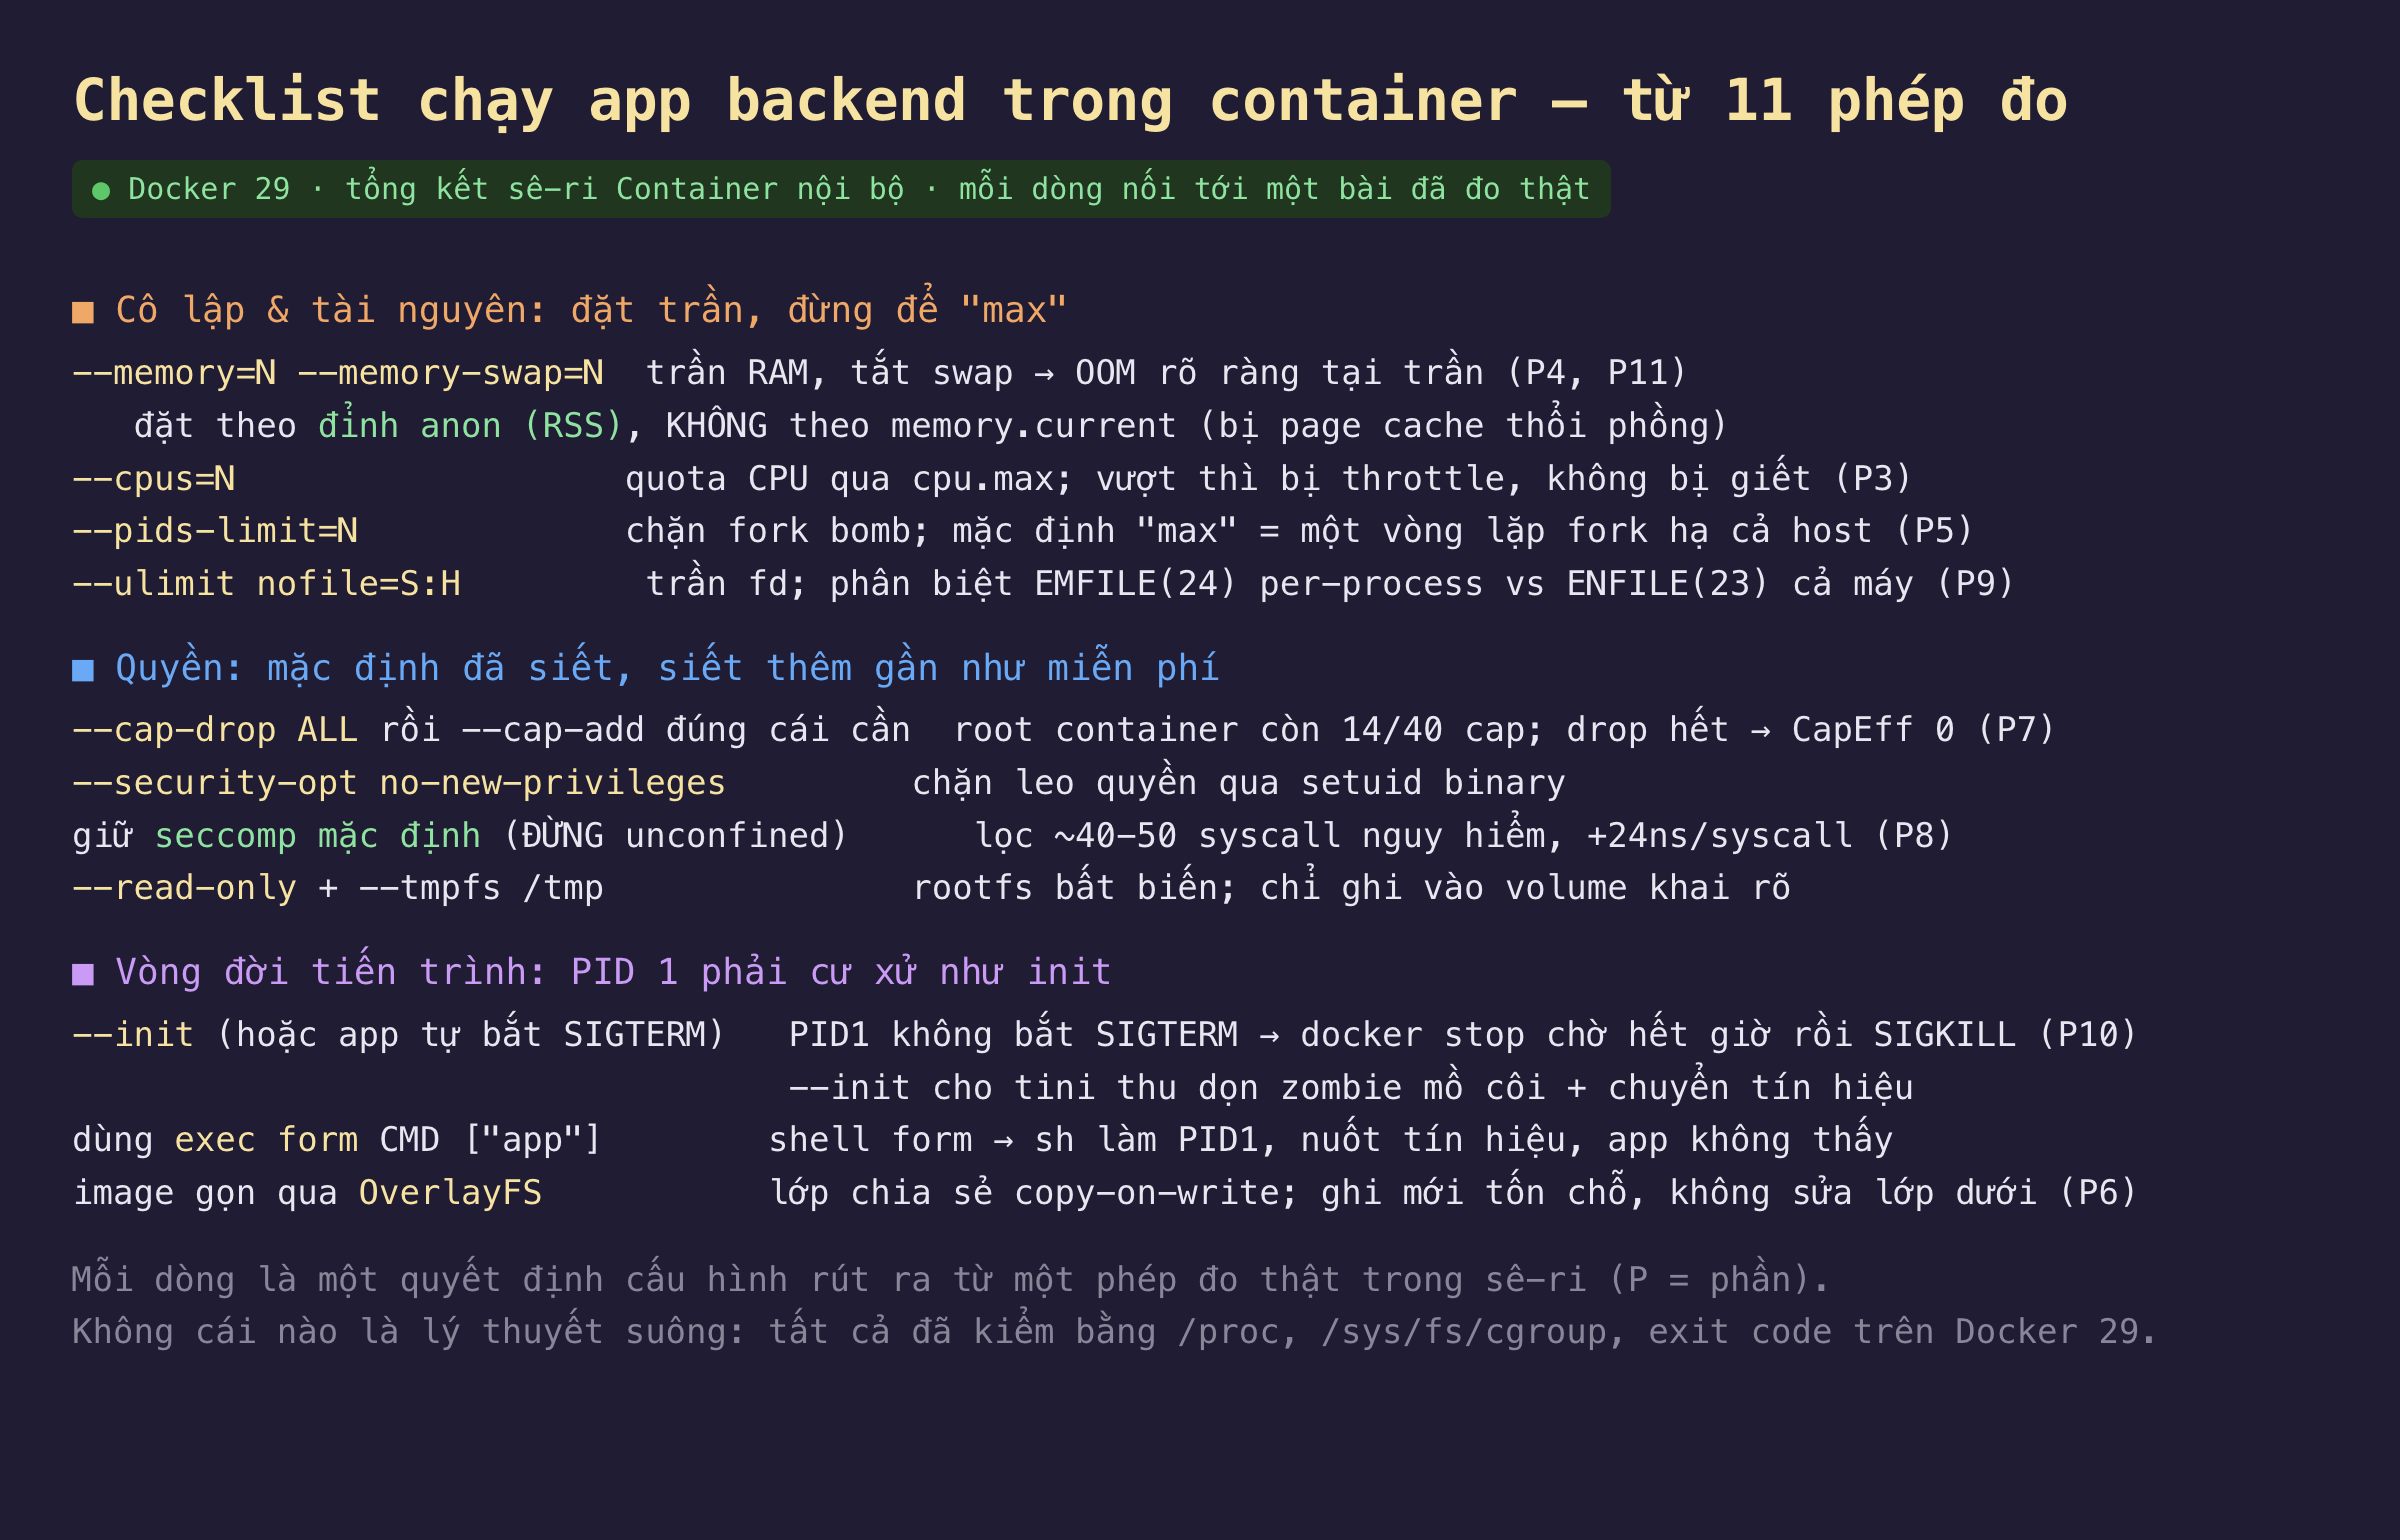
Hình 1: Checklist ba nhóm — cô lập và tài nguyên, quyền, vòng đời tiến trình — mỗi dòng rút ra từ một phép đo trong sê-ri.
Checklist chia thành ba nhóm theo đúng mạch của sê-ri. Nhóm thứ nhất là cô lập và tài nguyên, nguyên tắc chung là đặt trần, đừng để "max". Đặt --memory=N cùng --memory-swap=N để có trần RAM và tắt swap, cho OOM xảy ra rõ ràng tại trần như phần 4 và 11 đo; và nhớ bài học phần 11, đặt giới hạn theo đỉnh anon (RSS) chứ không theo memory.current, vì con số đó bị page cache thổi phồng. Đặt --cpus=N để giới hạn CPU qua cpu.max; phần 3 cho thấy vượt trần CPU chỉ bị throttle chậm lại, không bị giết. Đặt --pids-limit=N để chặn fork bomb; phần 5 cho thấy mặc định "max" nghĩa là một vòng lặp fork có thể hạ cả host. Và đặt --ulimit nofile=S:H cho trần file descriptor, với lưu ý phần 9 rằng EMFILE (errno 24) là trần per-process còn ENFILE (errno 23) là trần cả máy, hai lỗi cần sửa ở hai nơi khác nhau.
Nhóm thứ hai là quyền, nơi tin tốt là mặc định đã siết sẵn một phần, siết thêm gần như miễn phí. Dùng --cap-drop ALL rồi --cap-add đúng những capability cần: phần 7 đo root trong container mặc định chỉ có 14 trong hơn 40 capability, và drop hết đưa CapEff về 0. Thêm --security-opt no-new-privileges để chặn leo quyền qua các binary setuid. Giữ nguyên seccomp mặc định và đừng chạy unconfined: phần 8 đo profile mặc định lọc khoảng 40 đến 50 syscall nguy hiểm với chi phí chỉ 24 nano giây mỗi syscall. Và thêm --read-only cùng --tmpfs /tmp để rootfs bất biến, chỉ cho ghi vào những volume khai báo rõ, thu hẹp thiệt hại nếu ứng dụng bị chiếm.
Nhóm thứ ba là vòng đời tiến trình, với nguyên tắc PID 1 phải cư xử như init. Dùng --init, hoặc để ứng dụng tự bắt SIGTERM: phần 10 đo rằng PID 1 không bắt SIGTERM khiến docker stop chờ hết timeout rồi SIGKILL, còn --init cho tini thu dọn zombie mồ côi và chuyển tiếp tín hiệu. Viết CMD dạng exec ["app"] thay vì dạng shell, vì dạng shell khiến sh làm PID 1, nuốt tín hiệu và ứng dụng không bao giờ thấy. Và giữ image gọn nhờ hiểu OverlayFS từ phần 6: các lớp chia sẻ theo cơ chế copy-on-write, ghi mới tốn chỗ riêng nhưng không sửa lớp dưới. Mỗi dòng trong checklist là một quyết định rút ra từ một phép đo thật, không phải lý thuyết suông, tất cả đã kiểm bằng /proc, /sys/fs/cgroup và exit code trên Docker 29.
Áp hết checklist rồi đọc lại từng knob
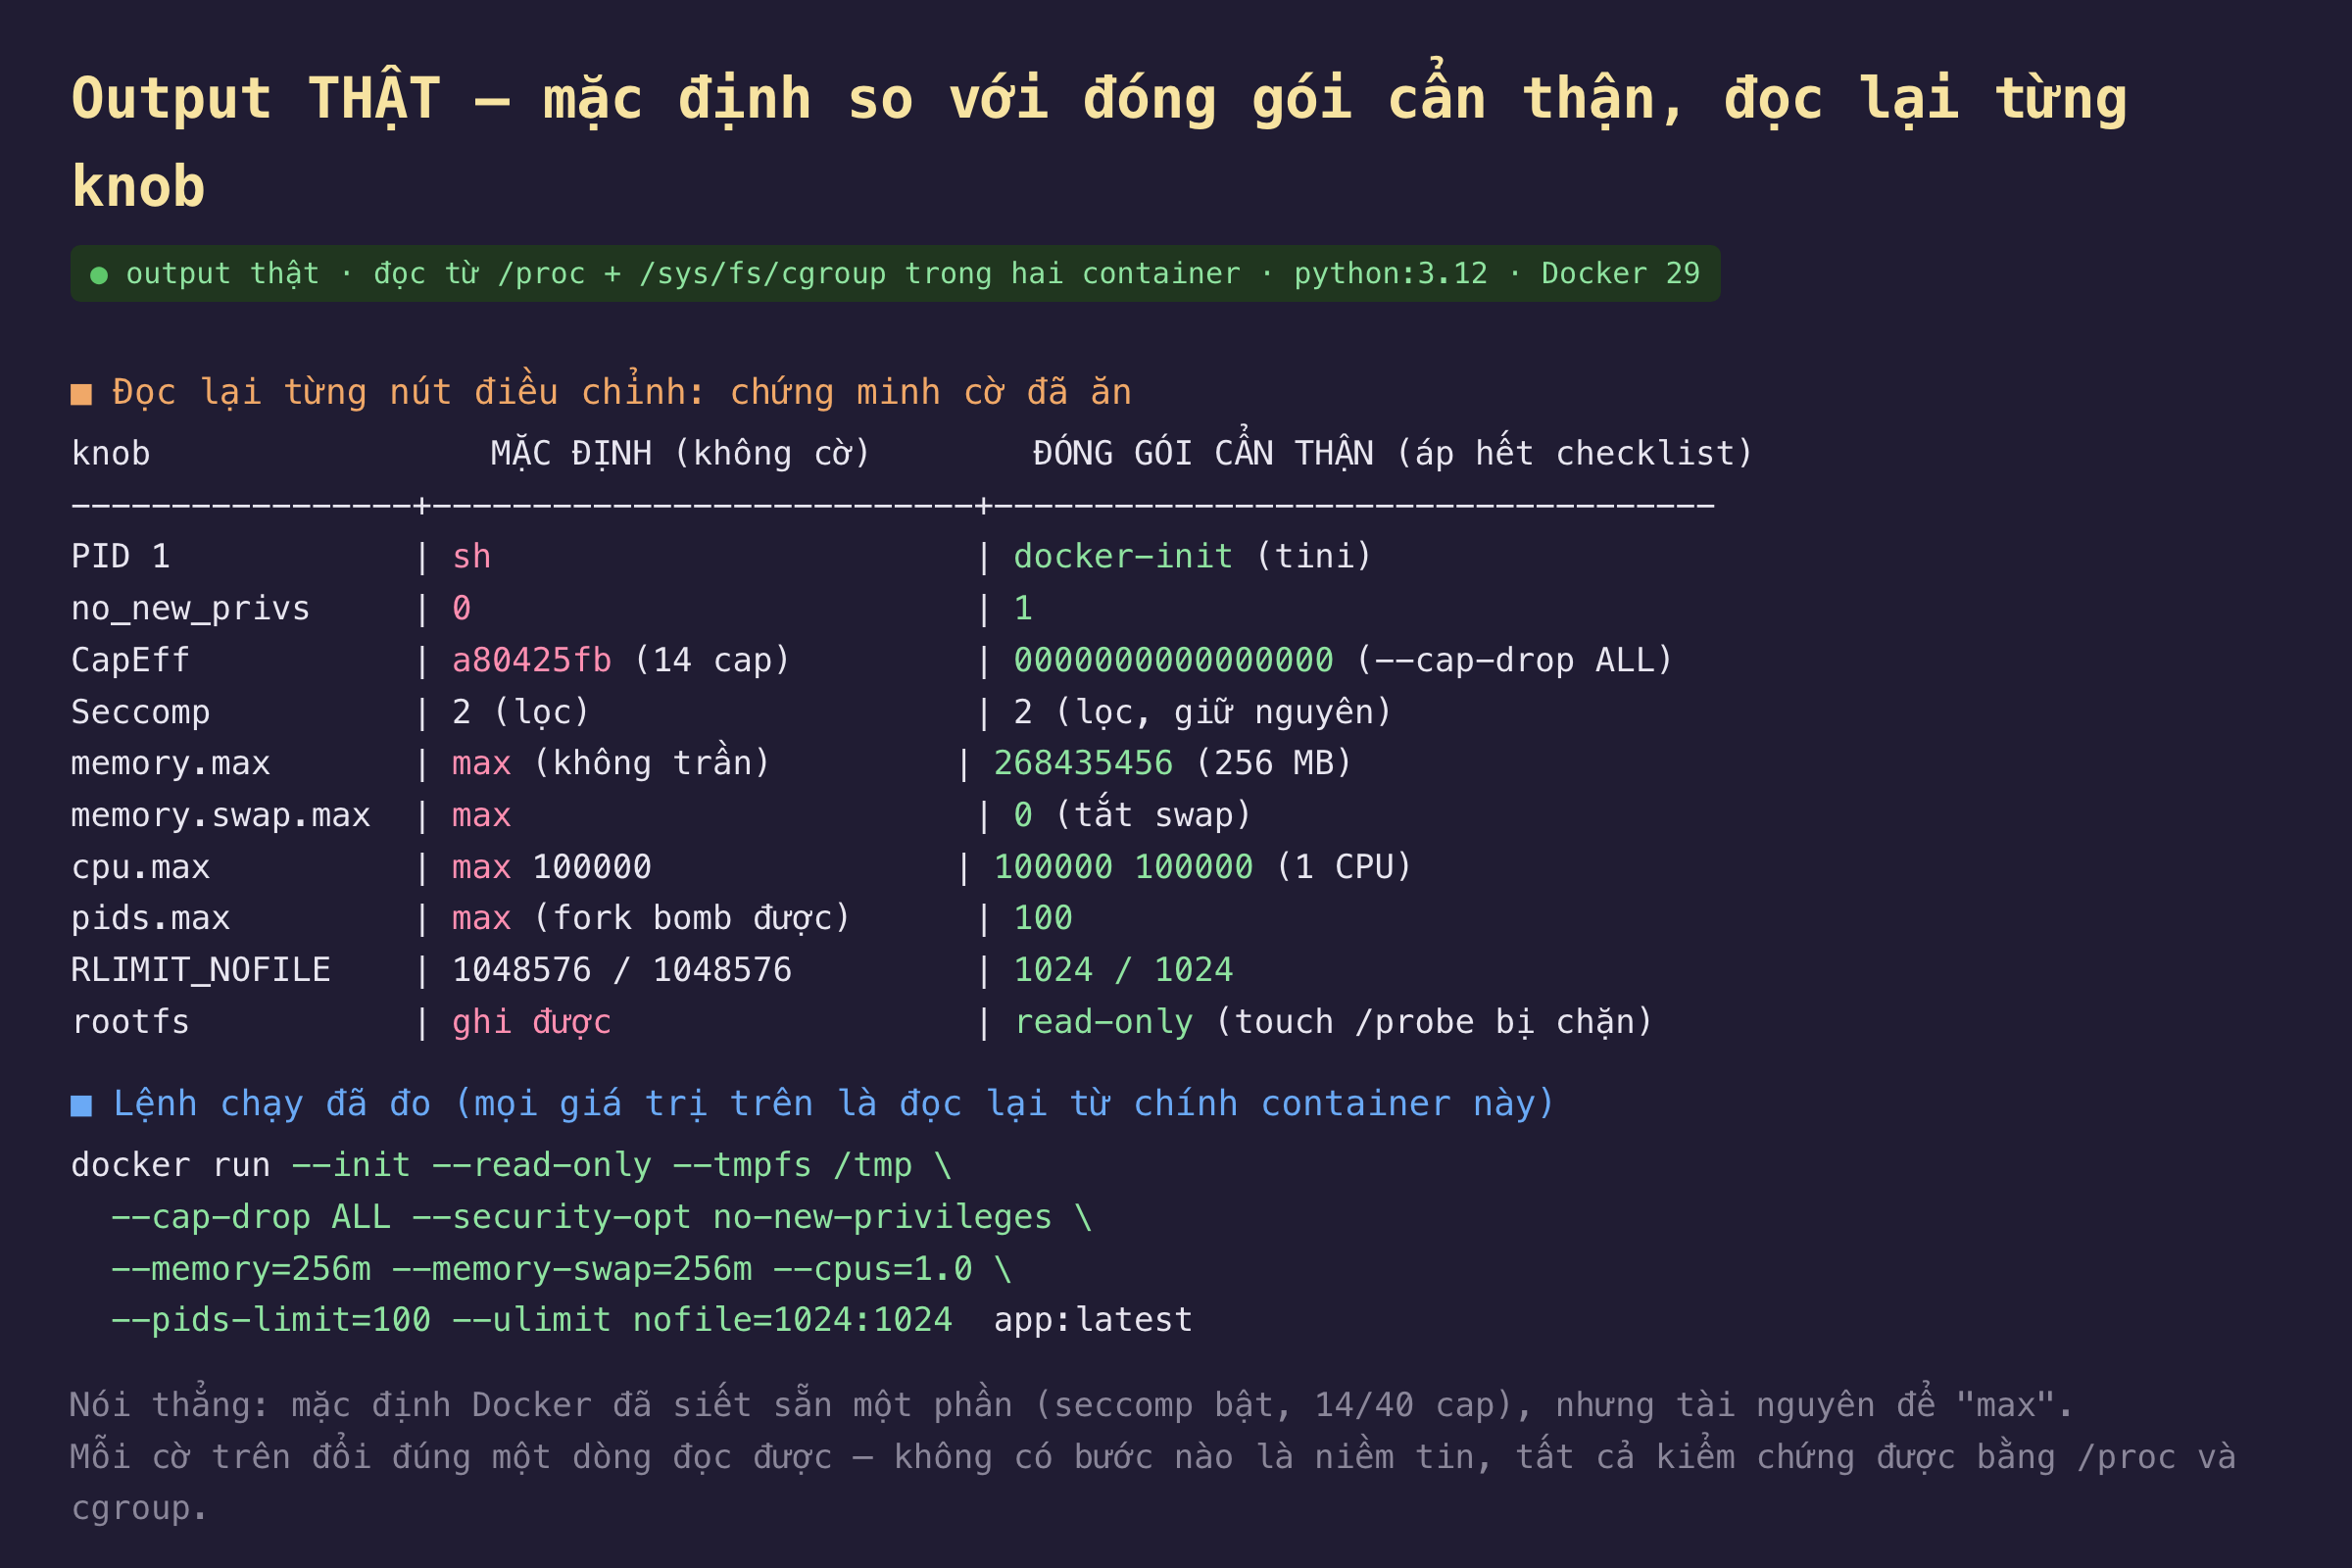
Hình 2: Áp hết checklist lên một container rồi đọc lại từng knob từ /proc và cgroup, so với container mặc định.
| knob | mặc định | đóng gói cẩn thận |
|---|---|---|
| PID 1 | sh |
docker-init (tini) |
| no_new_privs | 0 | 1 |
| CapEff | a80425fb (14 cap) | 0000000000000000 |
| Seccomp | 2 (lọc) | 2 (lọc, giữ nguyên) |
| memory.max | max | 268435456 (256 MB) |
| memory.swap.max | max | 0 (tắt swap) |
| cpu.max | max 100000 | 100000 100000 (1 CPU) |
| pids.max | max | 100 |
| RLIMIT_NOFILE | 1048576 / 1048576 | 1024 / 1024 |
| rootfs | ghi được | read-only |
Mọi cờ trong checklist đổi đúng một dòng đọc được, không có bước nào là niềm tin. Thí nghiệm cuối chạy hai container cùng image python:3.12: một không cờ gì, một áp hết checklist, rồi đọc cùng một bộ nút điều chỉnh từ /proc và /sys/fs/cgroup của chính chúng. Kết quả xác nhận từng cờ có tác dụng thật. --init đổi PID 1 từ sh thành docker-init, tức tini. --security-opt no-new-privileges bật NoNewPrivs từ 0 lên 1. --cap-drop ALL đưa CapEff từ a80425fb, tức 14 capability, về 0000000000000000, không còn quyền đặc biệt nào. --memory=256m đặt memory.max thành 268435456 byte, và --memory-swap=256m đưa memory.swap.max về 0, tắt swap. --cpus=1.0 đặt cpu.max thành 100000 100000, đúng một CPU. --pids-limit=100 đặt pids.max thành 100. --ulimit nofile=1024:1024 hạ RLIMIT_NOFILE từ hơn một triệu xuống 1024. Và --read-only khiến touch /probe bị chặn với "Read-only file system".
Mặc định Docker đã siết sẵn một phần, nhưng để tài nguyên là "max". So sánh hai cột làm rõ điểm xuất phát. Về quyền, mặc định không phải là trống trơn: seccomp đã bật và lọc, và root chỉ có 14 trong hơn 40 capability, như phần 7 và 8 đã đo. Đây là lớp bảo vệ Docker cho sẵn mà nhiều người không biết mình đang có. Nhưng về tài nguyên, mặc định để tất cả ở "max": không trần bộ nhớ, không trần CPU, không trần số tiến trình, và RLIMIT_NOFILE rất cao. Nghĩa là một container mặc định có thể dùng hết RAM của host, chạy fork bomb, hoặc ngốn trọn CPU, không có gì chặn. Checklist này lấp đúng khoảng trống đó: giữ những lớp bảo vệ mặc định, thêm các trần tài nguyên và siết quyền tới mức tối thiểu cần thiết. Và vì mọi giá trị đều đọc lại được từ /proc và cgroup, không có bước nào phải tin suông, tất cả kiểm chứng được.
Những điều cần nhớ khi áp dụng
Áp checklist theo mức rủi ro, không máy móc toàn bộ. Không phải container nào cũng cần cả mười cờ. Trần tài nguyên, --memory, --cpus, --pids-limit, nên có cho gần như mọi dịch vụ chạy production, vì chúng ngăn một container kéo sập cả host. Siết quyền, --cap-drop ALL và no-new-privileges, đáng làm cho dịch vụ tiếp xúc mạng hoặc xử lý dữ liệu không tin cậy. --read-only mạnh về bảo mật nhưng đòi ứng dụng không ghi vào rootfs, nên cần kiểm trước xem app có cần thư mục ghi tạm nào ngoài /tmp không. Điểm chung là hiểu từng cờ chặn gì để quyết định có cần, chứ không bật tất cả một cách máy móc rồi gỡ dần khi có cái gãy.
Dùng Compose hoặc Kubernetes để cấu hình này thành khai báo, không gõ tay mỗi lần. Một lệnh docker run dài mười cờ khó nhớ và dễ sót khi gõ tay. Trong thực tế, các giá trị này thuộc về file khai báo: docker-compose.yml có mem_limit, cpus, pids_limit, cap_drop, read_only, init, security_opt; Kubernetes có resources.limits, securityContext với capabilities, readOnlyRootFilesystem, allowPrivilegeEscalation, và runAsNonRoot. Chuyển checklist thành khai báo giúp cấu hình được rà soát, lưu phiên bản, và áp đồng nhất cho mọi lần triển khai, thay vì phụ thuộc vào trí nhớ của người gõ lệnh.
Chạy app dưới user không phải root nếu được, lớp phòng thủ cuối. Sê-ri tập trung vào các cơ chế kernel, nhưng một bước đơn giản bổ sung cho tất cả là không chạy ứng dụng dưới uid 0 ngay từ đầu. Thêm USER trong Dockerfile để tiến trình chạy dưới user thường kết hợp tốt với mọi cờ trong checklist: ngay cả khi một capability lọt qua hay một cấu hình bị sai, một tiến trình không phải root đã bị giới hạn sẵn. Phần 7 nhắc rằng user namespace là lớp bổ sung cho capability; chạy non-root là cách rẻ nhất tiến gần nguyên tắc đó mà không cần bật user namespace. Đây là mảnh ghép cuối của một container đóng gói cẩn thận.
Ba ý mang về từ cả sê-ri
- Container là tiến trình Linux thường, bị bao bởi namespace và cgroup. Mọi "phép màu" của container đều đọc được ở
/procvà/sys/fs/cgroup: namespace quyết định thấy gì, cgroup quyết định dùng được bao nhiêu, và tất cả kiểm chứng được bằng số. - Mặc định Docker siết quyền nhưng buông tài nguyên. Seccomp bật và 14/40 capability là có sẵn; nhưng bộ nhớ, CPU, pids, fd đều để "max". Checklist lấp khoảng trống đó bằng những trần cụ thể đo được.
- Đóng gói cẩn thận là mười cờ, mỗi cờ đổi đúng một thứ đọc được.
--init,--cap-drop ALL,no-new-privileges,--read-only, cùng trần bộ nhớ, CPU, pids và fd. Không bước nào là niềm tin; tất cả chứng minh được bằng/procvà cgroup.
Nguồn
- Docker — Security, tổng quan các cơ chế bảo vệ container: https://docs.docker.com/engine/security/
- Docker — Runtime options with Memory, CPUs, and GPUs (
--memory,--cpus,--pids-limit): https://docs.docker.com/engine/containers/resource_constraints/ - Docker — Runtime privilege and Linux capabilities (
--cap-drop,--security-opt,--read-only): https://docs.docker.com/engine/containers/run/#runtime-privilege-and-linux-capabilities - Linux — Control Group v2, tài liệu chính thức về cgroup: https://docs.kernel.org/admin-guide/cgroup-v2.html
- Kubernetes — Configure a Security Context for a Pod or Container: https://kubernetes.io/docs/tasks/configure-pod-container/security-context/
- OWASP — Docker Security Cheat Sheet, checklist bảo mật container: https://cheatsheetseries.owasp.org/cheatsheets/Docker_Security_Cheat_Sheet.html
Sê-ri Container nội bộ dừng ở đây. Mười hai phần đã đi từ namespace và cgroup tới một lệnh docker run đóng gói cẩn thận, mỗi bước kiểm bằng phép đo thật trên Docker 29. Hy vọng bạn rời sê-ri với một mô hình tinh thần rõ ràng: container không phải máy ảo thu nhỏ hay hộp đen, mà là tiến trình Linux thường được kernel bao bởi những ranh giới bạn đọc được, đo được, và chỉnh được.
