Phần 7 kết lại với một gợi ý: capability siết quyền của root trong container, nhưng còn một lớp bảo vệ khác nằm thấp hơn, chặn syscall ngay cả khi tiến trình có đủ quyền. Lớp đó là seccomp. Đây là một phân biệt tinh tế nhưng quan trọng: capability trả lời câu hỏi "tiến trình này có được phép làm việc X không", còn seccomp trả lời câu hỏi "syscall này có được phép gọi không", và hai câu hỏi được trả lời ở hai nơi khác nhau trong kernel. Bài này đo chính xác ranh giới đó: xem profile seccomp mặc định của Docker đang lọc, chứng minh một syscall bị seccomp chặn trả về cùng mã lỗi EPERM như khi thiếu quyền nhưng vì lý do hoàn toàn khác, và đo chi phí thời gian của việc lọc từng syscall.
Seccomp chặn syscall, trước cả khi kiểm capability
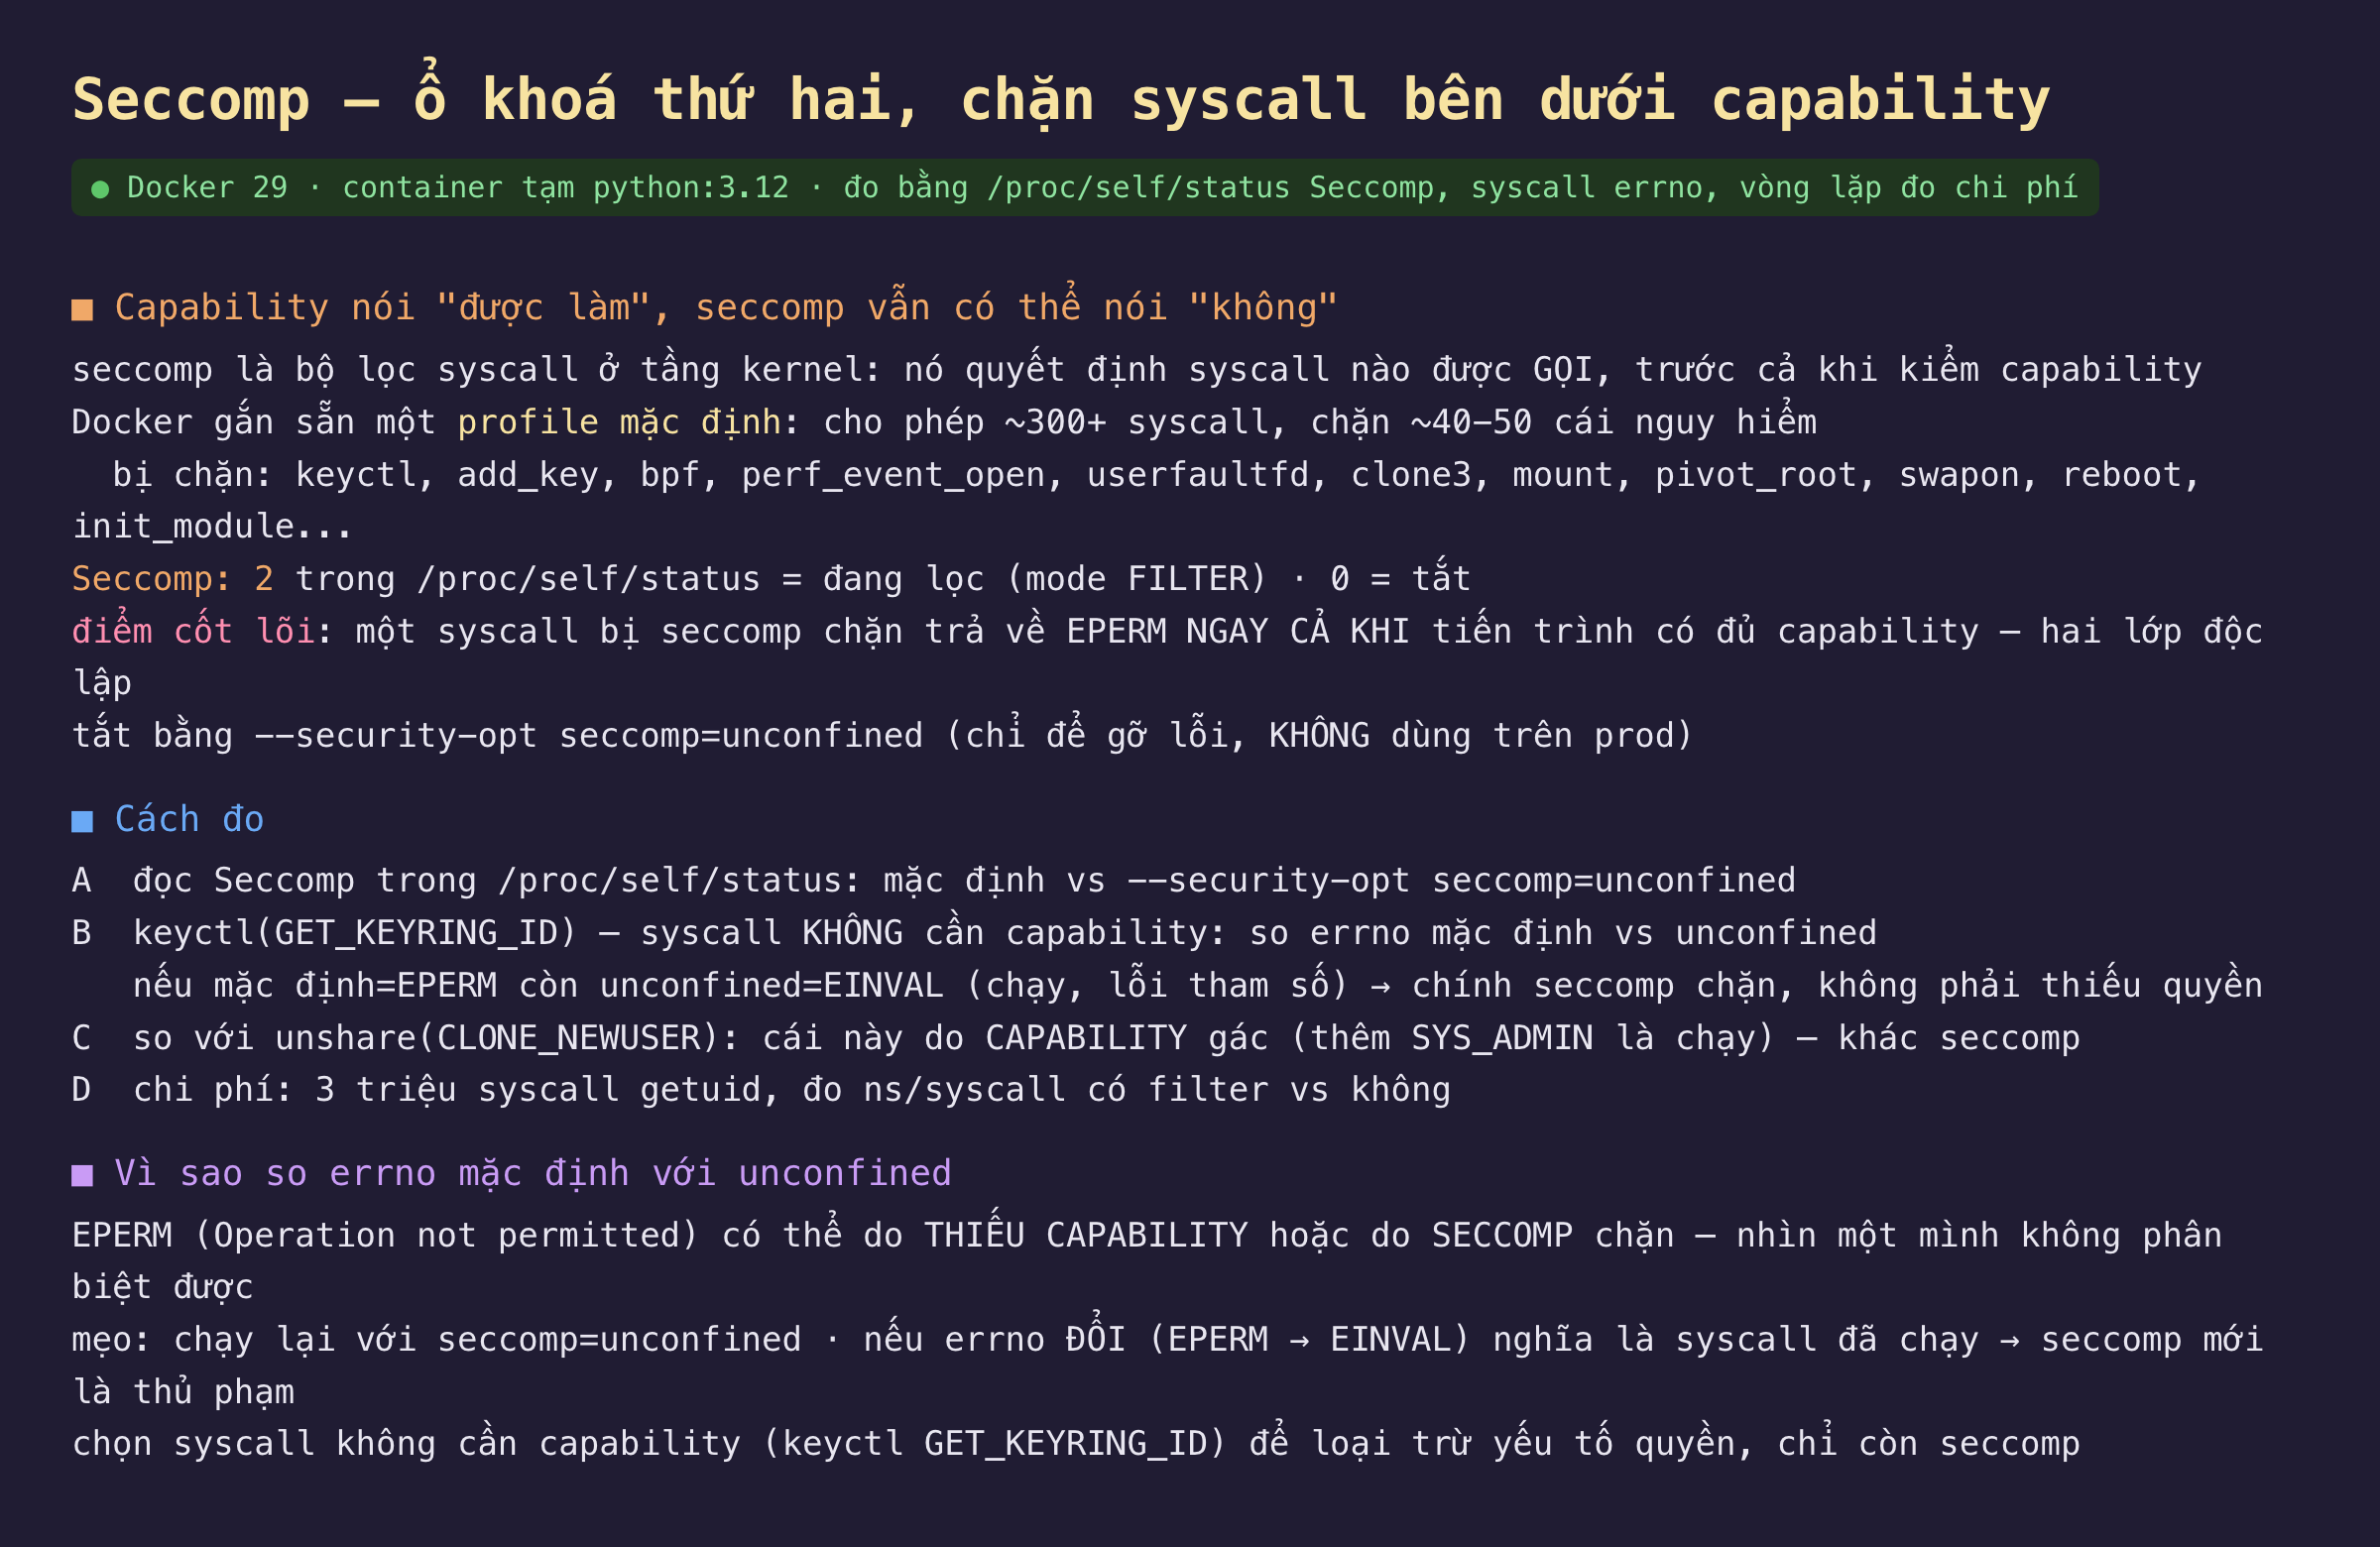
Hình 1: Seccomp là bộ lọc syscall ở tầng kernel, độc lập với capability, và cách đo bằng Seccomp trong /proc/self/status cùng errno.
Capability, như phần trước đo, kiểm soát việc một tiến trình có được phép thực hiện một thao tác đặc quyền hay không, ví dụ đổi giờ hệ thống hay cấu hình mạng. Nhưng kiểm tra đó xảy ra bên trong từng syscall, sau khi syscall đã được gọi. Seccomp đứng trước cả bước đó: nó là một bộ lọc ở tầng kernel quyết định syscall nào thậm chí được phép gọi, dựa trên số hiệu syscall và đôi khi cả giá trị tham số. Nếu một syscall không qua được bộ lọc, kernel từ chối nó ngay, không đi tới phần kiểm capability bên trong. Đây là lý do seccomp được gọi là lớp phòng thủ thứ hai: ngay cả khi capability cho phép, seccomp vẫn có thể nói không.
Docker gắn sẵn một profile seccomp mặc định cho mọi container, cho phép khoảng hơn 300 syscall mà một ứng dụng bình thường cần, và chặn khoảng 40 tới 50 syscall nguy hiểm. Danh sách bị chặn gồm những tên đáng chú ý: keyctl và add_key cho thao tác với keyring của kernel, bpf cho nạp chương trình BPF, perf_event_open cho profiling cấp hệ thống, userfaultfd từng là công cụ khai thác lỗi dùng chung bộ nhớ, clone3, mount, pivot_root, swapon, reboot, init_module cho nạp kernel module. Nhiều cái trong số này cũng cần capability, nhưng việc chặn chúng ở tầng seccomp là một lớp khóa độc lập: dù ai đó lỡ --cap-add quá tay, seccomp vẫn giữ cửa. Trạng thái seccomp đọc được ở trường Seccomp trong /proc/self/status: giá trị 2 nghĩa là mode FILTER đang lọc, 0 nghĩa là tắt. Tắt được bằng cờ --security-opt seccomp=unconfined, nhưng đó chỉ là công cụ gỡ lỗi, không bao giờ dùng trên production.
Thách thức khi đo là EPERM, mã lỗi "Operation not permitted", có thể đến từ hai nguồn: thiếu capability, hoặc seccomp chặn. Nhìn một mình không phân biệt được. Mẹo ở đây là chọn một syscall không đòi capability nào rồi so sánh mã lỗi giữa hai lần chạy. Bài này dùng keyctl với lệnh con GET_KEYRING_ID, một thao tác tra cứu keyring không cần đặc quyền. Nếu chạy mặc định cho EPERM nhưng chạy với seccomp=unconfined cho EINVAL, mã lỗi "Invalid argument", thì khác biệt nói lên tất cả: dưới unconfined syscall đã thực sự chạy và chỉ phàn nàn về tham số, nghĩa là mặc định chính seccomp đã chặn nó, không phải thiếu quyền.
Đo thật: errno đổi 1 sang 22, và filter cộng 24 ns
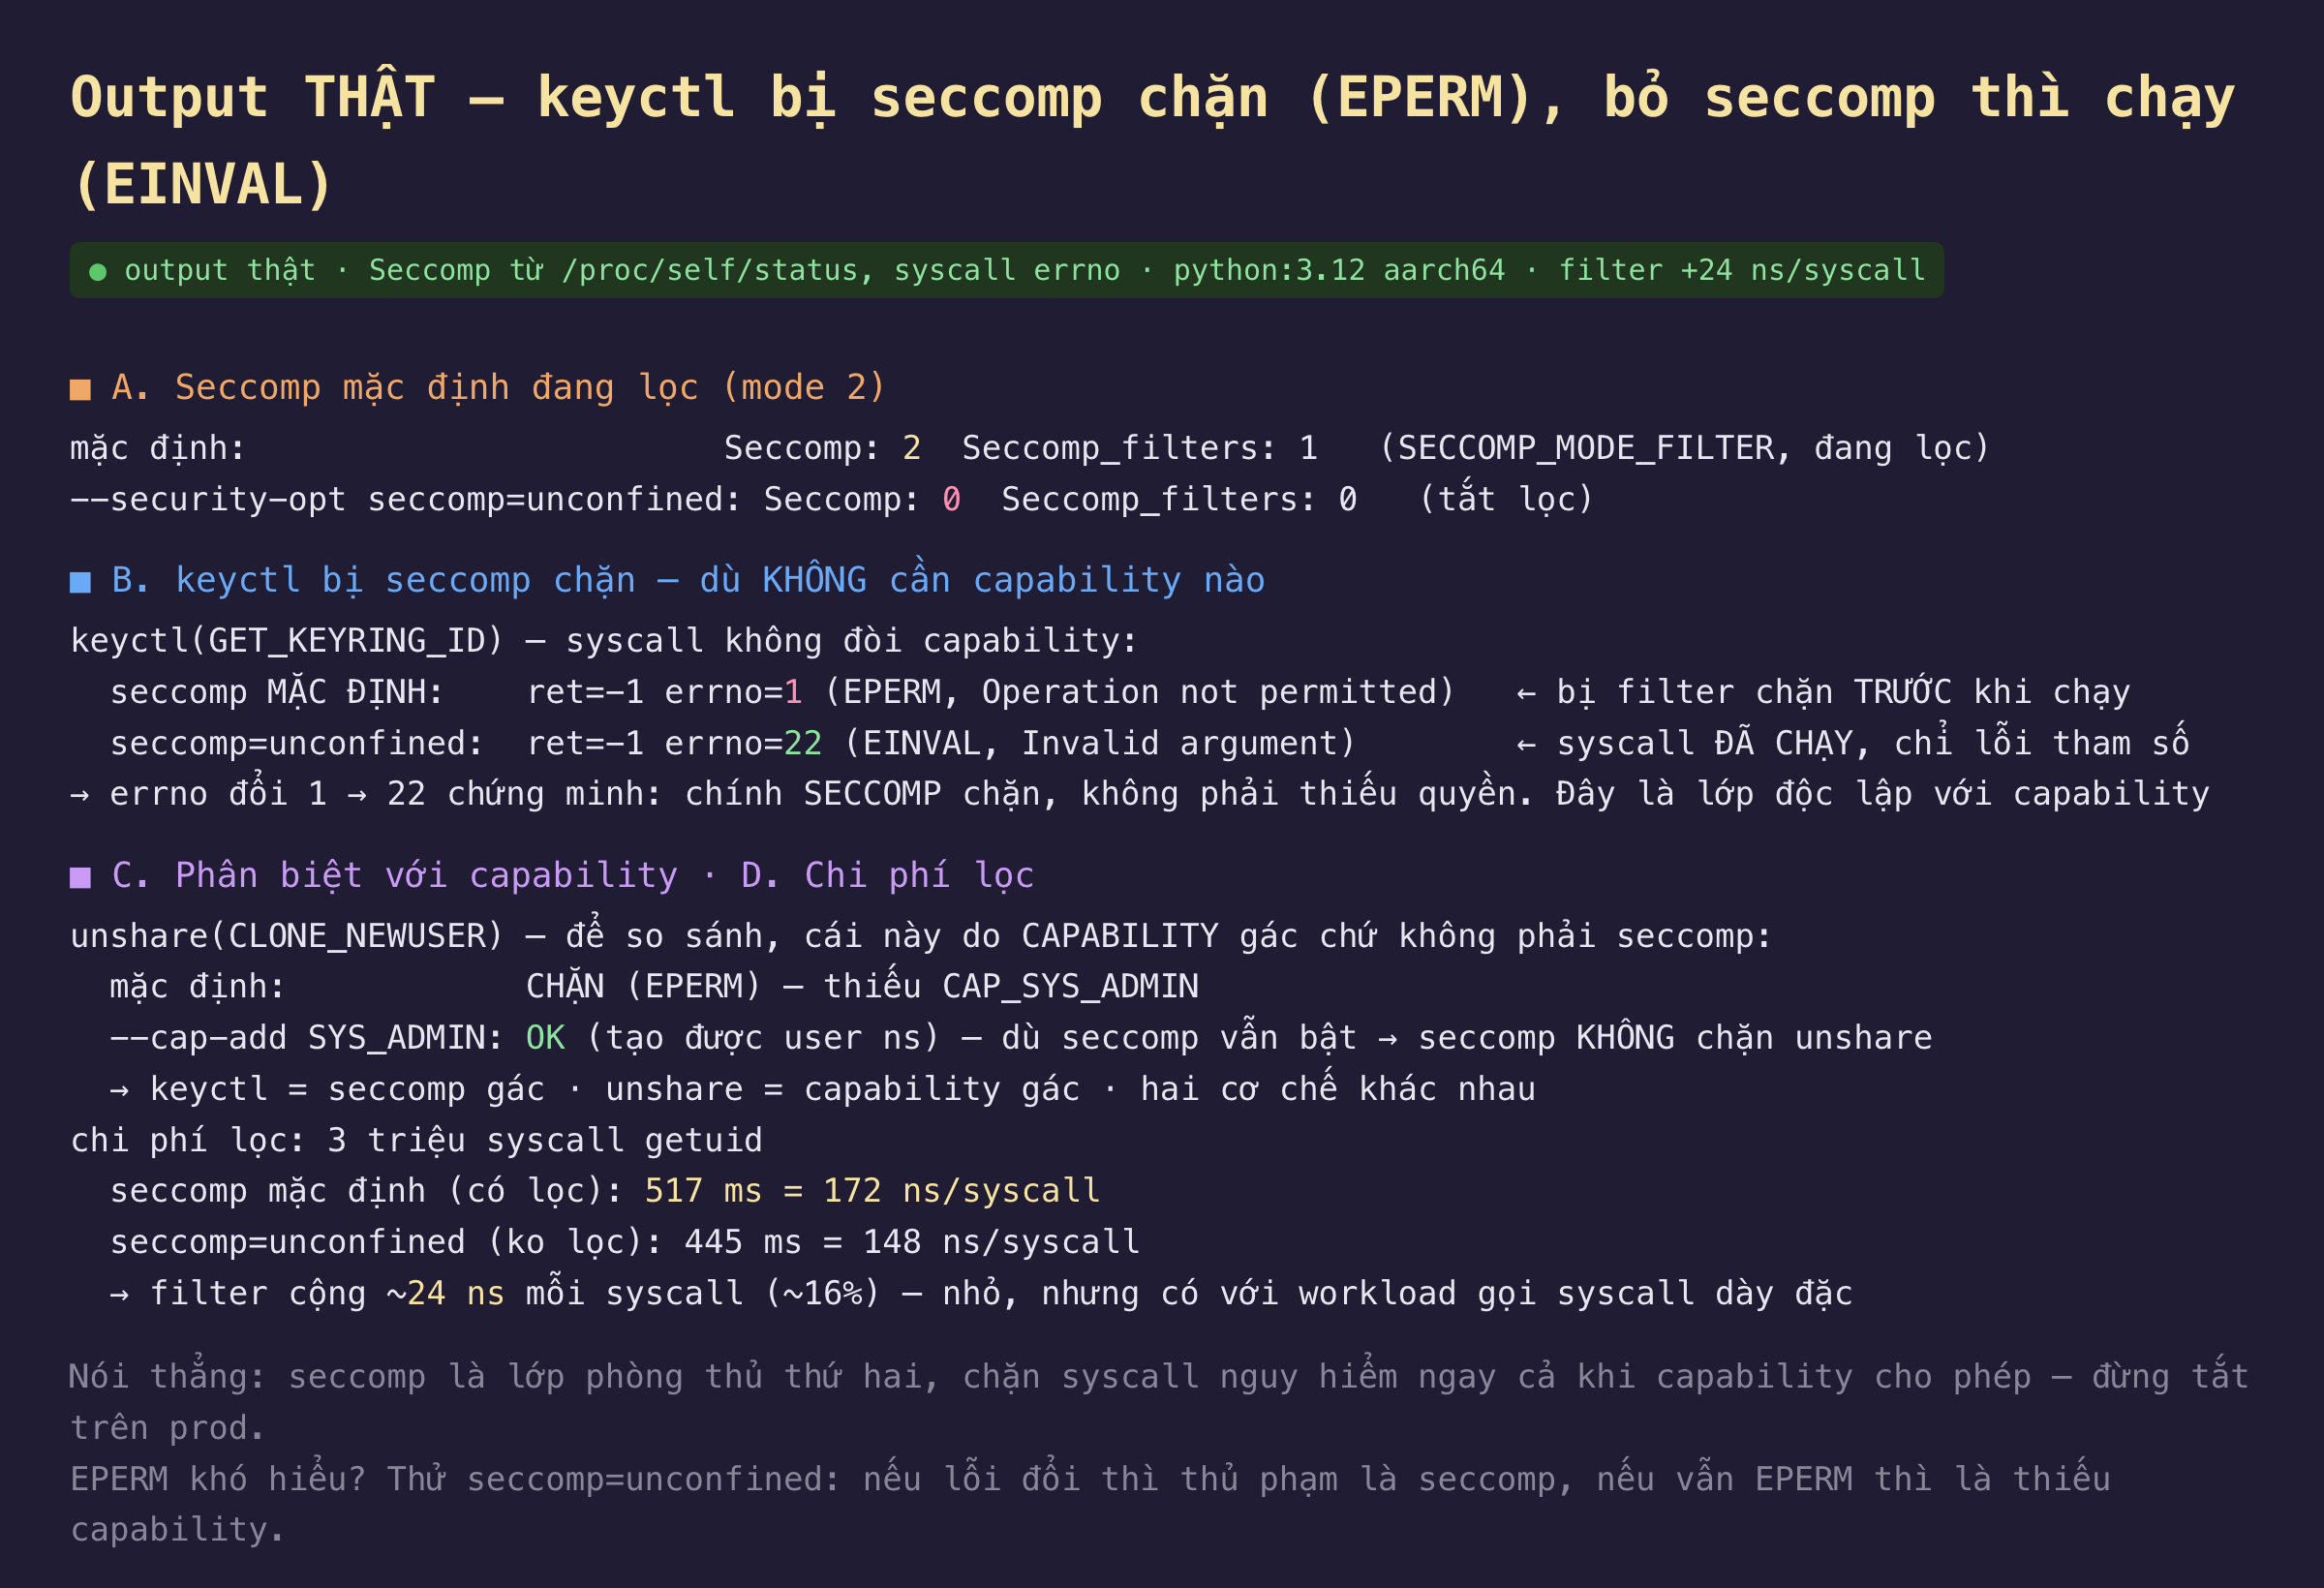
Hình 2: Seccomp mặc định đang lọc, keyctl bị chặn với errno đổi từ EPERM sang EINVAL, và chi phí lọc 24 ns mỗi syscall.
| phép đo | kết quả |
|---|---|
| Seccomp mặc định | 2 (mode FILTER), Seccomp_filters 1 |
Seccomp với --security-opt seccomp=unconfined |
0, Seccomp_filters 0 |
| keyctl mặc định | ret=-1 errno=1 (EPERM, bị filter chặn) |
| keyctl với seccomp=unconfined | ret=-1 errno=22 (EINVAL, syscall đã chạy) |
| unshare(CLONE_NEWUSER) mặc định | CHẶN (EPERM, thiếu CAP_SYS_ADMIN) |
unshare với --cap-add SYS_ADMIN (seccomp vẫn bật) |
OK |
| 3 triệu getuid, có filter | 517 ms = 172 ns/syscall |
| 3 triệu getuid, không filter | 445 ms = 148 ns/syscall |
| chi phí filter | +24 ns/syscall (~16%) |
Seccomp mặc định đang lọc, đọc trực tiếp từ /proc/self/status. Trong container mặc định, trường Seccomp bằng 2 và Seccomp_filters bằng 1: giá trị 2 là hằng SECCOMP_MODE_FILTER, nghĩa là một bộ lọc BPF đang gắn và lọc mọi syscall. Chạy lại chính container đó với --security-opt seccomp=unconfined, cả hai trường về 0: không còn filter nào. Đây là xác nhận đầu tiên và đơn giản nhất rằng Docker thực sự gắn seccomp cho mọi container, không phải một tính năng tùy chọn. Một ứng dụng chạy trong container Docker bình thường đang bị lọc syscall dù chủ container không làm gì để bật nó.
errno đổi từ 1 sang 22 chứng minh chính seccomp chặn, không phải thiếu quyền. Đây là phép đo cốt lõi. Gọi keyctl(KEYCTL_GET_KEYRING_ID), một syscall không đòi capability nào, dưới seccomp mặc định cho ret=-1 errno=1, tức EPERM, "Operation not permitted". Nhìn một mình, lỗi này mơ hồ: nó giống hệt lỗi khi thiếu quyền. Nhưng chạy lại với seccomp=unconfined, cùng lời gọi cho ret=-1 errno=22, tức EINVAL, "Invalid argument". Khác biệt này quyết định: dưới unconfined, syscall keyctl đã thực sự đi vào kernel và chạy, chỉ trả lỗi vì tham số tôi truyền không hợp lệ cho mục đích thật; còn dưới mặc định, nó không bao giờ tới được đó, bị filter chặn ngay ở cửa và trả EPERM. Vì keyctl không cần capability, nguyên nhân EPERM chỉ có thể là seccomp. Mã lỗi đổi từ 1 sang 22 là bằng chứng trực tiếp rằng seccomp là một lớp kiểm soát độc lập, nằm trước và tách biệt với capability.
unshare bị chặn vì capability, không phải seccomp, để làm đối chứng. Để thấy rõ hai cơ chế khác nhau, bài đo thêm unshare(CLONE_NEWUSER), thao tác tạo user namespace. Dưới mặc định nó bị chặn với EPERM, nhưng khi thêm --cap-add SYS_ADMIN, nó chạy được dù seccomp vẫn bật. Điều này nói rằng cái chặn unshare là capability, không phải seccomp: cấp đúng capability là mở khóa, không cần đụng tới seccomp. Đối lập với keyctl, thứ mà thêm capability không giúp gì vì rào chắn nằm ở seccomp. Hai thao tác, hai cơ chế: keyctl do seccomp gác, unshare do capability gác. Đây là lý do cần cả hai lớp, và lý do một mã lỗi EPERM đơn độc không bao giờ nói đủ câu chuyện.
Lọc syscall tốn khoảng 24 ns mỗi lần gọi, nhỏ nhưng có thật. Chi phí seccomp không bằng không: mỗi syscall phải chạy qua chương trình BPF của filter trước khi vào kernel. Đo bằng vòng lặp 3 triệu lần gọi getuid, một syscall rẻ nhất có thể để cô lập chi phí lọc: dưới seccomp mặc định mất 517 ms, tức 172 ns mỗi syscall; dưới unconfined mất 445 ms, tức 148 ns mỗi syscall. Filter cộng khoảng 24 ns mỗi syscall, chừng 16 phần trăm. Với ứng dụng bình thường, chi phí này không đáng kể vì phần lớn thời gian nằm ở logic và I/O, không ở việc vào ra kernel. Nhưng với workload gọi syscall cực dày, ví dụ một event loop gọi hàng triệu syscall mỗi giây, 24 ns mỗi lần cộng lại thành con số đo được. Đây là một đánh đổi an toàn có chi phí, không miễn phí, nhưng gần như luôn đáng.
Đánh đổi cần cân nhắc
Đừng tắt seccomp trên production, kể cả khi nó gây lỗi khó hiểu. Cám dỗ lớn nhất khi gặp một EPERM bí ẩn là chạy lại với --security-opt seccomp=unconfined và thấy mọi thứ hoạt động, rồi để nguyên như vậy. Đó là bỏ cả một lớp phòng thủ để tránh đọc kỹ một lỗi. Cách đúng là dùng unconfined như công cụ chẩn đoán: nếu lỗi đổi, thủ phạm là seccomp và bạn cần một profile tùy chỉnh cho phép đúng syscall thiếu; nếu lỗi vẫn là EPERM, thủ phạm là capability và seccomp vô can. Docker cho phép nạp profile seccomp riêng bằng --security-opt seccomp=profile.json, thêm đúng syscall cần mà không mở toang tất cả.
Profile mặc định đủ cho hầu hết ứng dụng, nhưng một số runtime cần nới. Phần lớn ứng dụng backend chạy trơn tru dưới profile mặc định vì chúng chỉ dùng syscall thông thường. Nhưng một số công cụ đụng tới syscall bị chặn: trình gỡ lỗi dùng ptrace, một số runtime mới dùng clone3, công cụ quan sát dùng perf_event_open hay bpf. Khi một trong số này gãy trong container mà chạy ngoài thì không, seccomp là nghi phạm đầu tiên nên kiểm. Phép đo errno trong bài này là cách xác nhận nhanh: nếu unconfined sửa được, viết một profile nới đúng syscall đó thay vì tắt hẳn.
Phạm vi đo. Bài đo trạng thái và hiệu ứng của seccomp, không đi vào cấu trúc chương trình BPF của filter hay cú pháp profile JSON. getuid là syscall rẻ nhất nên con số 24 ns là chi phí lọc gần như thuần; syscall phức tạp hơn có chi phí lọc tương tự theo số tuyệt đối nhưng tỉ lệ nhỏ hơn nhiều. Chưa đo seccomp notify, cơ chế mới cho phép một tiến trình giám sát xử lý syscall bị chặn, và chưa đo tương tác giữa seccomp với ptrace hay với các LSM như AppArmor và SELinux, những lớp kiểm soát khác cùng hoạt động trong một container thật.
Ba ý mang về
- Seccomp là lớp lọc syscall độc lập, nằm dưới capability. Docker gắn sẵn profile mặc định (Seccomp = 2 mode FILTER) chặn khoảng 40-50 syscall nguy hiểm; một syscall bị chặn trả
EPERMngay cả khi tiến trình đủ quyền. - errno phân biệt được seccomp với capability. keyctl mặc định cho EPERM,
seccomp=unconfinedcho EINVAL: errno đổi 1 sang 22 chứng minh seccomp chặn, không phải thiếu quyền. Dùngunconfinedlàm công cụ chẩn đoán, đừng để nó trên prod. - Lọc syscall tốn khoảng 24 ns mỗi lần. Với 3 triệu getuid, filter thêm 16 phần trăm; không đáng kể cho ứng dụng thường, đo được với workload gọi syscall dày đặc.
Nguồn
- Linux
seccomp(2)— SECCOMP_MODE_FILTER và cách bộ lọc BPF hoạt động: https://man7.org/linux/man-pages/man2/seccomp.2.html - Docker — Seccomp security profiles for Docker, profile mặc định và danh sách syscall bị chặn: https://docs.docker.com/engine/security/seccomp/
- Docker — profile seccomp mặc định (
default.json) trên GitHub: https://github.com/moby/moby/blob/master/profiles/seccomp/default.json - Linux
proc(5)—/proc/PID/status, trường Seccomp và Seccomp_filters: https://man7.org/linux/man-pages/man5/proc.5.html - Linux
keyctl(2)— thao tác keyring, syscall bị profile mặc định của Docker chặn: https://man7.org/linux/man-pages/man2/keyctl.2.html - Kubernetes — Restrict a Container's Syscalls with seccomp: https://kubernetes.io/docs/tutorials/security/seccomp/
Phần sau rời khỏi bảo mật syscall để đo giới hạn tài nguyên ở cấp tiến trình: file descriptor và RLIMIT_NOFILE trong container. Xem một tiến trình đụng trần fd thì gãy thế nào, giới hạn mặc định của Docker là bao nhiêu, và cách --ulimit cùng cgroup phối hợp kiểm soát số file một container mở được.
