Suốt 11 phần, ta mổ xẻ từng tầng một request đi qua: DNS, bắt tay TCP, TLS, keep-alive, pool, HTTP/2 — cùng những khái niệm nền như TCP vs UDP, Nagle, buffer/backlog, trạng thái socket, băng thông vs độ trễ. Bài cuối này (phần 12) không thêm khái niệm mới; nó dạy cách dùng tất cả để chẩn đoán. Vì câu than phiền "mạng chậm" hầu như luôn mơ hồ — chậm ở DNS? bắt tay? TLS? hay server? Cách duy nhất để biết là tách một request ra thành từng tầng và nhìn phần nào lớn nhất. Bài này chạy thật để minh họa.
Cây chẩn đoán: triệu chứng → tầng → công cụ
Một request đi theo thứ tự các tầng, mỗi tầng ta đã có một bài. Khi có sự cố, kiểm theo đúng thứ tự đó:
DNS (bài 8) -> TCP bắt tay (bài 1) -> TLS (bài 7)
   -> gửi/nhận (keep-alive bài 5, pool bài 6, HTTP/2 bài 11)
Ánh xạ triệu chứng sang tầng nghi ngờ và công cụ:
| Triệu chứng | Nghi tầng | Công cụ |
|---|---|---|
| Chậm khi gọi host mới, lần sau nhanh | DNS cold (bài 8) | dig, httptrace DNSStart/Done |
| Chậm đều, RTT cao | độ trễ (bài 10) | ping, curl -w time_connect |
| HTTPS chậm, HTTP nhanh | TLS (bài 7) | curl -w time_appconnect |
| Tải file lớn chậm dù băng thông cao | cửa sổ < BDP (bài 10) | iperf3 |
| "cannot assign requested address" | TIME_WAIT/churn (bài 9) | ss -tan | grep TIME-WAIT |
| "too many open files" | CLOSE_WAIT rò rỉ (bài 9) | ss -tan | grep CLOSE-WAIT |
| Gói nhỏ trễ ~40ms | Nagle (bài 3) | tắt Nagle / gộp ghi |
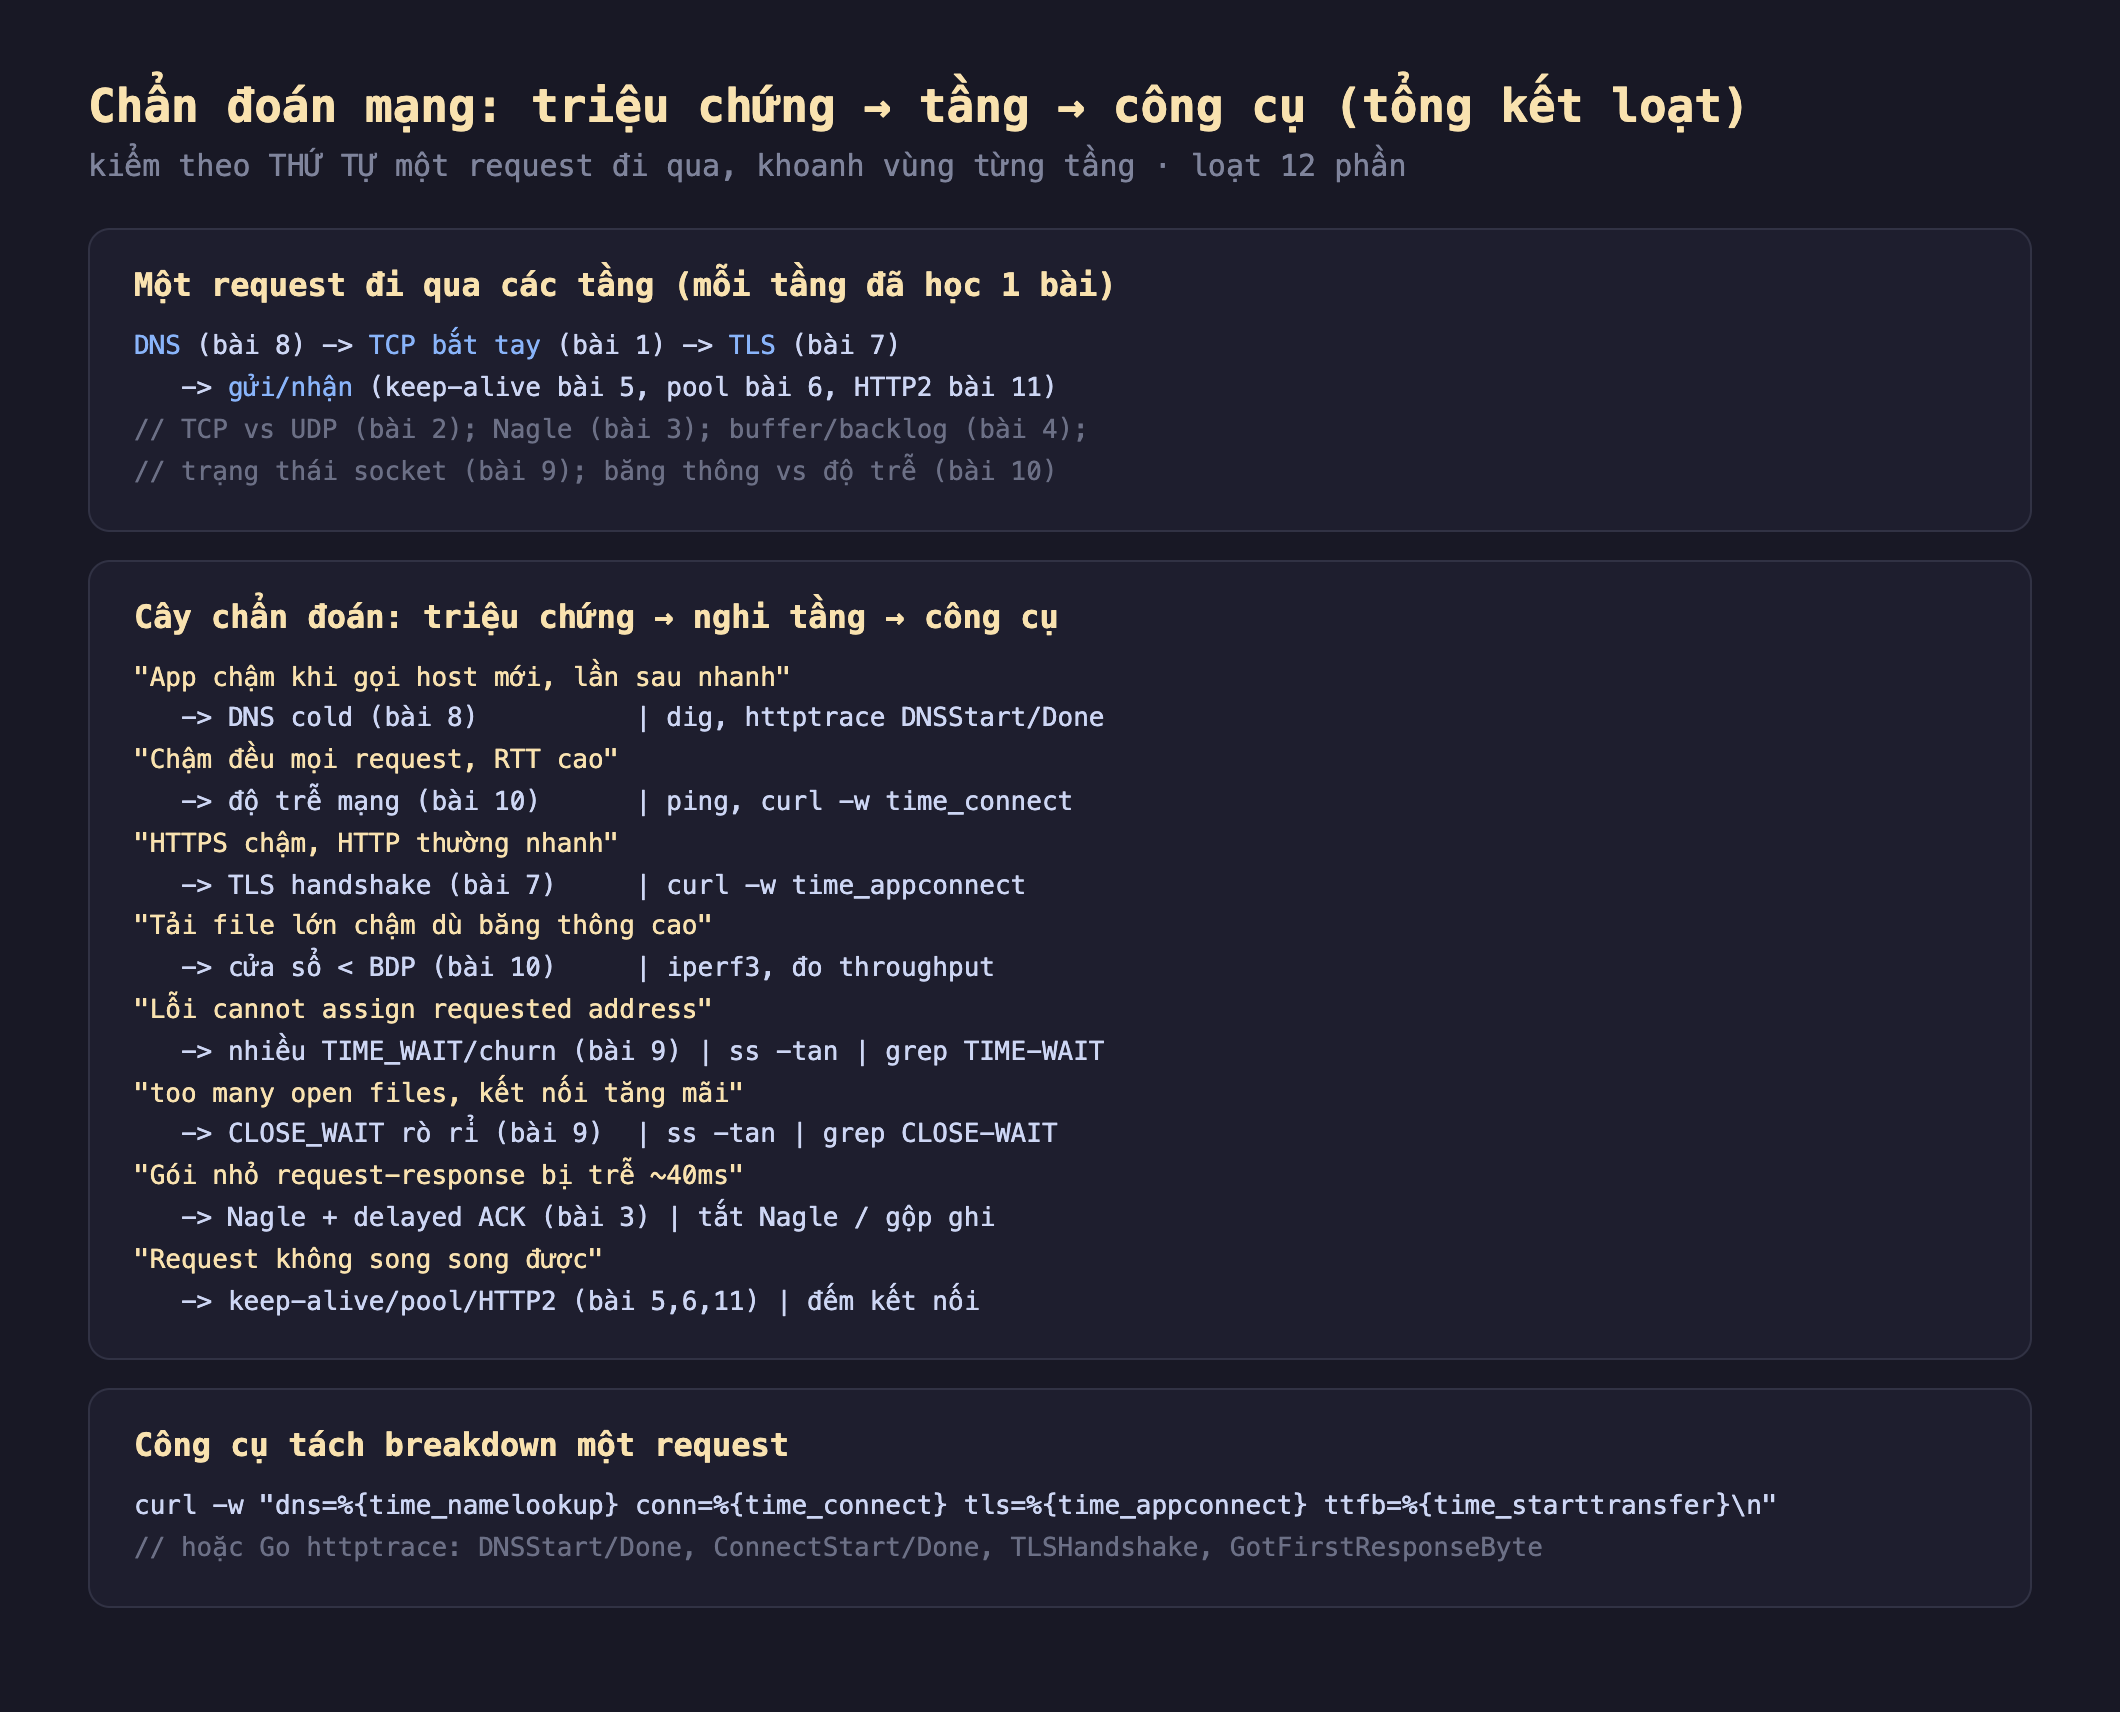
Hình 1: Một request đi qua DNS → TCP → TLS → gửi/nhận (mỗi tầng một bài); cây chẩn đoán ánh xạ triệu chứng sang tầng nghi ngờ và công cụ tương ứng; tách breakdown bằng curl -w hoặc httptrace.
Đo thật: tách một request thấy ngay nút cổ chai
Công cụ mạnh nhất để khoanh vùng là tách một request thành từng phần thời gian. Trong Go dùng httptrace; trong shell dùng curl -w:
trace := &httptrace.ClientTrace{
    DNSStart: ..., DNSDone: ...,           // thời gian DNS
    ConnectStart: ..., ConnectDone: ...,   // thời gian bắt tay TCP
    TLSHandshakeStart: ..., TLSHandshakeDone: ...,  // thời gian TLS
    GotFirstResponseByte: ...,             // TTFB: server mất bao lâu để trả byte đầu
}
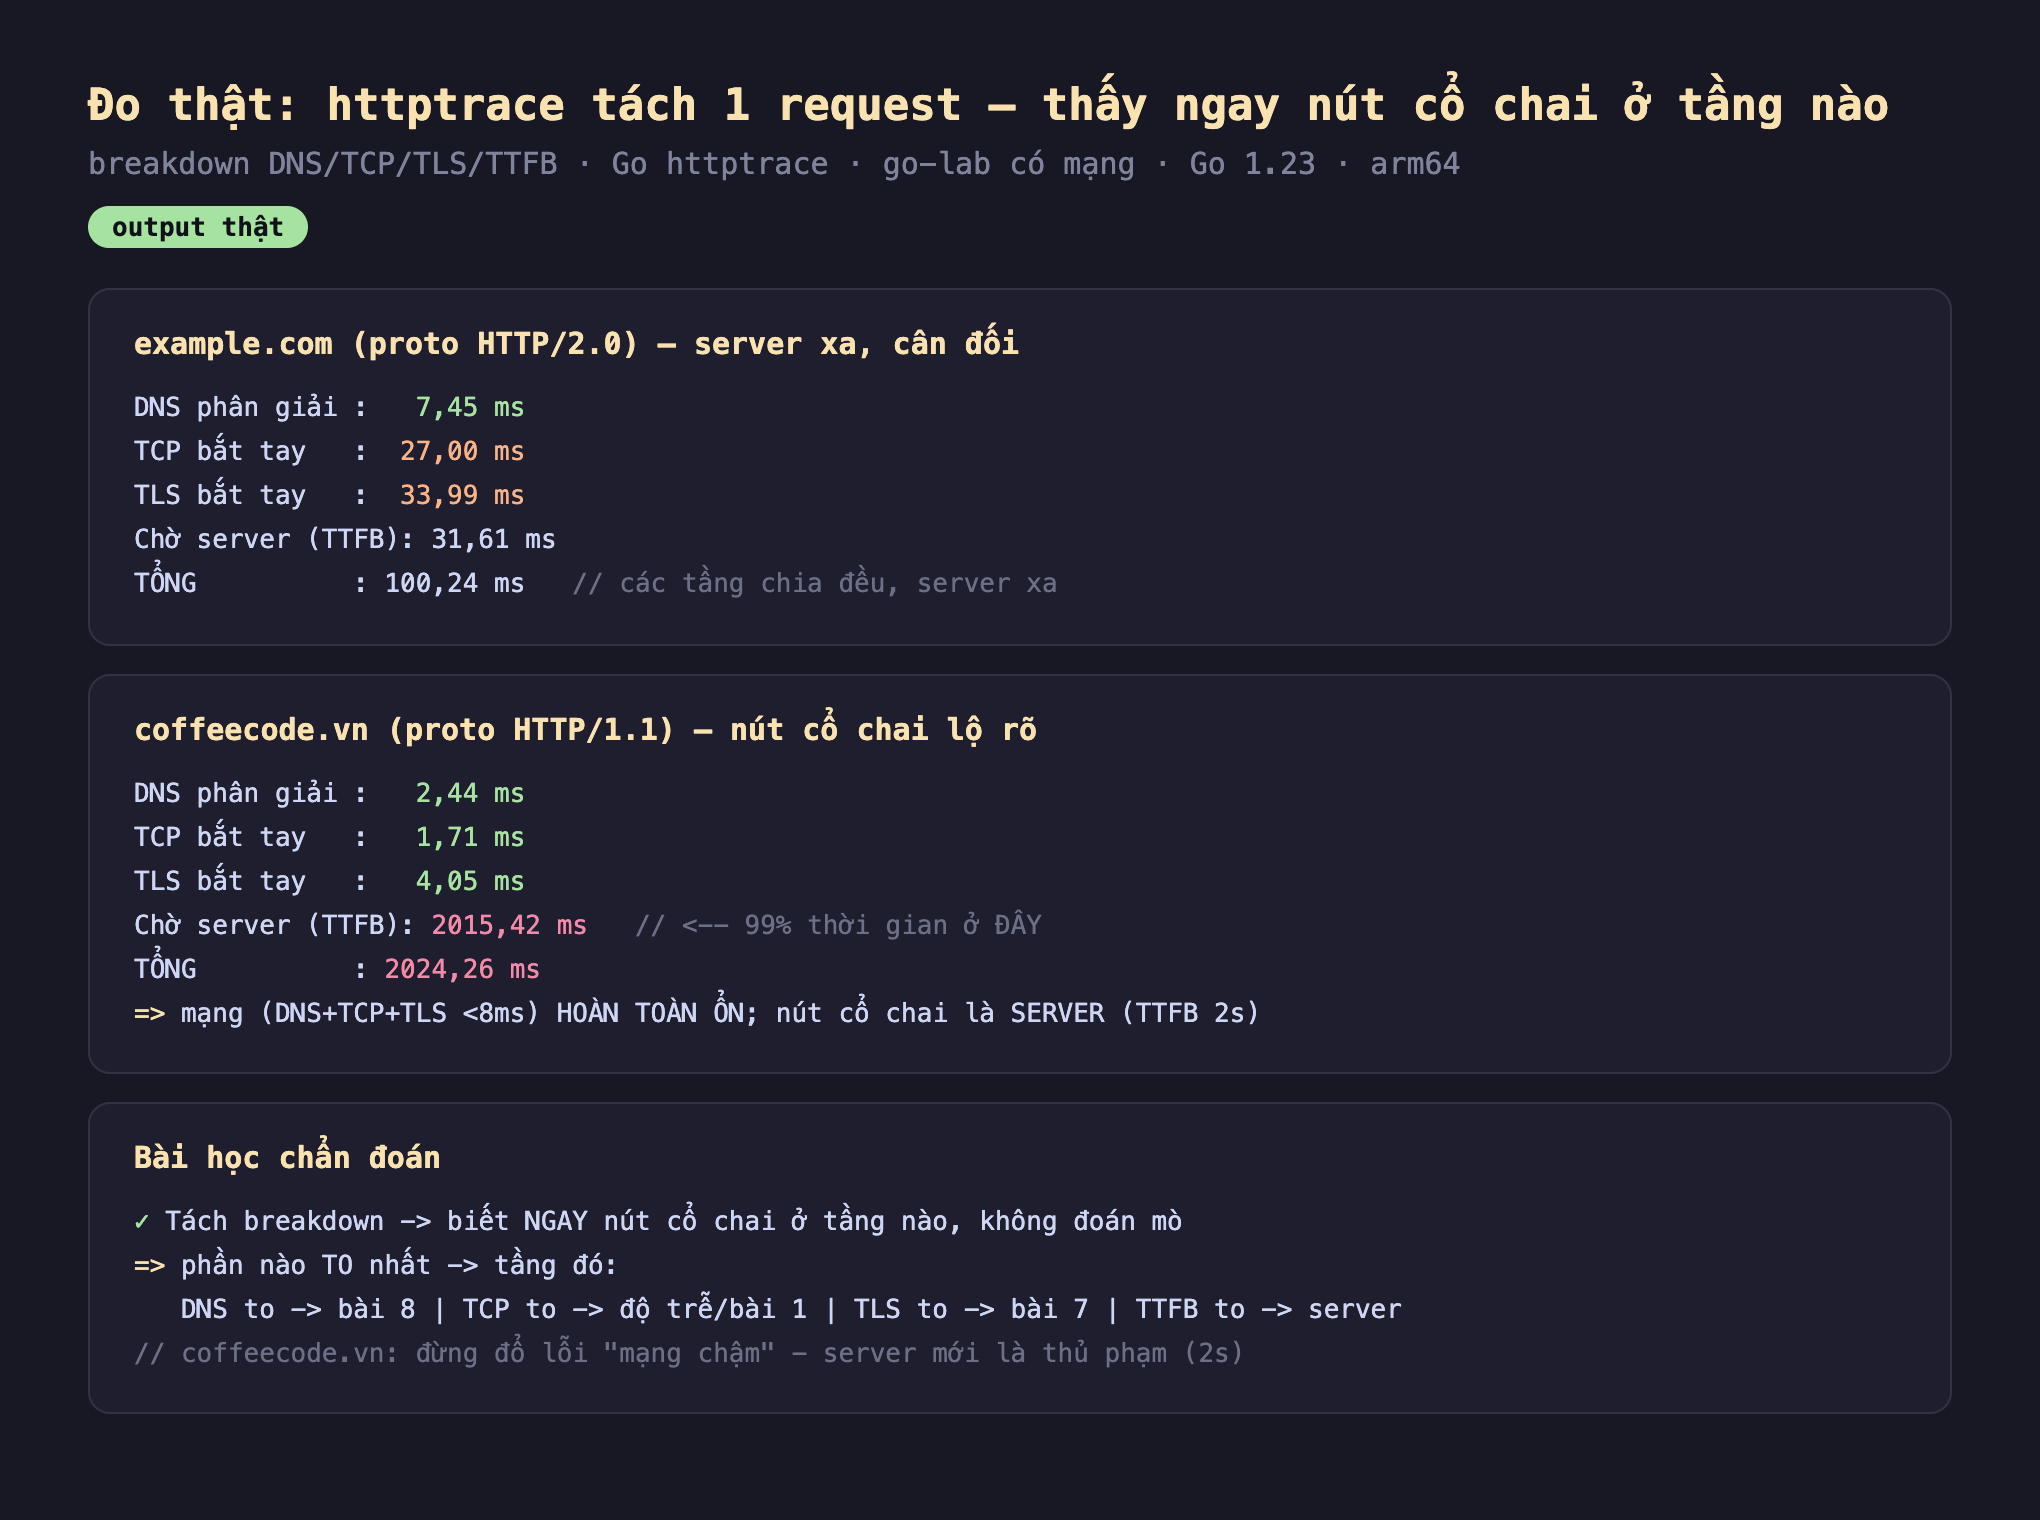
Hình 2: Chạy thật — example.com: DNS 7,45ms + TCP 27ms + TLS 34ms + TTFB 31,6ms = 100ms (các tầng chia đều, server xa); coffeecode.vn: DNS/TCP/TLS đều <5ms nhưng TTFB 2015ms — mạng hoàn toàn ổn, nút cổ chai là server.
Đọc kết quả đo được:
- example.com — cân đối, server xa: DNS 7,45ms, TCP 27ms, TLS 34ms, TTFB 31,6ms, tổng 100ms. Các tầng chia tương đối đều; TCP và TLS lớn vì server ở xa (RTT cao — mỗi bắt tay tốn cả RTT như bài 1 và 7 đã đo). Không có tầng nào bất thường.
- coffeecode.vn — nút cổ chai lộ rõ ngay: DNS 2,44ms, TCP 1,71ms, TLS 4,05ms — toàn bộ phần mạng chưa tới 8ms. Nhưng TTFB là 2015ms: server mất 2 giây để bắt đầu trả byte đầu tiên. Tổng 2024ms, và 99% nằm ở việc chờ server. Đây là kết luận chẩn đoán tức thì: nếu ai đó nói "trang này tải chậm do mạng", breakdown này bác bỏ ngay — mạng nhanh, server mới là thủ phạm (có thể đang tải nặng, query chậm, hay khởi động nguội).
- Nguyên tắc: nhìn phần nào lớn nhất: DNS lớn → xem lại phần 8; TCP lớn → độ trễ mạng (phần 1, 10); TLS lớn → phần 7; TTFB lớn → không phải mạng, mà là server. Breakdown biến câu hỏi mơ hồ "mạng chậm à?" thành một câu trả lời cụ thể trong vài giây.
Đánh đổi cần cân nhắc
Chẩn đoán từ ngoài vào, theo thứ tự tầng — đừng nhảy cóc. Cám dỗ là đoán ngay ("chắc do DNS", "chắc server yếu") rồi tối ưu nhầm chỗ. Quy trình kỷ luật: tách breakdown trước, xác định tầng lớn nhất, rồi mới đào sâu tầng đó bằng công cụ chuyên biệt (bài tương ứng). Một breakdown 5 giây tiết kiệm hàng giờ tối ưu sai hướng — như ví dụ coffeecode.vn, tối ưu DNS hay TLS sẽ hoàn toàn vô ích vì vấn đề ở server.
localhost giấu phần lớn vấn đề mạng thật. Suốt loạt bài, nhiều số đo trên localhost cho giá trị microsecond vì RTT~0 — bắt tay, keep-alive, TLS, băng thông đều "nhanh giả". Chẩn đoán thật phải đo trên đường mạng thật tới nơi có vấn đề, hoặc ít nhất từ một máy có RTT gần với người dùng cuối. Đừng kết luận "mọi thứ nhanh" từ số localhost.
Không có một công cụ vạn năng — biết công cụ nào cho tầng nào. ping đo độ trễ (không đo throughput); dig cho DNS; curl -w/httptrace cho breakdown một request; ss cho trạng thái socket; iperf3 cho throughput; tcpdump/Wireshark khi cần soi gói. Cây chẩn đoán ở Hình 1 chính là để chọn đúng công cụ theo triệu chứng, thay vì dùng một công cụ cho mọi thứ.
Ba ý mang về
- Tách một request ra là cách nhanh nhất khoanh vùng "mạng chậm": đo thật httptrace cho breakdown DNS/TCP/TLS/TTFB — nhìn phần nào lớn nhất là biết tầng nào có vấn đề, không đoán mò.
- TTFB lớn nghĩa là server, không phải mạng: đo thật coffeecode.vn có DNS+TCP+TLS <8ms nhưng TTFB 2015ms — 99% thời gian là chờ server; đừng đổ lỗi cho mạng khi breakdown chỉ thẳng vào server.
- Chẩn đoán theo thứ tự tầng, dùng đúng công cụ, đo trên mạng thật: mỗi triệu chứng ứng với một tầng và một công cụ (ping/dig/ss/curl -w/httptrace/iperf3); localhost giấu vấn đề mạng thật nên phải đo trên đường gần với thực tế.
Nguồn
- Go docs — net/http/httptrace: https://pkg.go.dev/net/http/httptrace
- curl — biến -w (time_namelookup, time_connect, time_appconnect, time_starttransfer): https://curl.se/docs/manpage.html
- Brendan Gregg — Linux Performance (network tools): https://www.brendangregg.com/linuxperf.html
Loạt Mạng cho lập trình viên khép lại ở đây sau 12 phần: từ bắt tay TCP (phần 1) tới bài chẩn đoán này. Xuyên suốt, mỗi phần đều chạy demo thật trong container và báo số đo trung thực — kể cả khi kết quả phản trực giác hay bị localhost làm mờ (UDP mất 99,9% khi bị dồn, Nagle gây trễ đúng 40ms, keep-alive giảm 500 kết nối xuống 1, HTTP/2 mở 0 kết nối mới, và ngay bài cuối này server coffeecode.vn ngốn 2 giây trong khi mạng chỉ 8ms). Hy vọng bạn rời loạt bài với một thói quen: khi mạng "có vấn đề", tách nó ra thành từng tầng và đo, thay vì đoán — vì gần như luôn có một tầng cụ thể đang là thủ phạm, và nó hiếm khi là tầng bạn nghĩ đầu tiên.
