Bạn vận hành một hệ message queue. Câu hỏi quan trọng nhất mỗi ngày không phải "throughput bao nhiêu" hay "CPU bao nhiêu phần trăm" — mà là consumer có theo kịp producer không? Nếu producer ghi nhanh hơn consumer xử lý, message dồn lại, và khoảng cách đó — gọi là consumer lag — lớn dần. Lag tăng nghĩa là dữ liệu đến tay người dùng ngày càng cũ: email xác nhận gửi trễ 10 phút, thống kê trễ một tiếng, cảnh báo trễ tới mức vô dụng. Lag là chỉ báo sớm nhất và chính xác nhất cho biết hệ sắp không trụ nổi — sớm hơn cả lúc CPU chạm trần. Bài này (phần 7 loạt Message Queue) đo thật lag tăng và giảm để thấy vì sao nó là tín hiệu cảnh báo số một.
Lag là gì: khoảng cách giữa ghi và đọc
Mỗi partition Kafka là một log có đánh số thứ tự (offset). Có hai con số then chốt:
- LOG-END-OFFSET — offset cao nhất, tức producer đã ghi tới đâu.
- CURRENT-OFFSET — offset consumer group đã xử lý (commit) tới đâu.
Lag là hiệu của hai con số đó:
LAG = LOG-END-OFFSET − CURRENT-OFFSET
       (producer ghi tới)   (consumer đọc tới)

# partition như một ống:
[đã xử lý |===== LAG =====| chưa tới]
            ↑CURRENT          ↑LOG-END
Lag = số message đã có trong hàng đợi mà chưa được xử lý. Lag = 0 nghĩa consumer đã bắt kịp hoàn toàn. Lag ổn định ở một mức nhỏ là bình thường (luôn có message đang chờ). Lag tăng dần không ngừng là báo động: consumer đang tụt lại, và nếu không can thiệp, độ trễ xử lý sẽ tăng vô hạn.
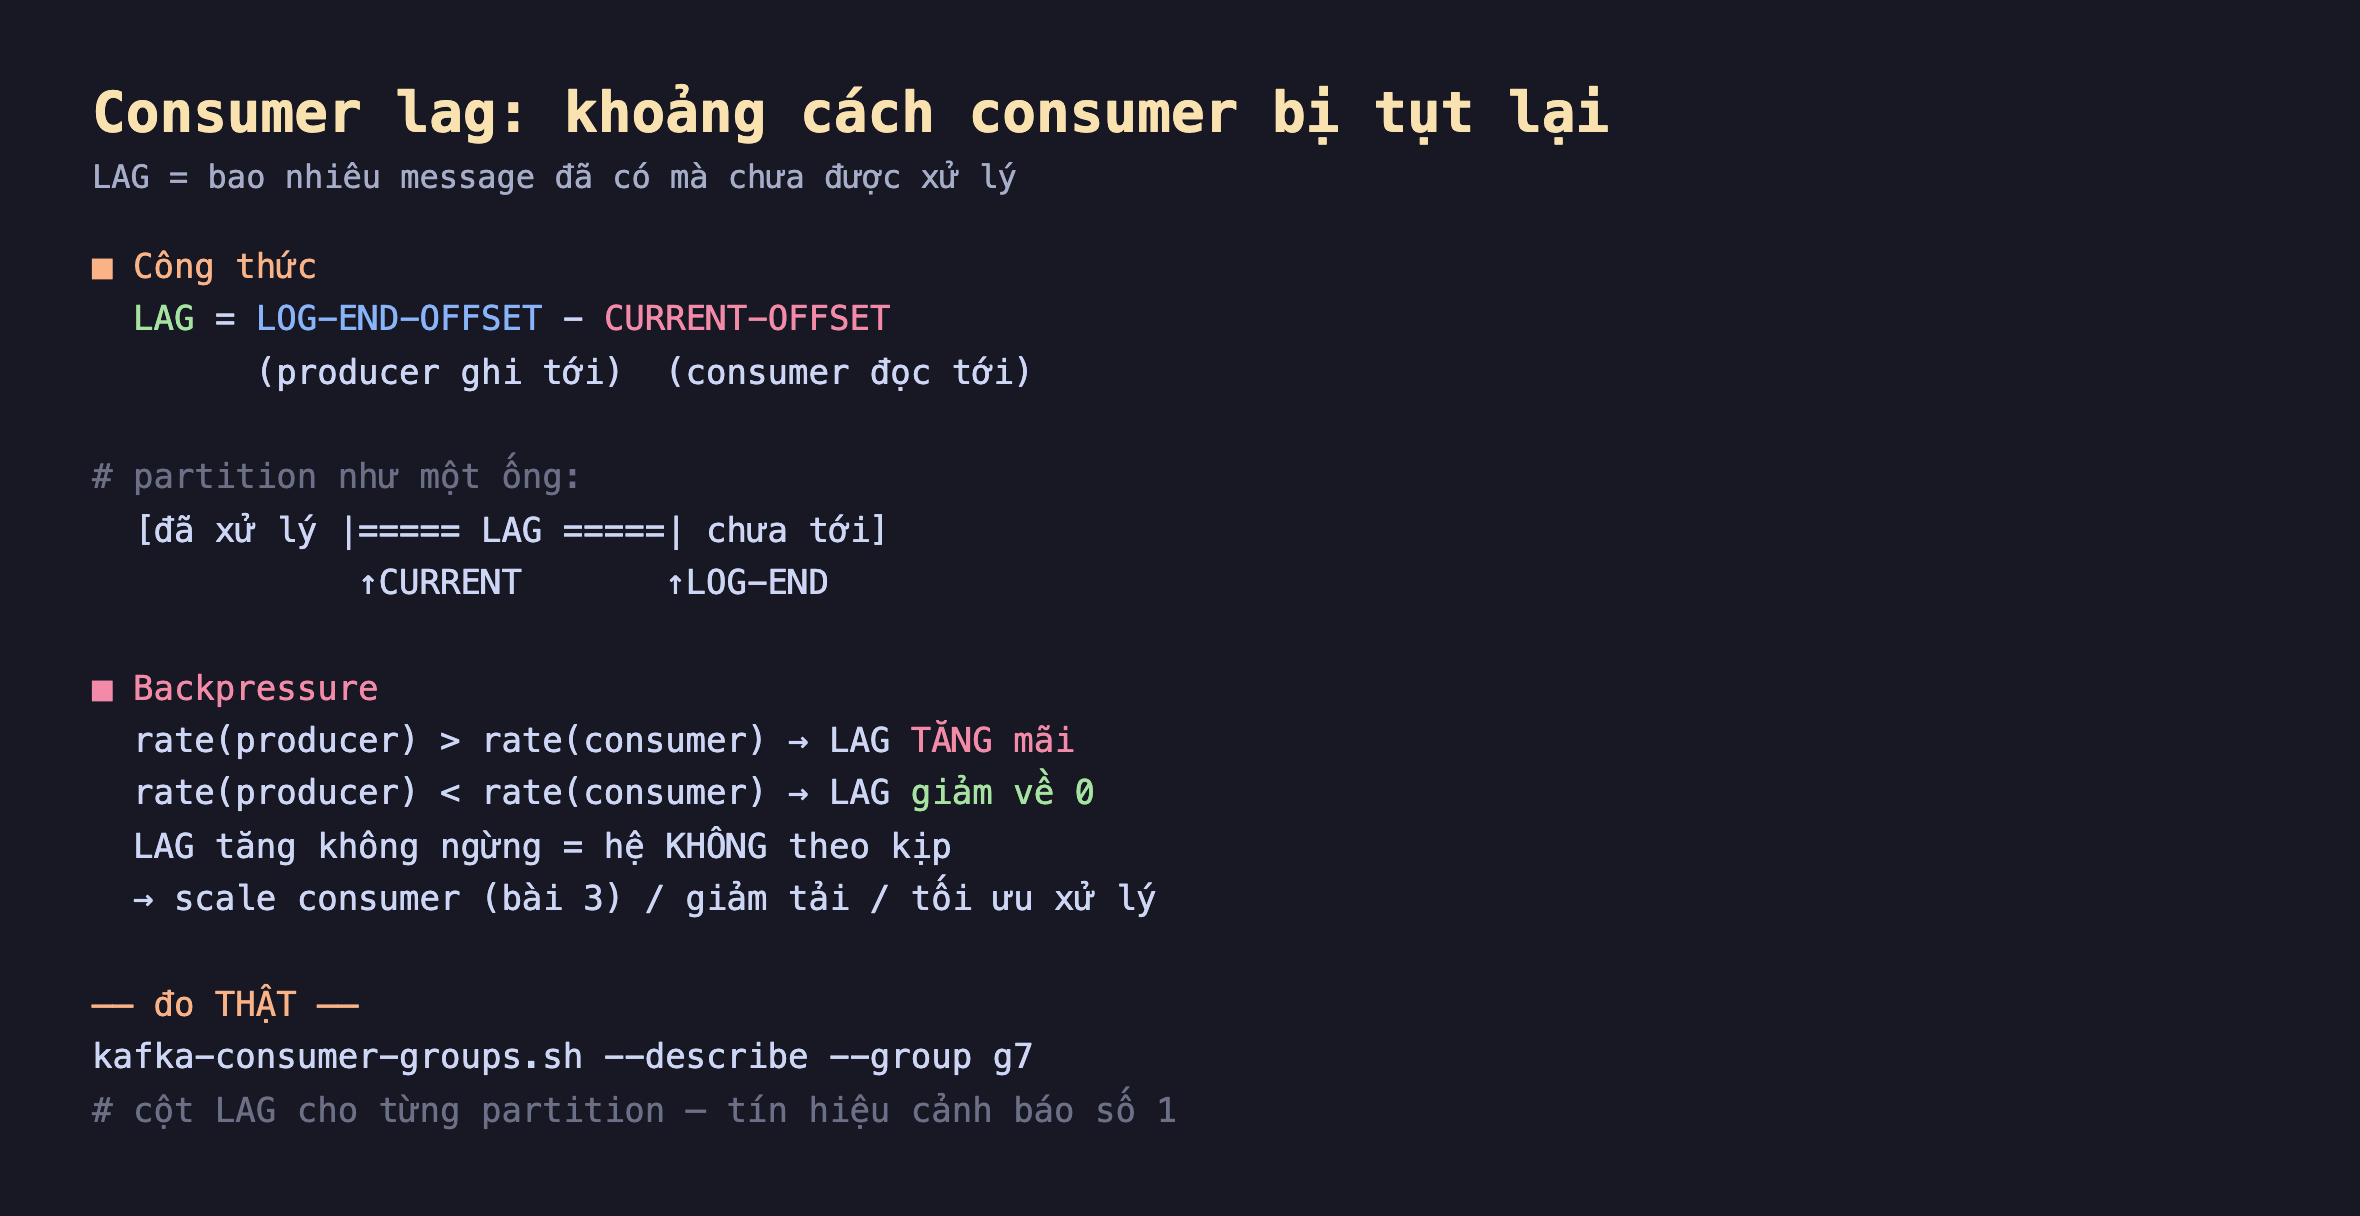
Hình 1: Lag là khoảng cách giữa nơi producer ghi (LOG-END-OFFSET) và nơi consumer đọc (CURRENT-OFFSET). Khi rate(producer) > rate(consumer), lag tăng mãi (backpressure); khi ngược lại, lag giảm về 0. Đo bằng kafka-consumer-groups --describe — cột LAG cho từng partition.
Đo thật: lag vọt lên khi producer vượt consumer
Mình produce 200.000 message vào kafka-lab làm backlog, rồi cho consumer xử lý chậm (từng đợt 50.000) trong khi producer thỉnh thoảng đẩy thêm, đo lag qua kafka-consumer-groups --describe tại bốn thời điểm:
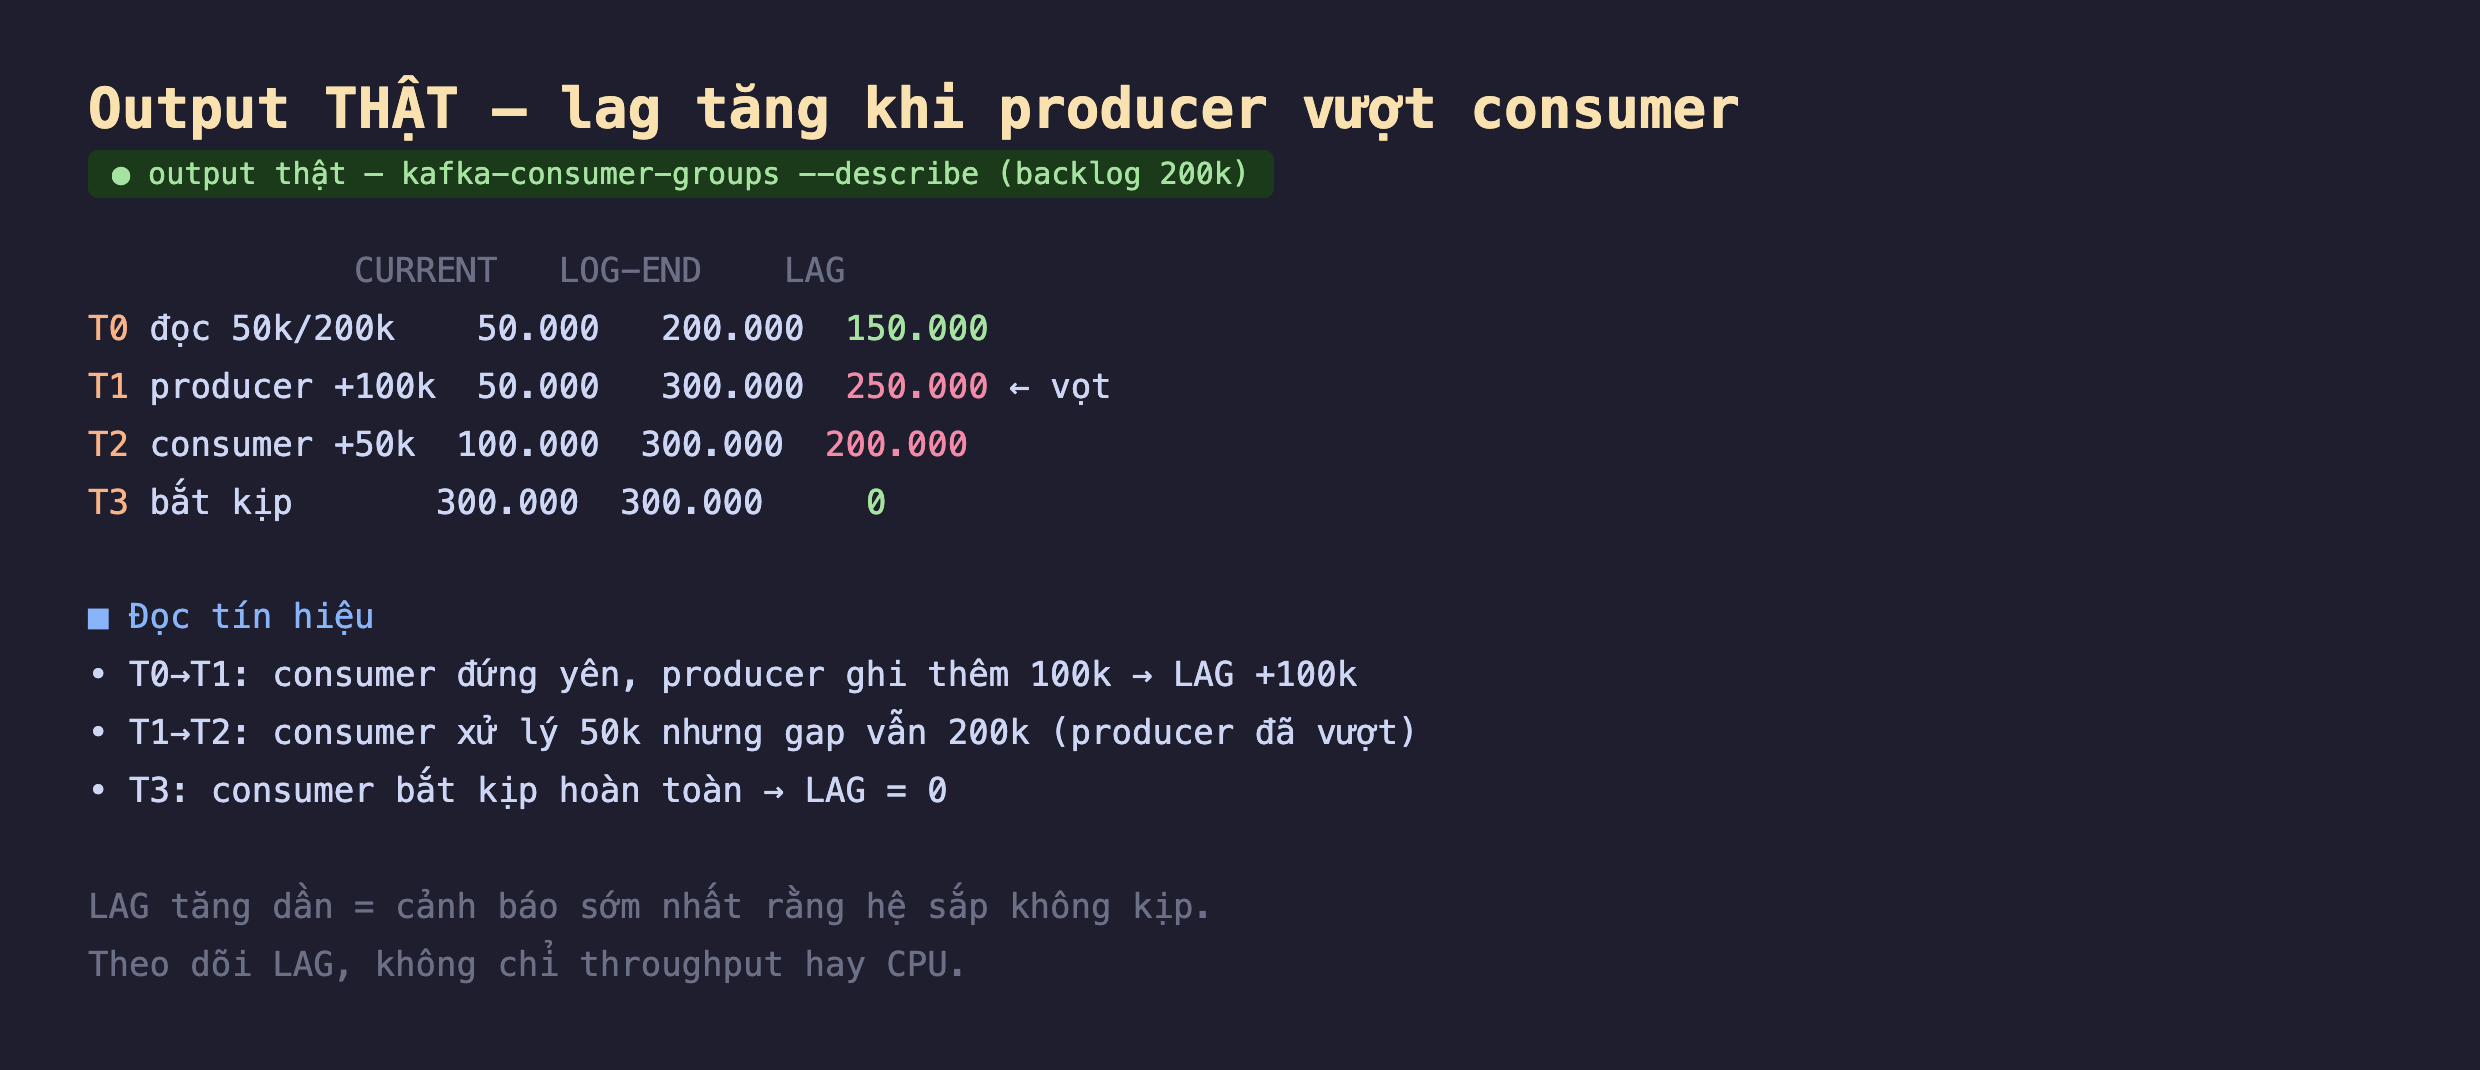
Hình 2: Kết quả thật. T0: consumer đọc 50k/200k → LAG 150.000. T1: producer thêm 100k (LOG-END lên 300.000) → LAG vọt 250.000. T2: consumer đọc thêm 50k → LAG 200.000 (vẫn cao vì producer đã vượt). T3: consumer đọc hết → CURRENT = LOG-END = 300.000, LAG 0 (bắt kịp).
Đọc tiến trình:
- T0 — LAG 150.000: consumer mới xử lý 50.000 của backlog 200.000.
CURRENT=50000, LOG-END=200000, lag = 150.000. Đây là lag "khởi đầu" khi consumer đang gặm dần backlog. - T1 — LAG vọt lên 250.000: producer đẩy thêm 100.000 message (LOG-END lên 300.000) trong khi consumer chưa xử lý thêm. Lag nhảy từ 150.000 lên 250.000 — tăng đúng 100.000. Đây là khoảnh khắc backpressure lộ ra: producer ghi nhanh hơn consumer đọc, và lag phản ánh ngay chênh lệch đó.
- T2 — LAG 200.000: consumer xử lý thêm 50.000 (
CURRENT=100000), lag giảm xuống 200.000. Consumer có làm việc, nhưng vì producer đã vượt lên từ trước, lag vẫn cao. Đây là bài học tinh tế: consumer đang chạy không có nghĩa lag đang giảm — nó chỉ giảm nếu consumer nhanh hơn producer. - T3 — LAG 0: producer dừng, consumer đọc hết phần còn lại →
CURRENT = LOG-END = 300000, lag về 0. Consumer đã bắt kịp hoàn toàn.
Thông điệp cốt lõi: lag là đạo hàm của chênh lệch tốc độ, tích luỹ theo thời gian. Một đợt producer bùng tải (T0→T1) đẩy lag lên ngay, và consumer phải chạy nhanh hơn producer một khoảng thời gian mới kéo lag xuống được. Theo dõi lag, bạn thấy vấn đề trước khi nó thành sự cố người dùng cảm nhận.
Vì sao lag hơn các chỉ số khác
CPU, memory, throughput đều có thể trông ổn khi hệ đang hỏng. Consumer có thể chạy ở CPU 40% mà lag vẫn tăng — vì nút thắt là downstream (DB chậm), không phải CPU. Throughput có thể cao mà vẫn không đủ — vì producer còn cao hơn. Lag là chỉ số duy nhất đo trực tiếp cái bạn thật sự quan tâm: consumer có theo kịp không. Nó là chỉ báo tổng hợp của mọi nút thắt — bất kể nguyên nhân là CPU, DB, mạng hay code chậm, tất cả đều hiện ra thành lag tăng. Đây là lý do mọi hệ Kafka production đều cảnh báo trên lag trước tiên (và liên hệ với bài RED/USE của loạt Observability: lag chính là saturation của consumer).
Đánh đổi cần cân nhắc
Lag tính theo số message, không phải thời gian — và đó có thể gây hiểu nhầm. Lag = 10.000 message nghĩa là gì? Nếu consumer xử lý 10.000 msg/s thì đó là 1 giây trễ (không sao); nếu xử lý 10 msg/s thì đó là ~17 phút trễ (thảm hoạ). Cùng một con số lag, hai mức nghiêm trọng hoàn toàn khác. Nên nhiều hệ theo dõi lag theo thời gian (time lag = lag / consume rate) thay vì lag thô, để biết "dữ liệu đang cũ bao nhiêu phút" — gần với trải nghiệm người dùng hơn.
Lag tăng tạm thời khác lag tăng mãi. Một đợt bùng tải (như T0→T1) làm lag tăng rồi consumer kéo lại được là bình thường — queue sinh ra để hấp thụ đúng kiểu bùng này (bài 1). Cảnh báo nên kích hoạt khi lag tăng liên tục qua nhiều chu kỳ (xu hướng đi lên), không phải mỗi lần có spike — nếu không bạn rơi vào alert fatigue (bài alerting của loạt Observability). Phân biệt "spike rồi hồi" với "tăng không ngừng" là mấu chốt.
Giảm lag: scale consumer có trần, và không phải lúc nào cũng là cách. Khi lag tăng mãi, phản xạ là thêm consumer (bài 3) — nhưng nhớ trần số partition, và nhớ nút thắt có thể ở downstream chứ không ở consumer. Nếu DB chỉ chịu X ghi/s, thêm consumer chỉ dồn tải lên DB. Các cách khác: tăng partition (để scale xa hơn), tối ưu xử lý mỗi message, hoặc batch (xử lý nhiều message một lần). Chọn cách theo nút thắt thật, không mặc định thêm consumer.
Ba ý mang về
- Lag = LOG-END-OFFSET − CURRENT-OFFSET, đo khoảng cách consumer tụt lại: đo thật backlog 200.000 cho lag 150.000 sau khi consumer xử lý 50.000 — lag là số message đã có mà chưa xử lý, chỉ báo trực tiếp "consumer có theo kịp không".
- Lag tăng khi producer vượt consumer, kể cả khi consumer đang chạy: đo thật producer thêm 100.000 đẩy lag từ 150.000 lên 250.000; consumer xử lý thêm 50.000 vẫn còn lag 200.000 — chỉ khi consumer nhanh hơn producer lag mới về 0 (T3).
- Lag là tín hiệu cảnh báo số một, nhưng đọc đúng cách: lag hiện mọi nút thắt (CPU/DB/mạng) mà throughput và CPU che giấu; theo dõi lag theo thời gian và theo xu hướng tăng liên tục (không phải spike), và giảm lag theo nút thắt thật chứ không mặc định thêm consumer.
Nguồn
- Kafka docs — Monitoring consumer lag: https://kafka.apache.org/documentation/#monitoring
- Confluent — Consumer lag & Burrow: https://www.confluent.io/blog/kafka-consumer-lag-monitoring/
- LinkedIn Engineering — Burrow: Kafka consumer lag checking: https://github.com/linkedin/Burrow
Phần sau ta mổ xẻ một đảm bảo hay bị hiểu nhầm: thứ tự message — Kafka chỉ đảm bảo thứ tự trong một partition, và demo thật việc mất thứ tự xảy ra thế nào khi scale ra nhiều partition.
