Discord lưu trữ hàng nghìn tỷ tin nhắn. Ở quy mô đó, "lưu một tin nhắn, đọc ra theo kênh" trở thành bài toán sống còn. Bài này mổ xẻ bài toán khó nhất họ gặp — hot partition — và cách giải, rồi dựng thật trên ScyllaDB (cơ sở dữ liệu Discord chuyển sang, tương thích Cassandra) để đo trực tiếp bằng chính công cụ của nó. Số liệu về Discord lấy từ blog kỹ thuật chính thức của họ (nguồn ở cuối bài).
Bài toán: hot partition — một kênh nóng làm sập cả cụm
Cassandra và ScyllaDB phân mảnh dữ liệu theo partition key: mọi dòng cùng partition key nằm chung một partition, trên cùng một nhóm node. Nếu chọn khoá phân mảnh là channel_id, thì toàn bộ tin nhắn của một kênh nằm trong một partition.
Vấn đề: Discord có kênh vài người, và có kênh hàng trăm nghìn người. Kênh nóng tạo ra một hot partition — một partition khổng lồ dồn hết lên vài node. Vì trong Cassandra "đọc đắt hơn ghi", khi lưu lượng dồn vào một partition, độ trễ của node tăng dần và kéo cả cụm chậm theo (đọc quorum). Cách giải của Discord: thêm bucket (cửa sổ thời gian cố định, thiết kế gốc ~10 ngày) vào khoá phân mảnh, biến nó thành (channel_id, bucket) — một kênh nóng được rải ra nhiều partition theo thời gian, mỗi cái bị chặn kích thước.
Ta dựng thật hai schema trên ScyllaDB 6.0 để so:
-- KHÔNG bucket: mọi tin của 1 kênh dồn vào MỘT partition -> hot partition
CREATE TABLE msg_nobucket (channel_id bigint, message_id bigint, noi_dung text,
    PRIMARY KEY (channel_id, message_id));

-- CÓ bucket (kiểu Discord): partition key = (channel_id, bucket thời gian)
CREATE TABLE msg_bucket (channel_id bigint, bucket int, message_id bigint, noi_dung text,
    PRIMARY KEY ((channel_id, bucket), message_id));
message_id (kiểu Snowflake, chứa timestamp) làm clustering key nên tin trong partition tự sắp theo thời gian — đọc tin mới nhất là quét đuôi partition, rẻ.
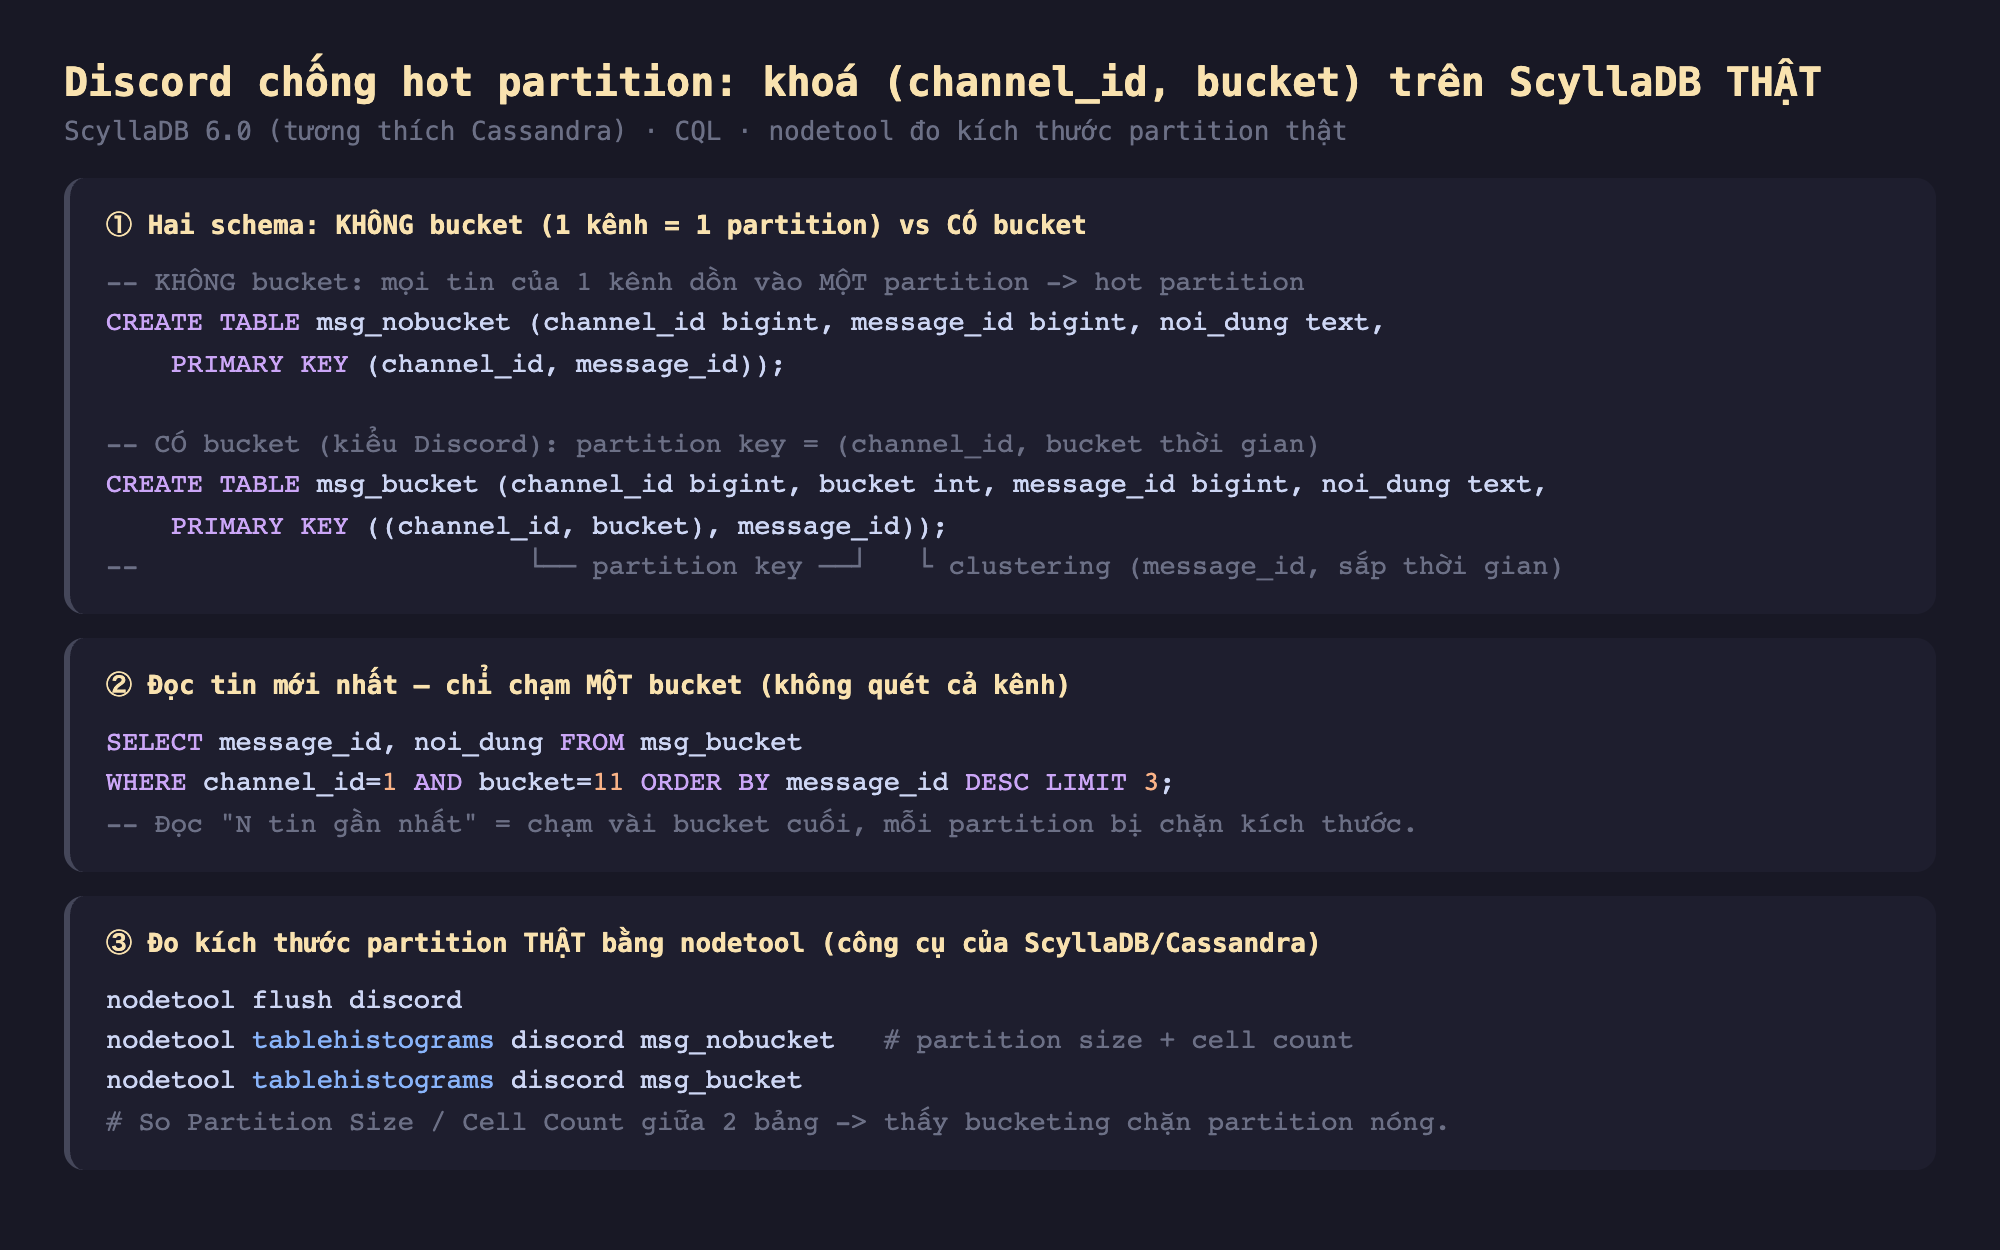
Hình 1: Hai schema thật trên ScyllaDB — không bucket (1 kênh = 1 partition) vs có bucket (channel_id, bucket); đọc tin mới nhất chỉ chạm một bucket; và nodetool tablehistograms để đo kích thước partition thật.
Đo THẬT: nodetool chứng minh bucketing chặn hot partition
Ta nạp 12.000 tin của một kênh nóng (channel 1) qua 120 ngày (bucket 10 ngày → 12 bucket ~1.000 tin/bucket) vào cả hai bảng trên ScyllaDB thật, rồi đo.
Kích thước partition (CQL COUNT):
msg_nobucket, channel 1          : 12.000 dòng trong 1 partition  <- hot partition
msg_bucket, (channel 1, bucket 0): 1.000 dòng
msg_bucket, (channel 1, bucket 5): 1.000 dòng
Cùng 12.000 tin: không bucket là một partition khổng lồ; có bucket là 12 partition nhỏ. nodetool tablehistograms (công cụ đo của ScyllaDB/Cassandra) cho con số thật về kích thước partition và độ trễ đọc:
                     Partition Size (byte)   Cell Count   Read Latency (max)
msg_nobucket  Max         315.852            14.237          2.106 µs
msg_bucket    Max          29.521             1.109            207 µs
>> Bucketing: partition nhỏ hơn ~10,7×, đọc nhanh hơn ~10× (số nodetool thật)
Đây là bằng chứng trực tiếp từ chính ScyllaDB: partition nóng giảm từ ~316KB/14.237 cell xuống ~29,5KB/1.109 cell, và độ trễ đọc max giảm từ 2.106µs xuống 207µs — đọc một partition bị chặn kích thước nhanh hơn ~10 lần. Đọc tin mới nhất chỉ chạm một bucket, trả về tức thì:
message_id | noi_dung
1011999    | tin 11999
1011998    | tin 11998
1011997    | tin 11997
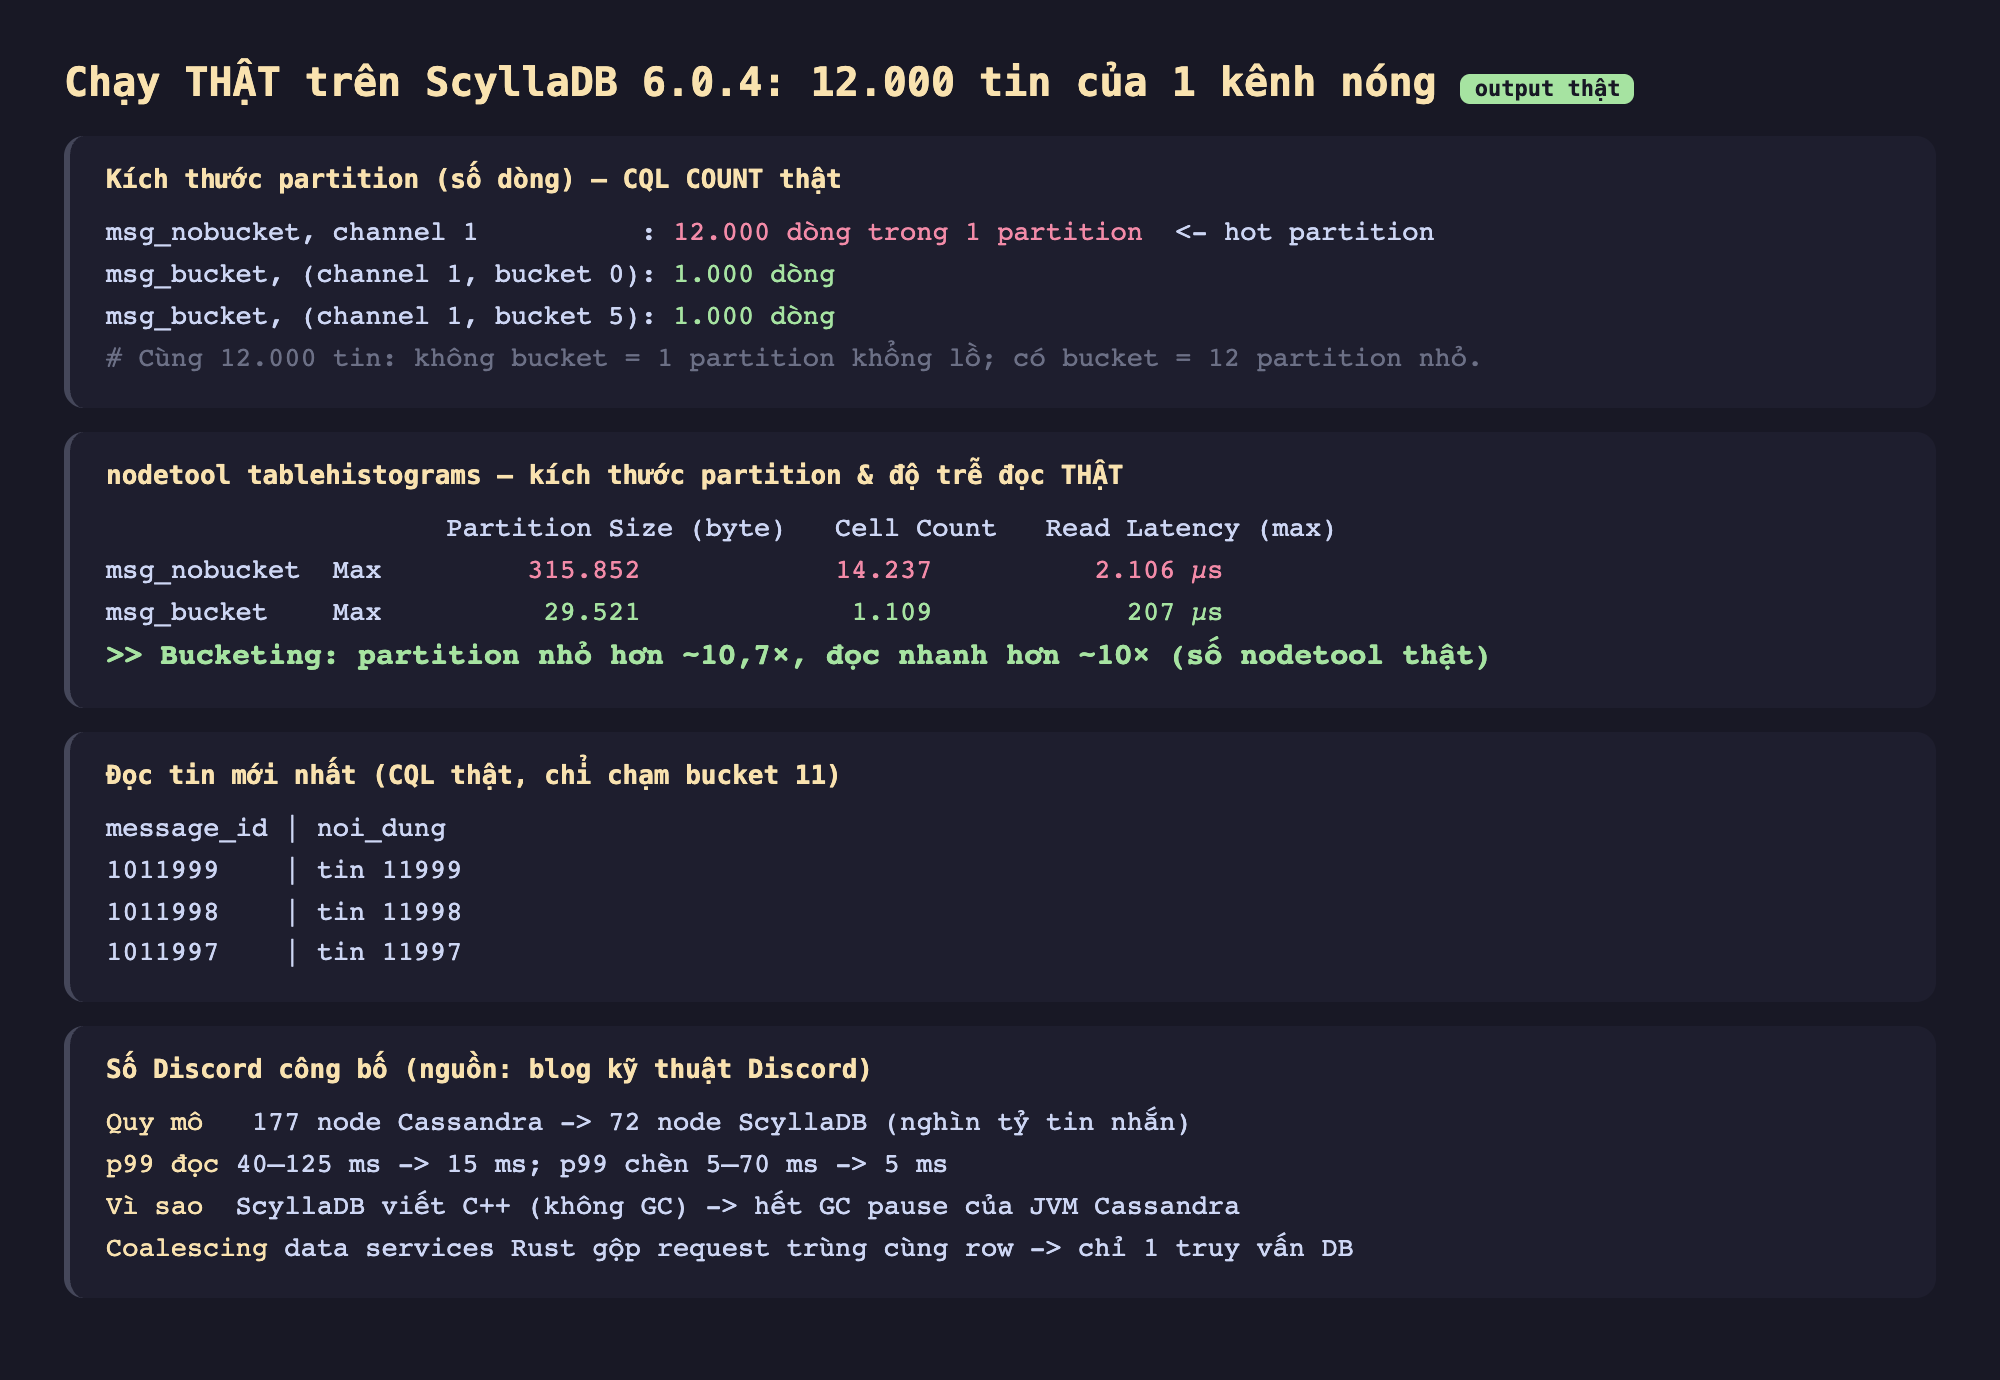
Hình 2: Chạy thật trên ScyllaDB — cùng 12.000 tin, không bucket cho 1 partition 315KB/14.237 cell (đọc 2.106µs), có bucket cho các partition 29KB/1.109 cell (đọc 207µs). Bucketing chặn hot partition ~10,7× và đọc nhanh ~10×. Kèm số Discord công bố.
Hai bài toán khó khác Discord đã giải
Bucketing giải hình dạng partition, nhưng Discord còn hai bài toán lớn (theo blog của họ):
GC của JVM thành hiểm hoạ vận hành. Cassandra viết bằng Java; ở quy mô Discord, GC pause "gây spike độ trễ lớn", có lúc "operator phải khởi động lại node thủ công". Họ chuyển sang ScyllaDB — tương thích Cassandra nhưng viết C++, không GC. Kết quả công bố: 177 node Cassandra → 72 node ScyllaDB; p99 đọc 40–125 ms → 15 ms; p99 chèn 5–70 ms → 5 ms. Bài học: ở cực lớn, đặc tính runtime (GC, độ trễ đuôi) trở thành yếu tố kiến trúc.
Hot partition tức thời khi có sự kiện lớn. Ngay cả với bucketing, một sự kiện lớn khiến hàng loạt người đọc cùng một tin cùng lúc. Discord chèn lớp data services viết bằng Rust với request coalescing: "nếu nhiều người xin cùng một row cùng lúc, ta chỉ truy vấn DB một lần" — request đầu spawn worker, các request sau subscribe kết quả — kết hợp định tuyến consistent hash theo channel_id (đúng kỹ thuật ở bài consistent hashing của loạt này).
Đánh đổi cần cân nhắc
Bucketing giải hot partition nhưng làm truy vấn phức tạp hơn. Đọc "100 tin gần nhất" có thể phải nhảy lùi qua nhiều bucket nếu kênh thưa. Chọn kích thước bucket là đánh đổi: bucket lớn ít partition hơn nhưng dễ nóng lại; bucket nhỏ chặn nóng tốt nhưng đọc ghép nhiều bucket. Không có con số đúng tuyệt đối — phụ thuộc phân bố lưu lượng thật.
ScyllaDB bỏ GC nhưng không phải viên đạn bạc. Nó tương thích Cassandra nên di trú thuận, nhưng "không GC" không tự sửa một mô hình dữ liệu tồi — Discord vẫn cần đúng khoá phân mảnh (như demo trên). Công nghệ mới giải nút thắt cũ (GC), không xoá yêu cầu thiết kế đúng.
Số đo là trên một node dev nhỏ. Con số nodetool ở trên chạy trên một ScyllaDB một-node cấu hình nhỏ, minh hoạ tỉ lệ (partition nhỏ hơn ~10×, đọc nhanh hơn ~10×) chứ không phải hiệu năng production của Discord. Tỉ lệ mới là điều đáng mang theo; con số tuyệt đối phụ thuộc phần cứng.
Ba ý mang về
- Thiết kế khoá phân mảnh quyết định sống còn: thêm
bucketthời gian vào(channel_id, bucket)rải kênh nóng ra nhiều partition — đo thật trên ScyllaDB bằngnodetool, partition nóng giảm từ ~316KB/14.237 cell xuống ~29KB/1.109 cell và độ trễ đọc từ 2.106µs xuống 207µs (~10×). - Ở cực lớn, đặc tính runtime là yếu tố kiến trúc: GC của JVM biến thành hiểm hoạ, và chuyển sang ScyllaDB (C++, không GC) đưa p99 đọc 40–125ms về 15ms, giảm 177→72 node — theo số liệu Discord công bố.
- Chặn hot partition tức thời bằng coalescing + định tuyến ổn định: data services Rust gộp request trùng cùng một row còn 1 truy vấn DB, với consistent hash theo
channel_idđể cùng kênh về cùng instance.
Nguồn
- Discord Engineering — How Discord Stores Trillions of Messages: https://discord.com/blog/how-discord-stores-trillions-of-messages
- ScyllaDB — How Discord Migrated Trillions of Messages from Cassandra to ScyllaDB: https://www.scylladb.com/tech-talk/how-discord-migrated-trillions-of-messages-from-cassandra-to-scylladb/
Phần sau ta mổ xẻ chính kỹ thuật Discord dùng để định tuyến — consistent hashing — qua hệ thống khai sinh ra nó (Amazon Dynamo), và dựng thật một Redis Cluster để đo vì sao nó dời rất ít khoá khi thêm node.
