Bài trước ta học đọc assembly Plan 9. Bài này ta viết một hàm assembly từ đầu — khai báo, cài đặt, chạy thật. Nhưng câu hỏi quan trọng hơn "làm sao viết" là "khi nào nên viết". Và câu trả lời trung thực, có đo đạc, khác với kỳ vọng của nhiều người: với hầu hết code, viết assembly thủ công lỗ, không lãi. Bài này chỉ cả hai — cách viết đúng, và vì sao thường không đáng.
Cấu trúc: khai báo Go + cài đặt .s
Một hàm assembly gồm hai nửa. Nửa Go: khai báo hàm không có thân trong file .go — chỉ chữ ký, báo compiler biết cài đặt nằm nơi khác:
// lib.go
package main

func Cong(a, b int64) int64   // không thân → cài đặt ở lib_arm64.s
Nửa assembly: cài đặt trong file .s cùng package, tên file có hậu tố kiến trúc (_arm64.s, _amd64.s) để build đúng CPU:
// lib_arm64.s
#include "textflag.h"

// func Cong(a, b int64) int64
TEXT ·Cong(SB), NOSPLIT, $0-24
	MOVD a+0(FP), R0     // R0 = a  (tham số 1 tại offset 0)
	MOVD b+8(FP), R1     // R1 = b  (tham số 2 tại offset 8)
	ADD  R1, R0, R0      // R0 = a + b
	MOVD R0, ret+16(FP)  // ghi kết quả tại offset 16
	RET
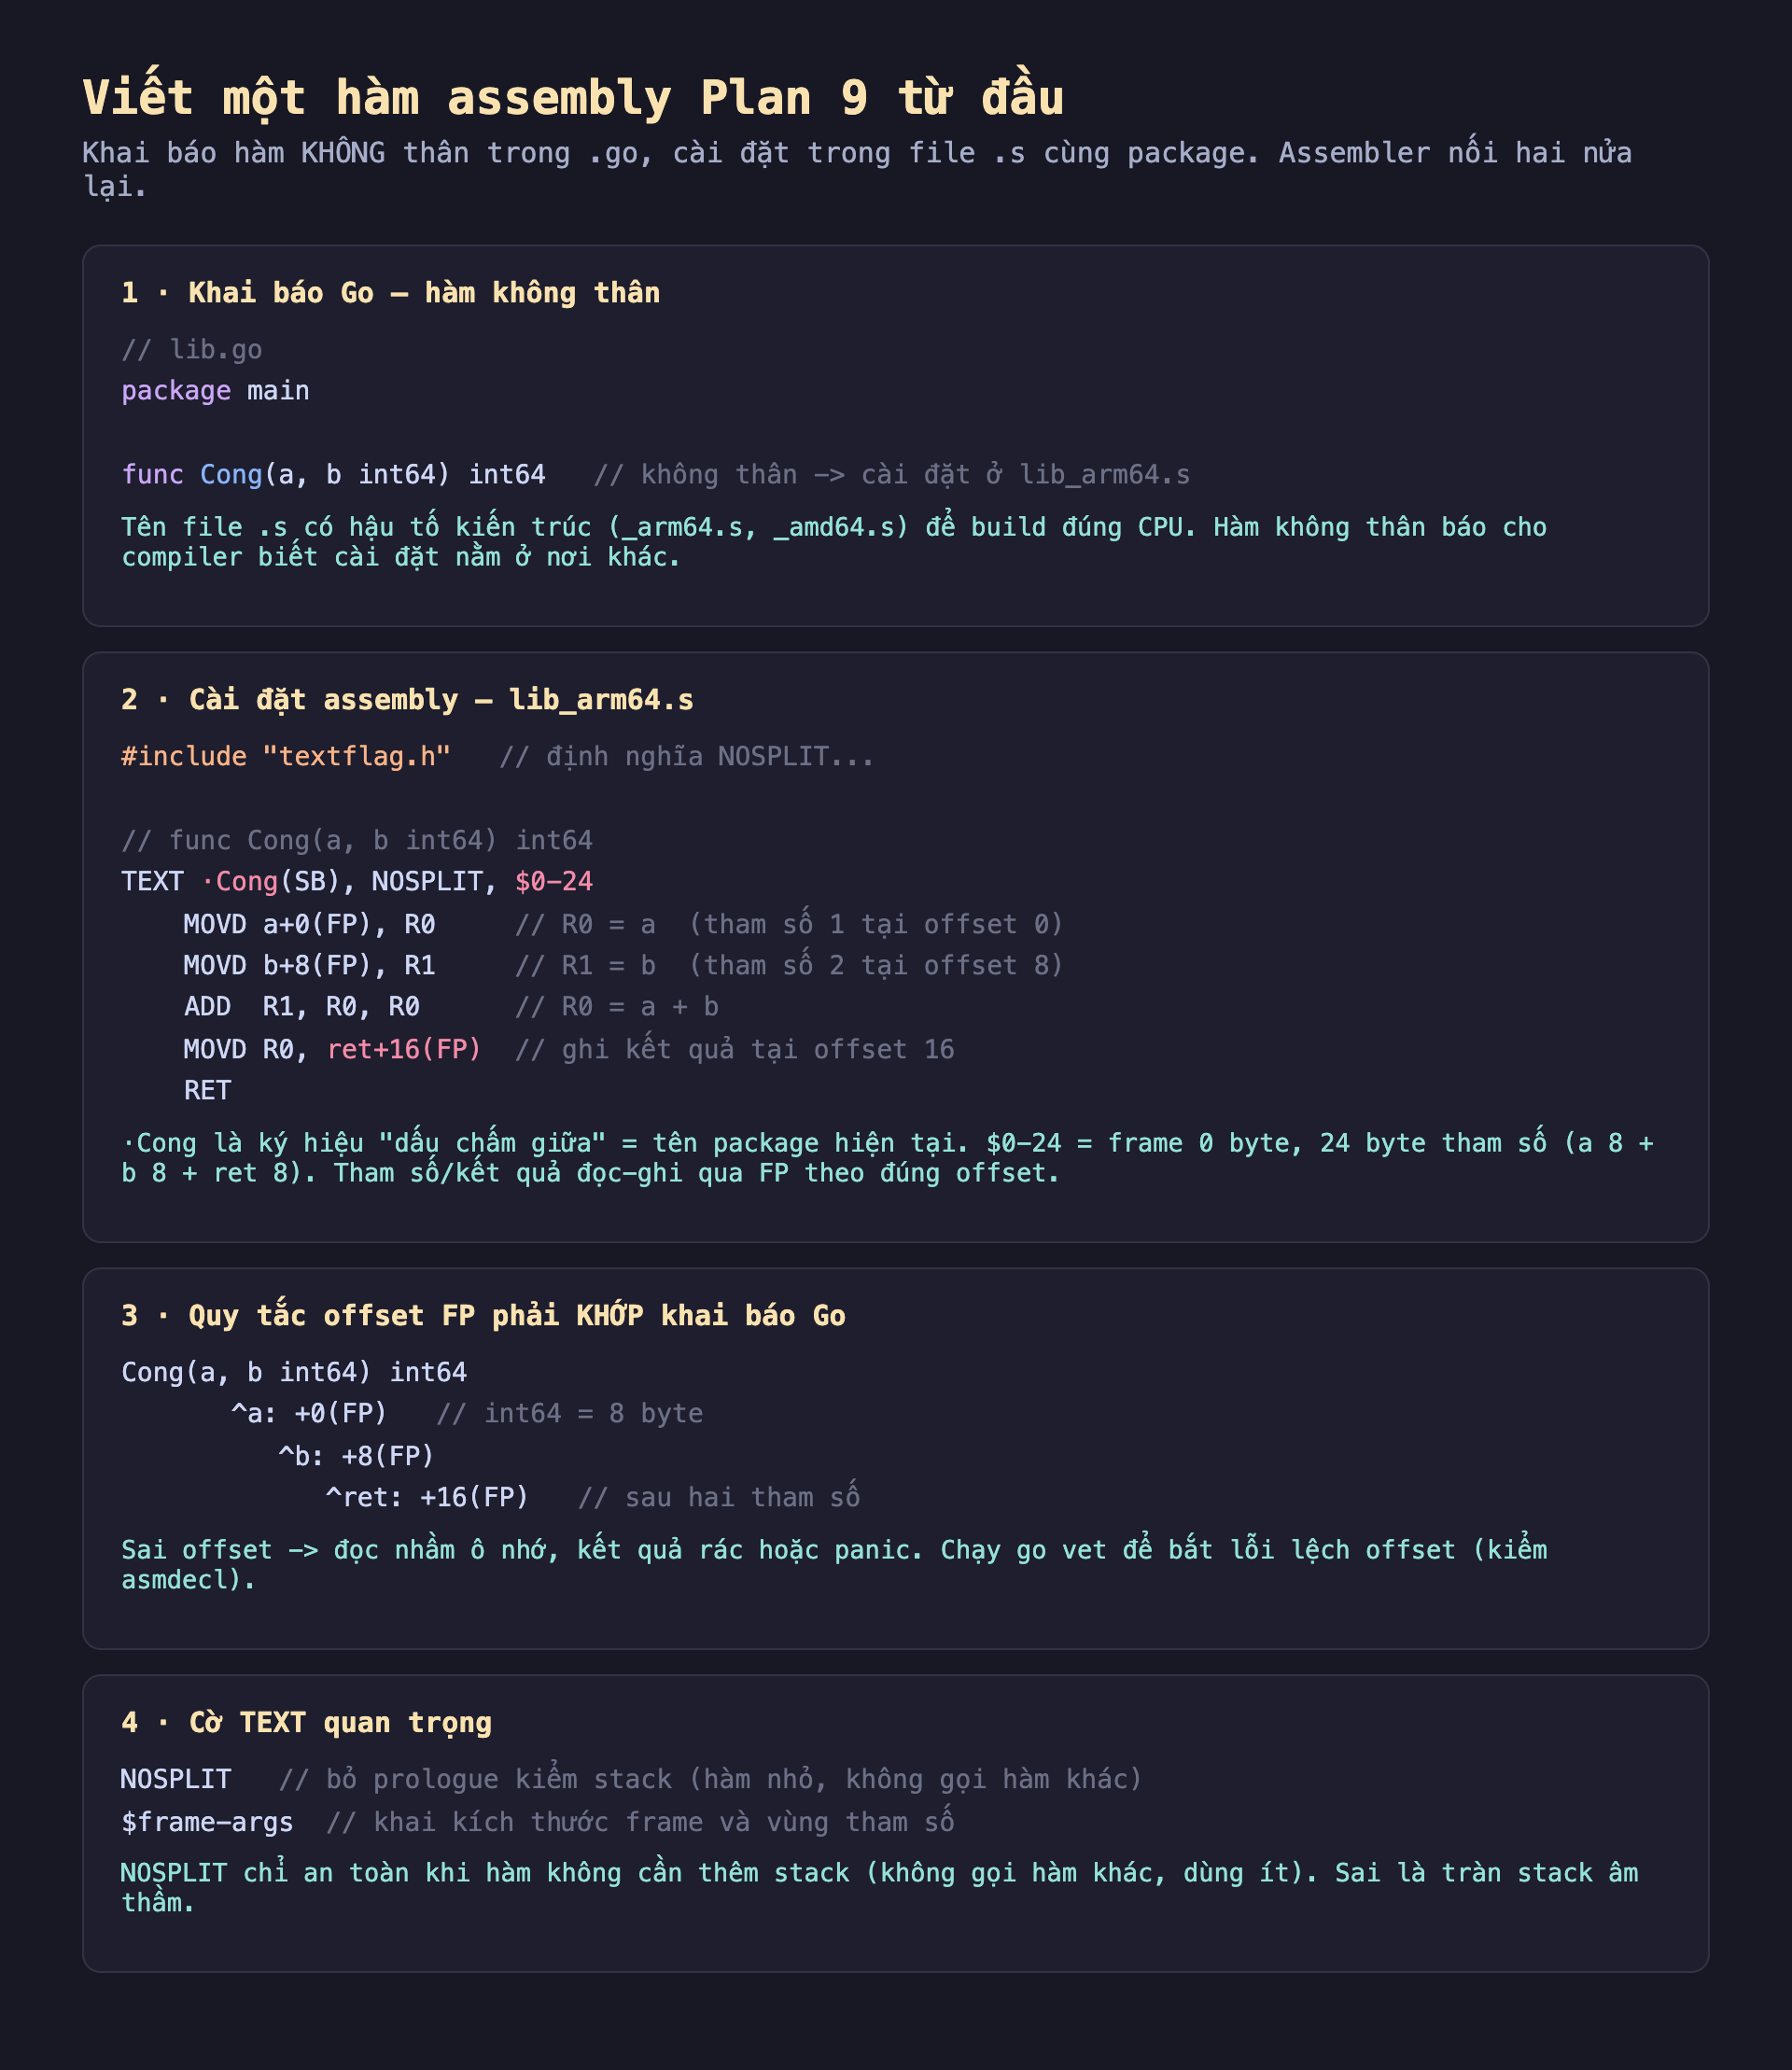
Hình 1: Cấu trúc một hàm assembly. ·Cong là tên package hiện tại; $0-24 là frame 0 byte, tham số 24 byte; tham số/kết quả đọc-ghi qua FP theo offset khớp khai báo Go.
Ba quy tắc phải nhớ
·Name (dấu chấm giữa) = tên package hiện tại. Ký tự · (middle dot, U+00B7) trước tên hàm nghĩa là "hàm này thuộc package đang biên dịch". TEXT ·Cong(SB) khai hàm Cong của package hiện tại.
$frame-args khai kích thước. $0-24 nghĩa là frame cục bộ 0 byte, vùng tham số 24 byte. Với Cong(a, b int64) int64: a (8) + b (8) + ret (8) = 24.
Offset FP phải khớp khai báo Go. a+0(FP), b+8(FP), ret+16(FP) — mỗi int64 là 8 byte, xếp liên tiếp, kết quả nằm sau các tham số. Sai offset là đọc nhầm ô nhớ → kết quả rác hoặc panic. Chạy go vet để bắt lỗi lệch offset (nó có bộ kiểm asmdecl đối chiếu .s với khai báo Go).
Chạy thật: nó hoạt động
Đo thật, gọi từ Go như hàm thường:
Cong(3, 4)        -> 7       // 3 + 4
NhanDoiCong1(10)  -> 21      // 10*2 + 1
Hàm assembly biên dịch và chạy đúng. Nhưng câu hỏi thật là: có đáng không?
Đo trung thực: hàm nhỏ thường lỗ
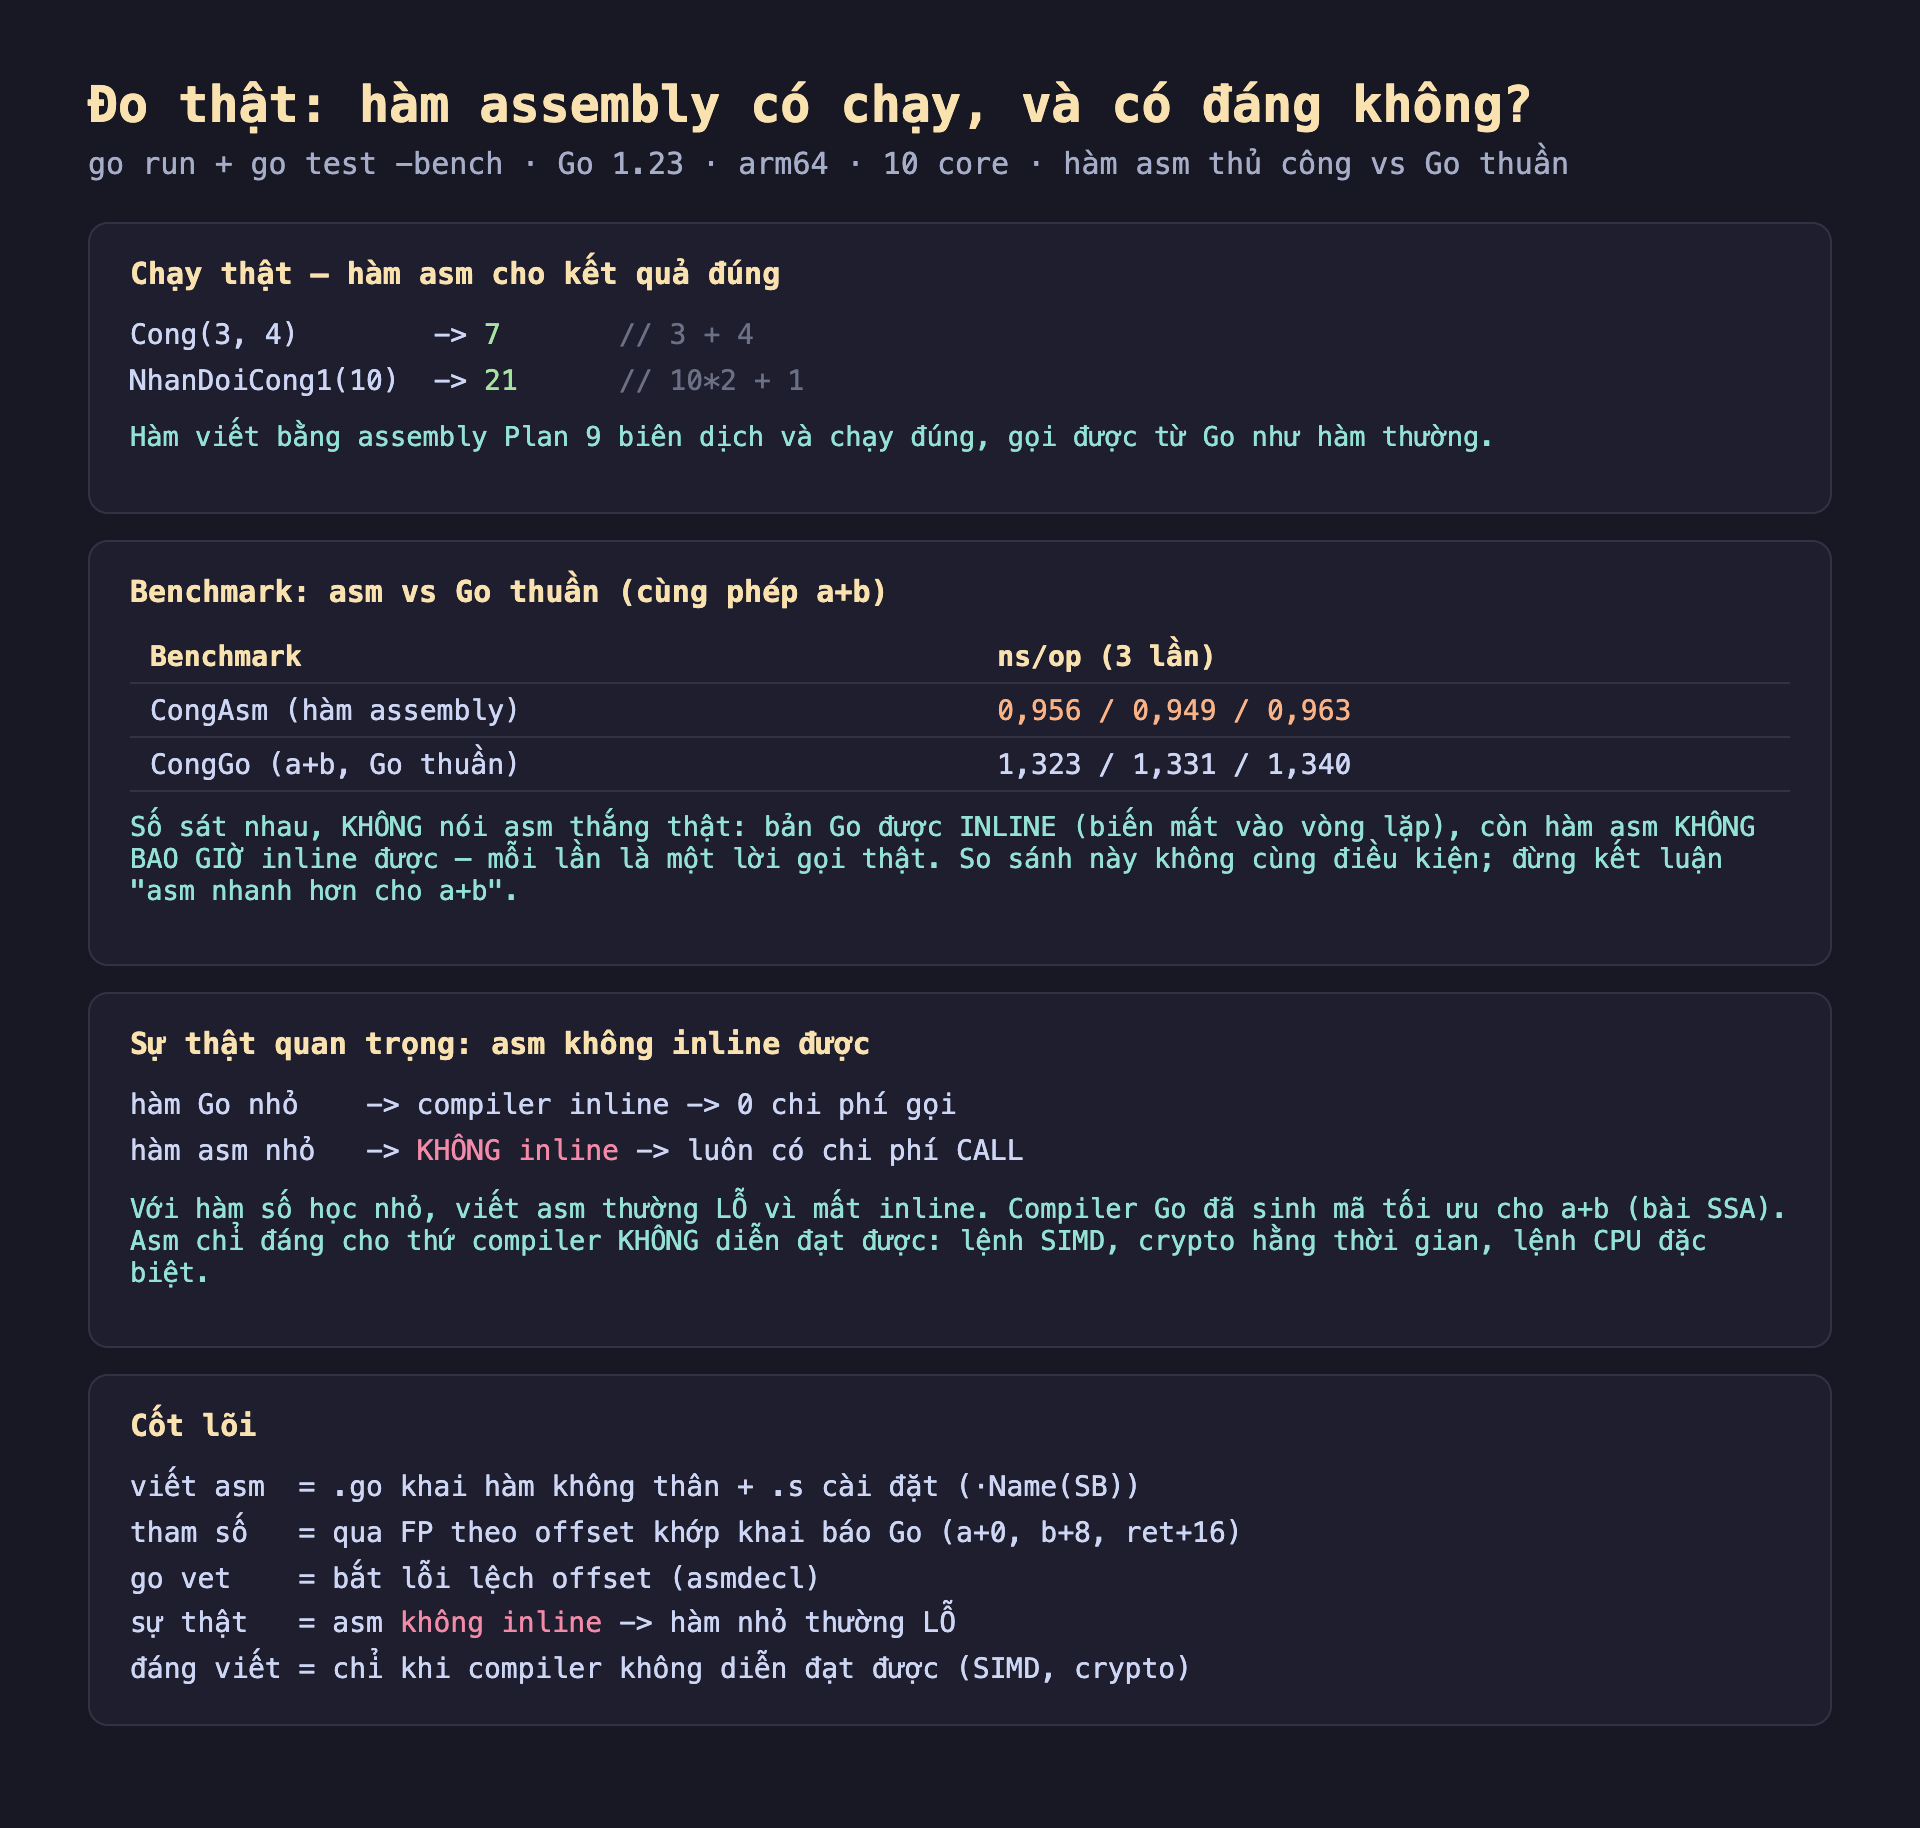
Hình 2: Hàm asm chạy đúng (7, 21). Benchmark CongAsm 0,956 ns vs CongGo 1,323 ns — số sát nhau nhưng KHÔNG so cùng điều kiện: bản Go inline, hàm asm không bao giờ inline.
Benchmark Cong (asm) với CongGo (Go thuần a+b): CongAsm 0,956 ns, CongGo 1,323 ns. Nhìn thì asm nhanh hơn — nhưng đây là so sánh không cùng điều kiện và không được kết luận "asm nhanh hơn cho a+b":
- Bản Go
CongGođược inline — nó biến mất vào vòng lặp benchmark, compiler tối ưu cả khối. - Hàm asm
Congkhông bao giờ inline được — mỗi lần gọi là mộtCALLthật.
Sự thật cốt lõi: hàm assembly không inline được. Với một hàm số học nhỏ, đây thường là lỗ ròng — bạn mất inline (thứ đã đo ~2,7x lợi ở bài trước) để đổi lấy... không gì cả, vì compiler Go đã sinh mã tối ưu cho a+b. Con số benchmark sát nhau ở đây là do đặc thù vòng lặp, không phản ánh lợi ích thật.
Khi nào thực sự đáng viết assembly
Assembly chỉ đáng khi bạn cần thứ compiler không diễn đạt được:
Lệnh SIMD (vector). Xử lý nhiều phần tử một lúc (AVX2, NEON) — compiler Go không tự động vector hóa mạnh, nên crypto/nén/xử lý ảnh dùng asm SIMD để nhanh gấp nhiều lần. Đây là lý do phổ biến nhất trong thư viện chuẩn (crypto/*, hash/*).
Crypto hằng thời gian. Code mật mã cần không rẽ nhánh theo dữ liệu bí mật để chống tấn công thời gian. Assembly cho kiểm soát chính xác từng lệnh, đảm bảo hằng thời gian mà code cấp cao khó bảo đảm.
Lệnh CPU đặc biệt. Đọc bộ đếm chu kỳ (RDTSC), lệnh mã hóa phần cứng (AES-NI), popcount, CRC — những lệnh mà Go không expose qua hàm chuẩn.
Đánh đổi cần cân nhắc
Assembly làm code không portable và khó bảo trì. Mỗi kiến trúc cần một file .s riêng (_amd64.s, _arm64.s...). Quên một kiến trúc là build lỗi ở đó. Code asm khó đọc, khó sửa, dễ sai — mỗi dòng phải tự lo đúng đắn mà compiler không kiểm hộ. Chỉ trả cái giá này khi lợi ích thật sự lớn.
Compiler ngày càng giỏi, xói mòn lợi thế asm. Nhiều tối ưu từng phải viết asm giờ compiler tự làm (PGO, autovectorization đang cải thiện). Code asm viết hôm nay có thể chậm hơn code Go sau vài phiên bản khi compiler bắt kịp — mà asm thì không tự hưởng cải tiến compiler.
Luôn đo, và luôn có bản Go dự phòng. Nếu viết asm, giữ một bản Go thuần (qua build tag) làm chuẩn đối chiếu và dự phòng cho kiến trúc chưa có asm. Đo trên phần cứng thật, trên khối lượng thật — nhiều lần "tối ưu asm" hóa ra chậm hơn bản Go khi đo đúng cách.
Ba ý mang về
- Viết hàm assembly = khai báo Go không thân + cài đặt trong
.scùng package: dùng·Name(SB), đọc-ghi tham số qua FP theo offset khớp khai báo (a+0,b+8,ret+16), và chạygo vetđể bắt lỗi lệch offset (asmdecl) — đo thật hàm asm chạy đúng, gọi được như hàm Go thường. - Hàm assembly không bao giờ inline được, nên với hàm nhỏ thường lỗ ròng: benchmark asm vs Go sát nhau nhưng không cùng điều kiện (Go inline, asm không) — compiler đã sinh mã tối ưu cho số học đơn giản, viết asm chỉ mất inline.
- Assembly chỉ đáng cho thứ compiler không diễn đạt được: lệnh SIMD, crypto hằng thời gian, lệnh CPU đặc biệt — không phải để "tối ưu" số học thường; luôn giữ bản Go dự phòng và đo trên phần cứng/khối lượng thật.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho khai báo Go và cài đặt assembly sau, giải thích ý nghĩa của $0-24 và tại sao tổng là 24 chứ không phải con số khác.
func Cong(a, b int64) int64
TEXT ·Cong(SB), NOSPLIT, $0-24
	MOVD a+0(FP), R0
	MOVD b+8(FP), R1
	ADD  R1, R0, R0
	MOVD R0, ret+16(FP)
	RET
Đáp án
$0-24 khai kích thước frame: số đầu (0) là kích thước frame cục bộ (không có biến cục bộ trên stack), số sau (24) là tổng kích thước vùng tham số + giá trị trả về. Với chữ ký Cong(a, b int64) int64: mỗi int64 chiếm 8 byte, gồm a (8) + b (8) + giá trị trả về ret (8) = 24 byte, khớp với offset dùng trong code (a+0, b+8, ret+16).
Bài 2 (sửa lỗi). Đoạn assembly sau định cộng hai int64 nhưng có lỗi offset FP khiến kết quả sai. Tìm và sửa lỗi.
func Nhan(a, b int64) int64
TEXT ·Nhan(SB), NOSPLIT, $0-24
	MOVD a+0(FP), R0
	MOVD b+0(FP), R1
	MUL  R1, R0, R0
	MOVD R0, ret+8(FP)
	RET
Đáp án
Hai lỗi offset: (1) b+0(FP) phải là b+8(FP) — vì a chiếm 8 byte đầu (offset 0), b là tham số thứ hai nên nằm ở offset 8, không phải trùng offset với a. (2) ret+8(FP) phải là ret+16(FP) — kết quả trả về nằm ngay sau hai tham số 8 byte (a và b), tức offset 16, không phải 8. Bản sửa đúng:
TEXT ·Nhan(SB), NOSPLIT, $0-24
	MOVD a+0(FP), R0
	MOVD b+8(FP), R1
	MUL  R1, R0, R0
	MOVD R0, ret+16(FP)
	RET
Bài viết cũng nhắc: chạy go vet (kiểm asmdecl) để tự động bắt các lỗi lệch offset kiểu này.
Bài 3 (đọc hiểu ký hiệu). Ký hiệu · (middle dot) trong TEXT ·Cong(SB) có ý nghĩa gì? Nếu package của bạn tên là mylib thay vì main, dòng TEXT có cần đổi thành TEXT mylib.Cong(SB) không?
Đáp án
· (middle dot, U+00B7) đứng trước tên hàm nghĩa là "hàm này thuộc package đang được biên dịch" — assembler tự thay nó bằng tên package thật lúc build. Vì vậy không cần đổi thành mylib.Cong(SB) thủ công; viết ·Cong(SB) là đủ và đúng cho mọi package, đây chính là lý do dùng ký hiệu này thay vì ghi cứng tên package.
Bài 4 (bẫy/đánh đổi — trọng tâm bài). Bài đo benchmark: CongAsm (hàm assembly viết tay) 0,956 ns/op, CongGo (hàm Go thuần a+b) 1,323 ns/op. Nhìn qua có vẻ asm nhanh hơn. Giải thích vì sao đây không phải bằng chứng cho việc "viết assembly tay luôn nhanh hơn Go", và nêu đúng cơ chế compiler đứng sau sự thật ngược lại.
Đáp án
So sánh này không cùng điều kiện: hàm CongGo đủ nhỏ nên được compiler inline vào vòng lặp benchmark — nó "biến mất", và compiler tối ưu tiếp cả khối (giữ giá trị trong thanh ghi, gập hằng...). Ngược lại, hàm assembly viết tay không bao giờ được inline — mỗi lần gọi luôn là một CALL thật, tốn chi phí gọi hàm. Sự thật cốt lõi là: với một phép tính số học nhỏ như a+b, compiler Go đã tự sinh mã tối ưu qua inline, nên viết asm ở đây thường là lỗ ròng — bạn đánh mất lợi ích inline (đã đo ~2,7 lần ở bài về inlining) mà không đổi lại được gì.
Bài 5 (vận dụng thực tế). Liệt kê ba trường hợp mà bài viết cho là thực sự đáng viết assembly thủ công, và giải thích ngắn tại sao compiler không tự làm được những việc đó.
Đáp án
(1) Lệnh SIMD/vector (AVX2, NEON) — xử lý nhiều phần tử cùng lúc; compiler Go không tự động vector hóa mạnh nên crypto/nén/xử lý ảnh cần asm để tận dụng phần cứng. (2) Crypto hằng thời gian — code mật mã cần không rẽ nhánh theo dữ liệu bí mật để chống tấn công thời gian (timing attack); assembly cho kiểm soát chính xác từng lệnh mà code cấp cao khó đảm bảo được. (3) Lệnh CPU đặc biệt — như đọc bộ đếm chu kỳ (RDTSC), lệnh mã hóa phần cứng (AES-NI), popcount, CRC — những lệnh mà Go không expose qua hàm chuẩn nào, nên buộc phải viết trực tiếp bằng assembly để gọi tới chúng.
Phần sau ta quay lại tầng cao hơn, tập hợp các "công tắc" điều khiển compiler đã gặp rải rác: Phần sau tổng hợp các compiler directive //go: — noinline, nosplit, noescape, linkname, embed và bạn bè — mỗi cái làm gì, khi nào dùng, và cái nào nguy hiểm.
