Mấy bài vừa rồi ta thấy compiler làm đủ thứ phép màu: inline, devirtualize, xoá mã chết, xoá kiểm biên. Nhưng tất cả xảy ra ở đâu? Câu trả lời là SSA — Static Single Assignment, biểu diễn trung gian mà compiler Go dùng để "suy nghĩ" về code. Và điều tuyệt vời: bạn xem được từng bước bằng một biến môi trường. Bài này mổ xẻ SSA bằng công cụ thật, đi qua các pha, và thấy một hàm co lại thế nào.
SSA là gì và vì sao "single assignment"
SSA là dạng biểu diễn code mà mỗi biến chỉ được gán đúng một lần. Thay vì x bị ghi đè nhiều lần, mỗi lần gán tạo một "value" mới (v1, v2...). Điều này khiến compiler dễ suy luận: mỗi value có một nguồn duy nhất, nên phân tích luồng dữ liệu (biến này từ đâu ra, có ai dùng không) trở nên đơn giản. Đó là nền tảng cho mọi tối ưu.
SSA của Go dùng các "op" có kiểu và độc lập kiến trúc ở giai đoạn đầu:
Arg        // tham số a, b
Add64      // phép cộng 64-bit (generic, chưa gắn CPU cụ thể)
Mul64      // phép nhân 64-bit
Const64    // hằng số
MakeResult // giá trị trả về
Chỉ đến pha lower gần cuối, các op generic này mới đổi thành lệnh CPU thật (ADD, MUL của arm64/amd64).
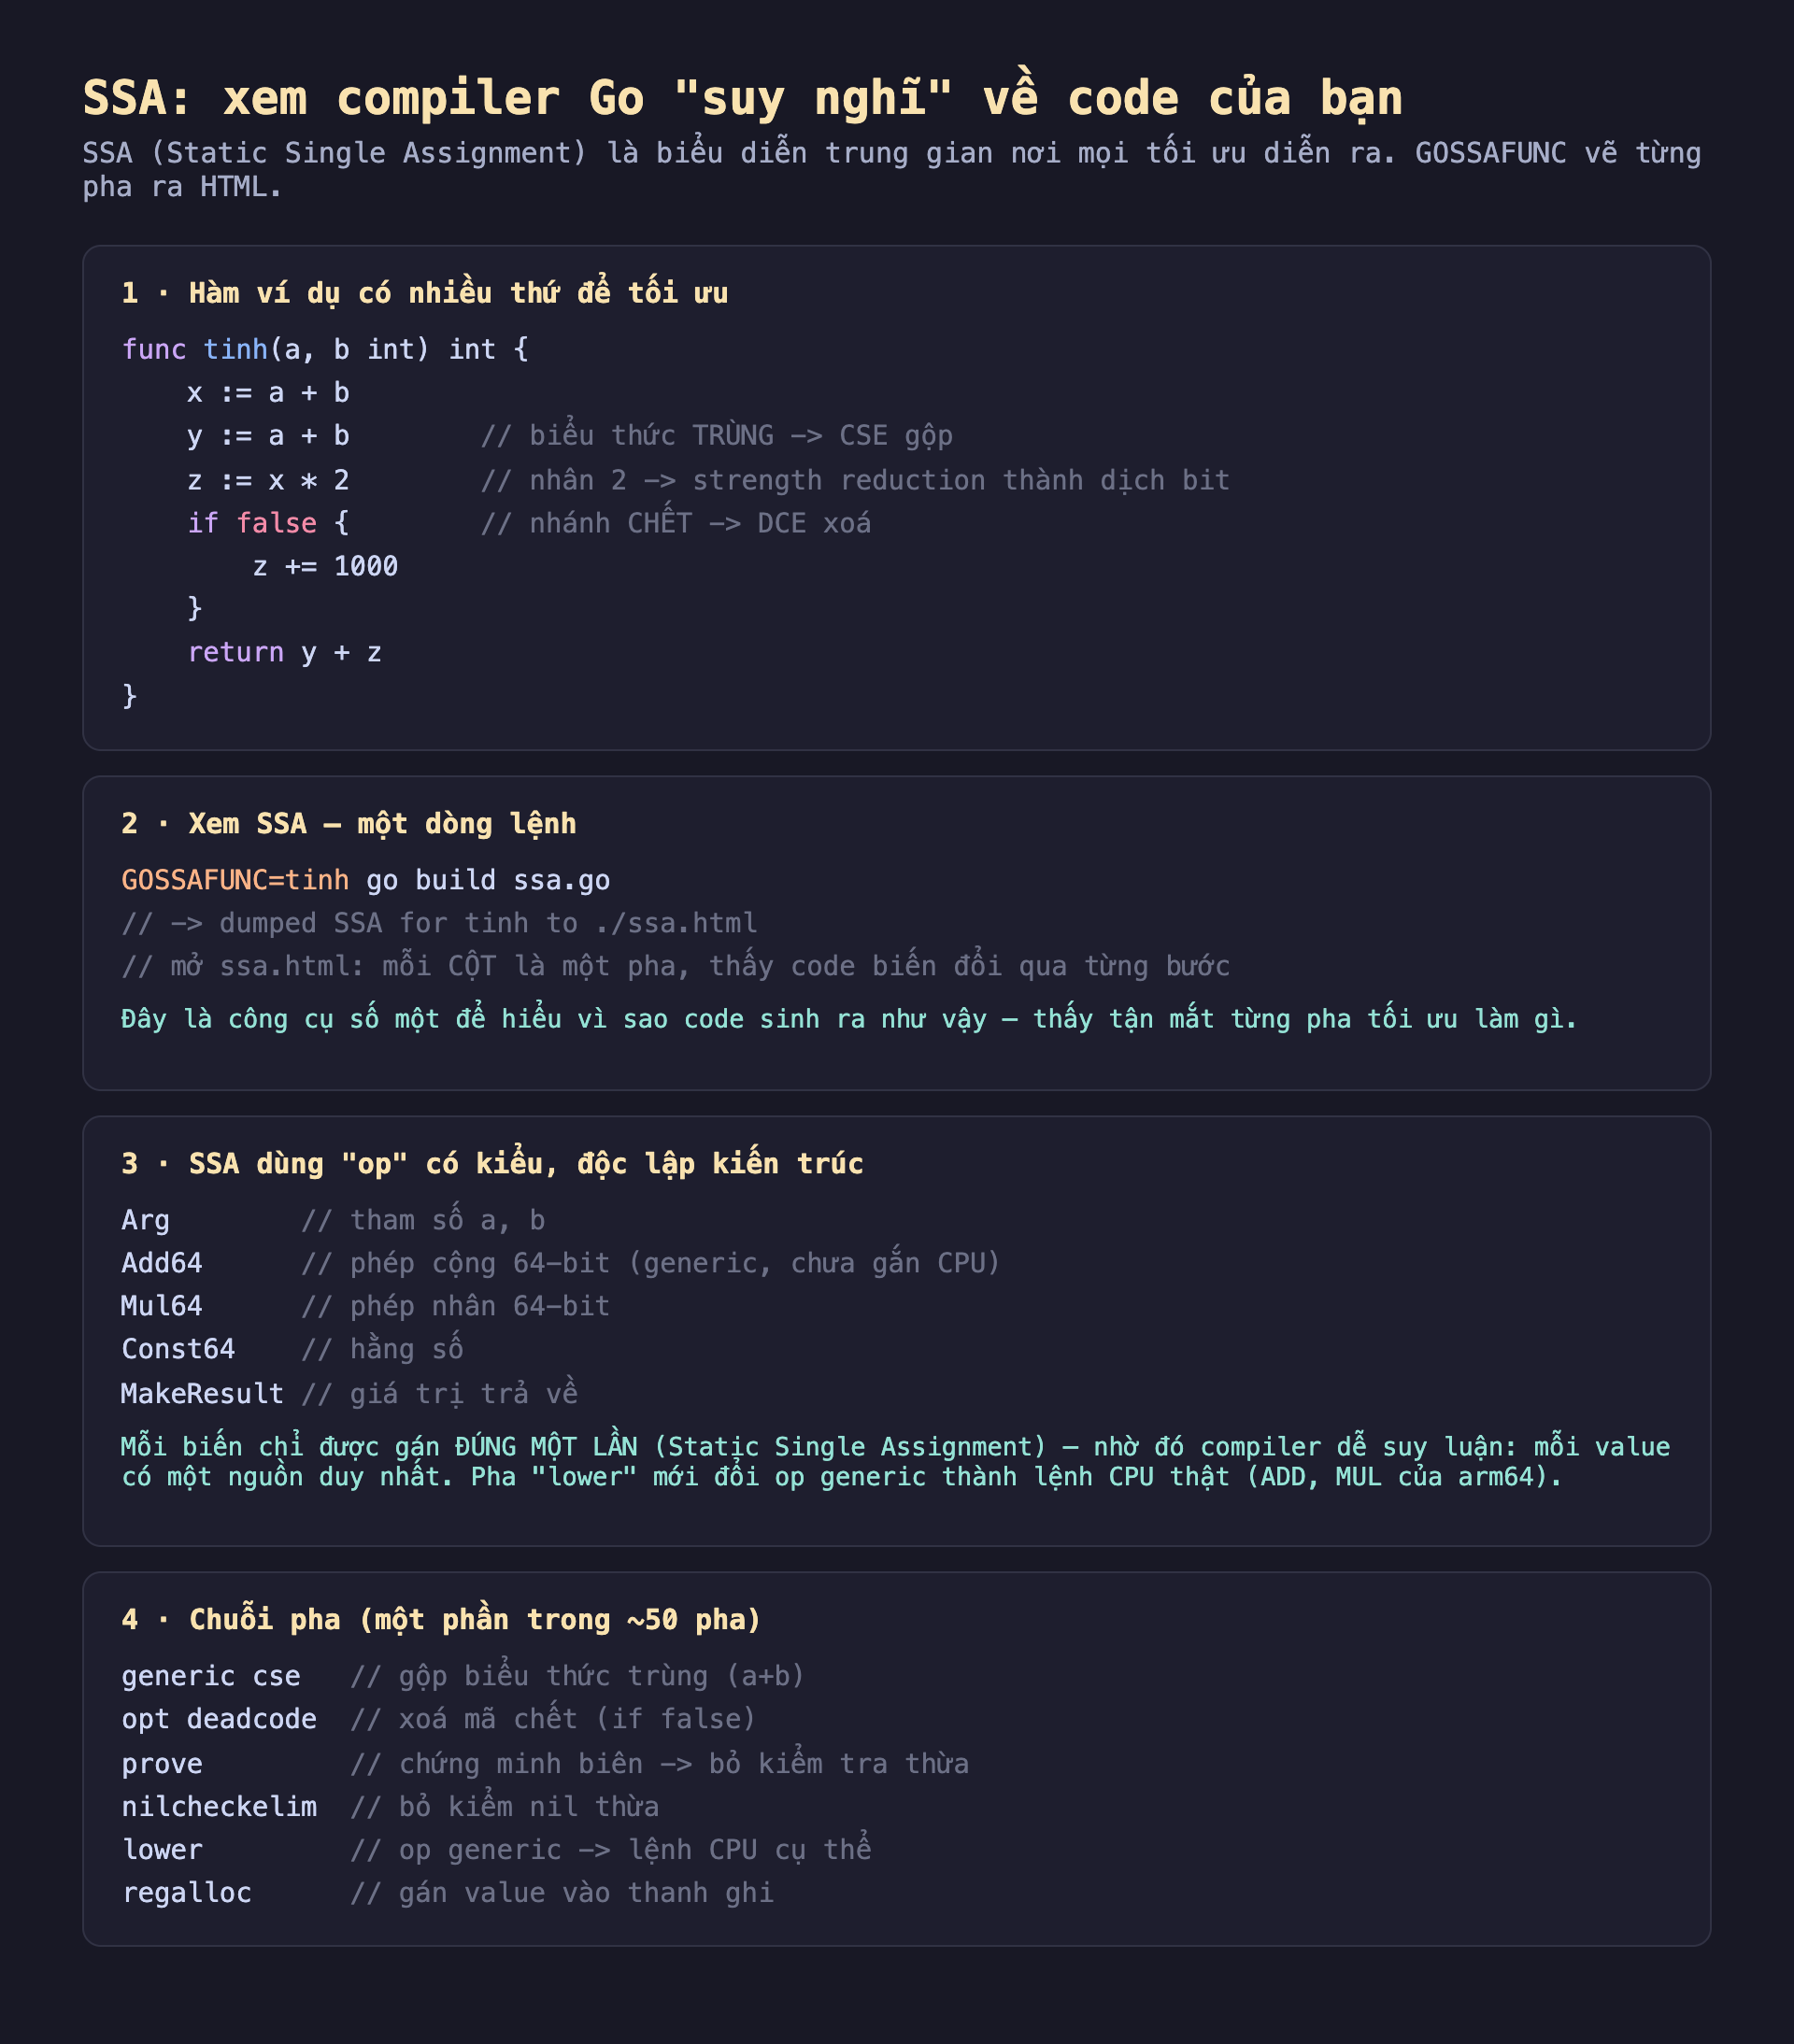
Hình 1: Hàm ví dụ và cách xem SSA. GOSSAFUNC=tinh sinh ssa.html — mỗi cột một pha. SSA dùng op có kiểu (Add64, Mul64...) rồi lower thành lệnh CPU.
Xem SSA: một dòng lệnh
Công cụ then chốt là biến môi trường GOSSAFUNC:
GOSSAFUNC=tinh go build ssa.go
# -> dumped SSA for tinh to ./ssa.html
Mở ssa.html, bạn thấy một bảng: mỗi cột là một pha compiler, hiển thị SSA của hàm sau pha đó. Bạn thấy tận mắt code biến đổi qua từng bước — value nào bị gộp, nhánh nào bị xoá, op generic đổi thành lệnh CPU lúc nào. Đây là công cụ số một để hiểu vì sao compiler sinh ra mã như vậy.
50 pha, và pha nào đắt nhất
Đo thật trên hàm tinh, compiler chạy 50 pha SSA tuần tự. Các pha tốn thời gian nhất:
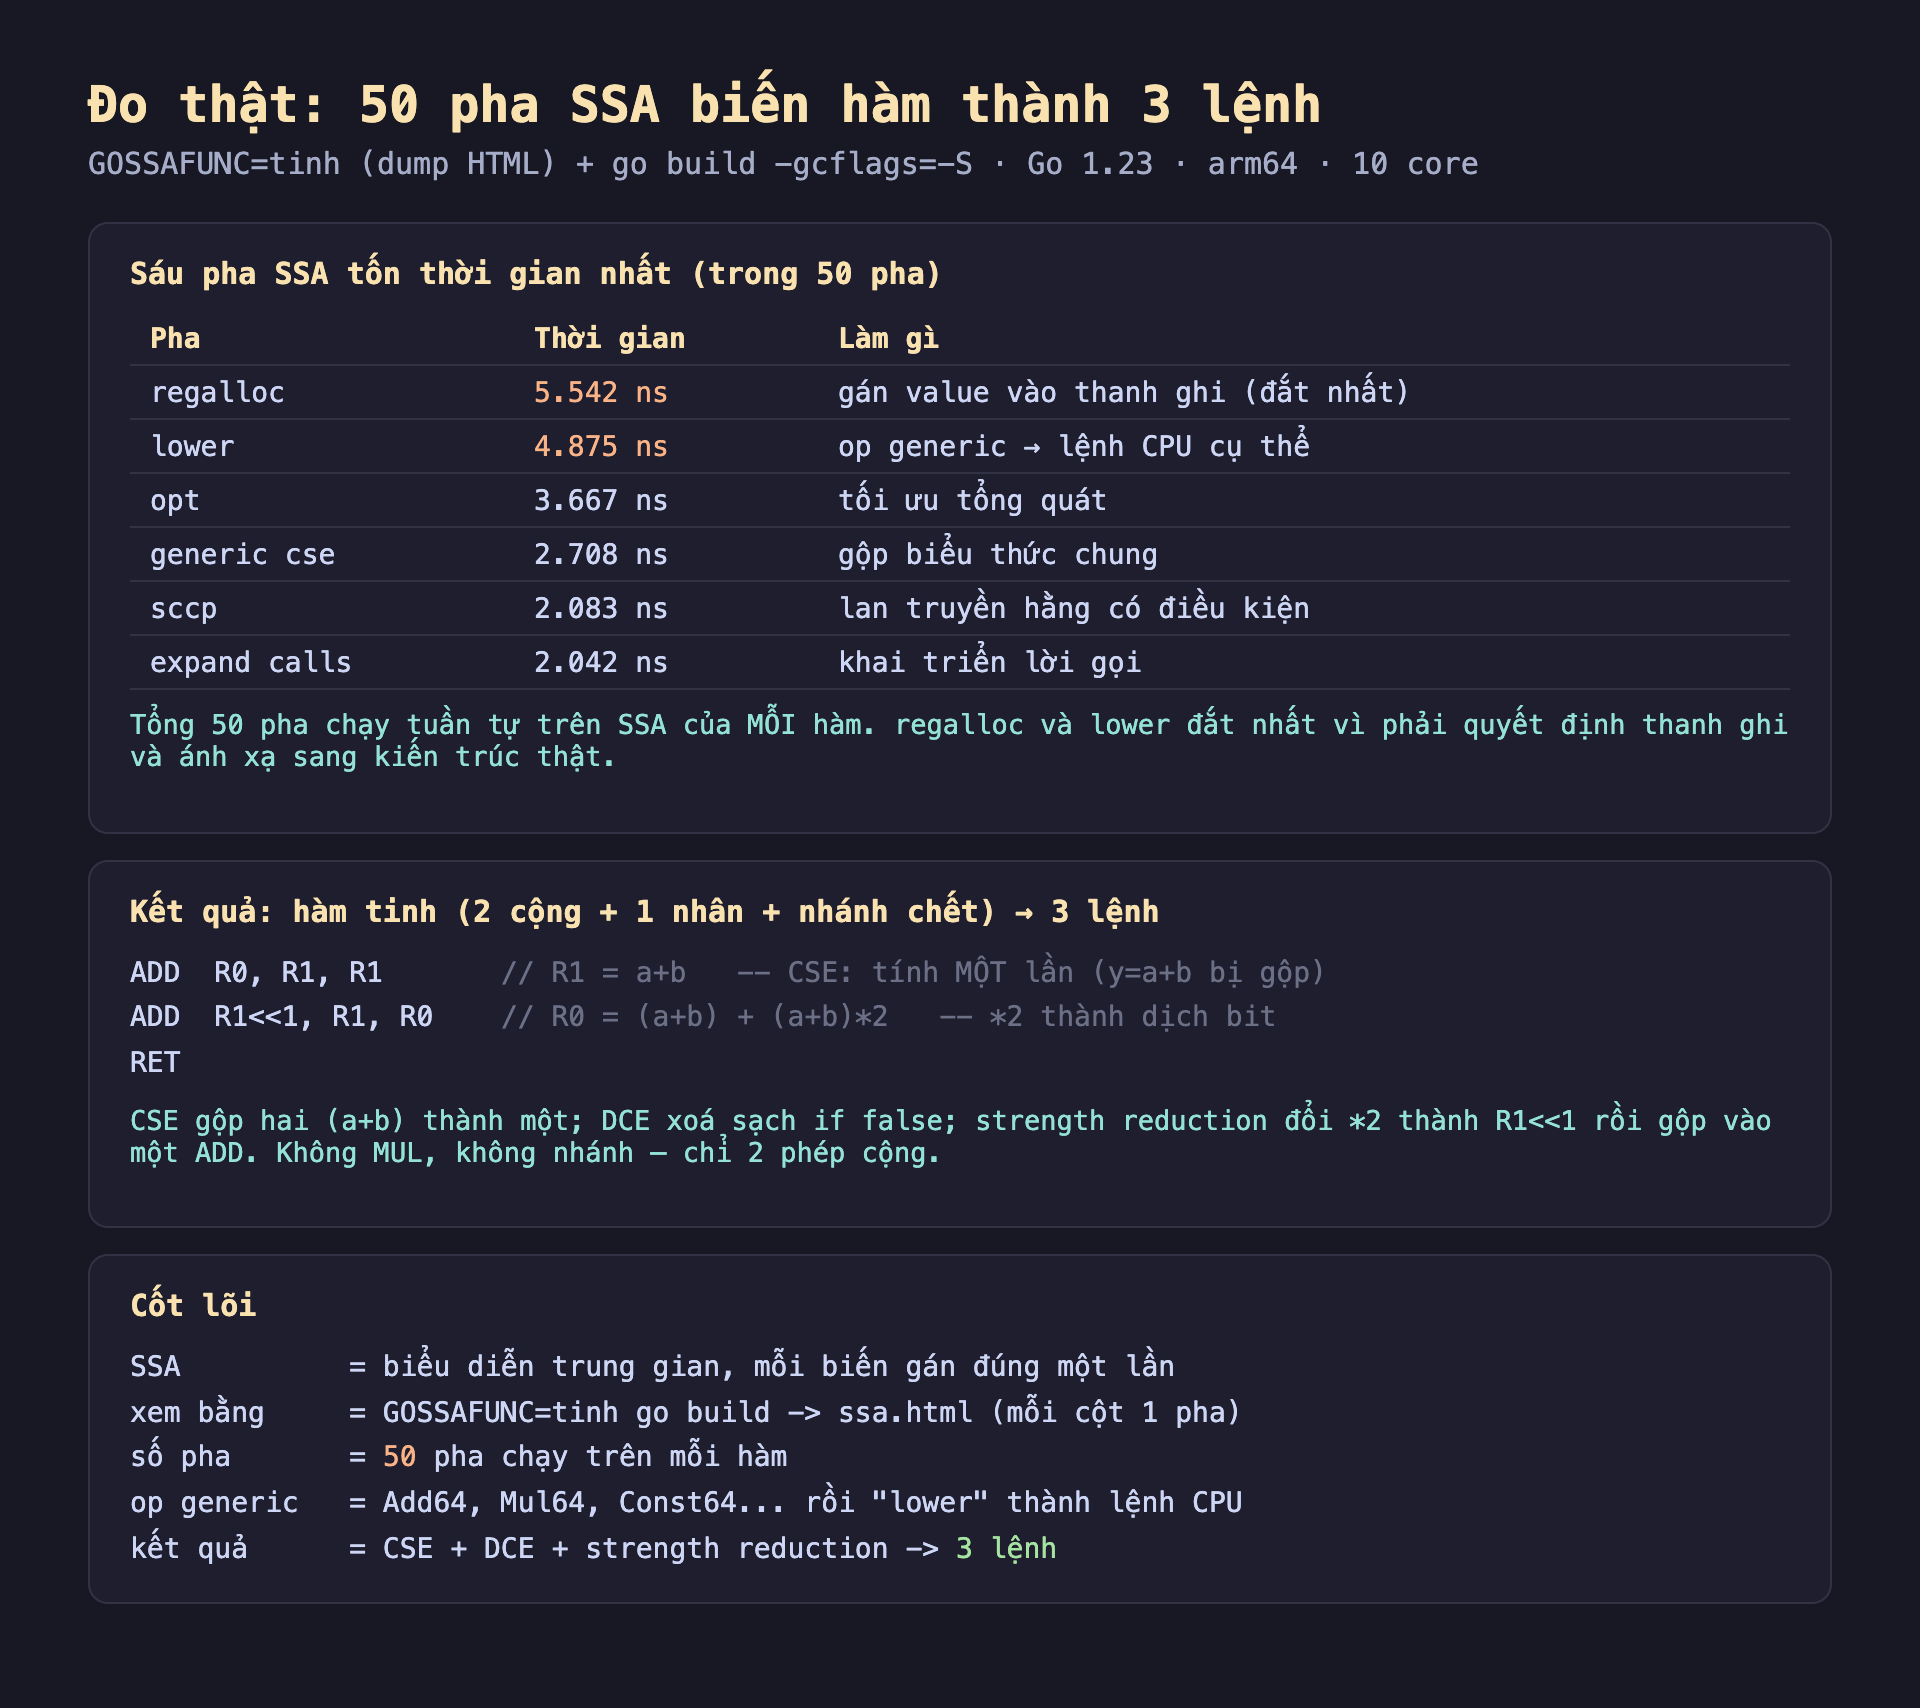
Hình 2: Sáu pha đắt nhất trong 50 pha (regalloc 5.542 ns, lower 4.875 ns...) và kết quả cuối — hàm tinh co còn 3 lệnh.
- regalloc (5.542 ns): gán value vào thanh ghi — đắt nhất, vì bài toán phân bổ thanh ghi phức tạp.
- lower (4.875 ns): đổi op generic thành lệnh CPU cụ thể.
- opt (3.667 ns), generic cse (2.708 ns), sccp (2.083 ns), expand calls (2.042 ns).
Chuỗi pha gồm những cái ta đã gặp: generic cse (gộp biểu thức chung), opt deadcode (xoá mã chết), prove (chứng minh biên → bỏ kiểm tra thừa), nilcheckelim (bỏ kiểm nil thừa), rồi lower và regalloc.
Kết quả: hàm co còn 3 lệnh
Hàm tinh có 2 phép cộng (a+b hai lần), 1 phép nhân (x*2), và một nhánh chết (if false). Sau 50 pha, assembly cuối chỉ còn:
ADD  R0, R1, R1       // R1 = a+b   — CSE: tính MỘT lần (y=a+b bị gộp)
ADD  R1<<1, R1, R0    // R0 = (a+b) + (a+b)*2   — *2 thành dịch bit
RET
Ba lệnh. Ba tối ưu ta đã học hợp lực:
- CSE (common subexpression elimination) gộp hai
a+bthành một — không tínhy = a+briêng. - DCE xoá sạch nhánh
if false. - Strength reduction đổi
x*2thànhR1<<1(dịch bit, rẻ hơn nhân) rồi gộp vào một lệnhADDdùng toán hạng dịch của arm64.
Không còn lệnh MUL, không nhánh — chỉ hai phép cộng. Nhìn qua ssa.html, bạn thấy chính xác pha nào làm mỗi biến đổi này.
Ứng dụng thực tế
Hiểu vì sao một tối ưu không xảy ra. Khi bạn nghĩ code nên được tối ưu mà benchmark nói không, mở ssa.html xem SSA qua từng pha — thường lộ ra lý do (một biến escape, một lời gọi chặn inline, một điều kiện không chứng minh được). Đây là cách gỡ lỗi hiệu năng ở tầng sâu nhất.
Học cách compiler "nhìn" code. Đọc SSA vài lần thay đổi cách bạn viết code nóng — bạn bắt đầu thấy biểu thức nào gộp được, nhánh nào loại được, giá trị nào giữ trong thanh ghi. Đây là kiến thức nền cho tối ưu vi mô đúng đắn.
Đối chiếu với assembly. SSA (nhất là cột genssa cuối) gần như ánh xạ 1-1 với assembly cuối cùng. Đọc SSA thường dễ hơn assembly thô vì nó giữ tên op có nghĩa và cấu trúc khối cơ bản.
Đánh đổi cần cân nhắc
GOSSAFUNC là công cụ học/gỡ lỗi, không phải thứ dùng hằng ngày. Đọc 50 pha SSA tốn thời gian và chỉ đáng cho một hàm bạn thực sự cần hiểu sâu. Với tối ưu thường ngày, -gcflags=-m (inline/escape) và benchmark đã đủ; chỉ xuống SSA khi chúng không giải thích được.
Đừng viết code "chiều SSA" một cách mù quáng. Compiler đã rất giỏi; viết code rõ ràng thường cho SSA tốt hơn code "thông minh" vặn vẹo. Ví dụ như bài BCE cho thấy, chiêu reslice có thể phản tác dụng. Đọc SSA để hiểu, không phải để micro-optimize từng dòng.
SSA thay đổi giữa các phiên bản Go. Số pha, tên pha, và cả quyết định tối ưu đổi theo phiên bản (Go liên tục thêm pha mới như PGO, cải thiện BCE). Kiến thức SSA của một phiên bản không cố định — dùng nó để hiểu nguyên lý, và đo lại trên phiên bản bạn thực sự chạy.
Ba ý mang về
- SSA là biểu diễn trung gian nơi mọi tối ưu diễn ra, với đặc tính mỗi biến gán đúng một lần (single assignment) giúp compiler suy luận dễ — xem tận mắt bằng
GOSSAFUNC=tinh go buildsinhssa.html, mỗi cột một pha. - Compiler chạy ~50 pha SSA trên mỗi hàm: đo thật, đắt nhất là
regalloc(5.542 ns, phân bổ thanh ghi) vàlower(4.875 ns, đổi op generic thành lệnh CPU) — SSA dùng op có kiểu độc lập kiến trúc (Add64, Mul64) rồi mới ánh xạ sang lệnh thật. - Nhiều tối ưu hợp lực co hàm lại: đo thật hàm
tinh(2 cộng + 1 nhân + nhánh chết) thành 3 lệnh — CSE gộpa+btrùng, DCE xoáif false, strength reduction đổi*2thành dịch bit; đọc SSA để hiểu vì sao, không phải để vặn vẹo code.
Bài tập làm thử
Bài 1 (đọc hiểu khái niệm). Giải thích ý nghĩa cái tên "Static Single Assignment" (SSA), và vì sao đặc tính đó lại giúp compiler dễ phân tích luồng dữ liệu hơn.
Đáp án
"Single assignment" nghĩa là mỗi biến (value) chỉ được gán đúng một lần. Thay vì x bị ghi đè nhiều lần trong code nguồn, mỗi lần gán tạo ra một value SSA mới (v1, v2...). Nhờ vậy mỗi value có đúng một nguồn duy nhất, nên compiler dễ suy luận "giá trị này từ đâu ra, ai dùng nó" mà không phải theo dõi lịch sử ghi đè — đây là nền tảng để thực hiện các tối ưu như CSE, DCE, strength reduction một cách chính xác.
Bài 2 (công cụ). Bạn muốn xem toàn bộ các pha compiler biến đổi hàm tinh như thế nào. Viết đúng lệnh dùng biến môi trường GOSSAFUNC, và cho biết kết quả xem ở đâu, mỗi cột trong kết quả đó thể hiện gì.
Đáp án
GOSSAFUNC=tinh go build ssa.go
Lệnh này sinh ra file ssa.html (thông báo "dumped SSA for tinh to ./ssa.html"). Mở file đó lên, mỗi cột là một pha compiler, hiển thị trạng thái SSA của hàm ngay sau khi pha đó chạy xong — cho phép xem tận mắt value nào bị gộp, nhánh nào bị xoá, op generic đổi thành lệnh CPU ở bước nào.
Bài 3 (đọc hiểu số liệu). Bài đo 50 pha SSA chạy trên hàm tinh, hai pha tốn thời gian nhất là regalloc (5.542 ns) và lower (4.875 ns). Giải thích ngắn gọn từng pha này làm gì, và vì sao chúng đắt nhất trong 50 pha.
Đáp án
lower đổi các op SSA generic có kiểu, độc lập kiến trúc (như Add64, Mul64) thành lệnh CPU cụ thể của kiến trúc đích (ADD, MUL trên arm64/amd64). regalloc (register allocation) quyết định value SSA nào được giữ trong thanh ghi vật lý nào, khi nào phải tràn ra stack. Cả hai đắt vì đều phải giải các bài toán ánh xạ/tối ưu phức tạp: lower phải chọn đúng lệnh máy cho từng kiến trúc, còn regalloc phải giải bài toán phân bổ tài nguyên thanh ghi hữu hạn cho có thể rất nhiều value.
Bài 4 (vận dụng — truy vết tối ưu). Hàm tinh trong bài có: x := a+b, y := a+b (trùng biểu thức), z := x*2*2, if false { z += 1000 } (nhánh chết), rồi return y+z. Sau 50 pha, assembly cuối chỉ còn 2 lệnh ADD và RET. Nêu tên ba tối ưu cụ thể đã hợp lực để cho ra kết quả đó, và mô tả ngắn mỗi tối ưu đã làm gì với đoạn code trên.
Đáp án
Ba tối ưu: (1) CSE (common subexpression elimination) — nhận ra x và y cùng là a+b, chỉ tính một lần rồi dùng chung. (2) DCE (dead code elimination) — xoá hẳn nhánh if false { z += 1000 } vì điều kiện luôn sai. (3) Strength reduction — đổi phép nhân *2*2 (tức *4, ở đây cụ thể là *2 rồi gộp) thành phép dịch bit (<<1), rẻ hơn phép nhân, rồi gộp luôn vào toán hạng dịch của lệnh ADD trên arm64. Kết quả: chỉ còn tính a+b một lần và một lệnh cộng dùng toán hạng dịch, không còn MUL, không còn nhánh.
Bài 5 (bẫy/đánh đổi). Một lập trình viên định dùng GOSSAFUNC để kiểm tra SSA của mọi hàm trong dự án nhằm "tối ưu tận gốc". Bài viết có đồng tình với cách làm này không? Nêu lý do và đề xuất quy trình hợp lý hơn.
Đáp án
Không đồng tình. GOSSAFUNC là công cụ học/gỡ lỗi hiệu năng sâu, đọc 50 pha SSA tốn thời gian và chỉ đáng cho một hàm bạn thực sự cần hiểu kỹ. Quy trình hợp lý: với tối ưu hàng ngày, dùng -gcflags=-m (xem inline/escape) và benchmark trước; chỉ khi hai công cụ đó không giải thích được vì sao một tối ưu không xảy ra thì mới xuống tới SSA. Ngoài ra, số pha và quyết định tối ưu thay đổi theo từng phiên bản Go, nên kiến thức SSA của một bản cụ thể không cố định — phải đo lại trên phiên bản đang dùng, không suy diễn từ phiên bản cũ.
Phần sau ta đi tới tầng cuối cùng — mã máy: Phần sau mổ xẻ cách đọc assembly Plan 9 của Go — cú pháp lạ (toán hạng ngược, pseudo-register), cách khớp nó với code nguồn, và vì sao Go dùng cú pháp riêng này.
