Mỗi lần bạn viết xs[i] trong Go, compiler chèn một kiểm tra: i có nằm trong [0, len(xs)) không? Nếu không, panic. Đây là cái giá của an toàn bộ nhớ — Go không cho đọc ngoài biên như C. Nhưng compiler đủ thông minh để xoá kiểm tra đó khi chứng minh được chỉ số luôn hợp lệ — gọi là bounds check elimination (BCE). Bài này đo BCE bằng công cụ thật, và trả lời trung thực một câu ít ai đo: check biên thực sự tốn bao nhiêu, và chiêu "reslice để gợi ý BCE" có đáng không.
Cơ chế: khi nào compiler xoá được check
Compiler xoá kiểm tra biên khi chứng minh được chỉ số hợp lệ. Hai mẫu phổ biến nhất luôn được xoá:
func tongRange(xs []int) int {
	s := 0
	for _, x := range xs { s += x }   // range: 0 check biên
	return s
}
func tongIndex(xs []int) int {
	for i := 0; i < len(xs); i++ { s += xs[i] }  // i<len(xs) chứng minh → 0 check
}
Điều kiện i < len(xs) cho compiler bằng chứng rằng xs[i] luôn trong biên. Ngược lại, truy cập mà compiler không chứng minh được vẫn giữ check:
func lay3(xs []int, i int) int {
	return xs[i] + xs[i+1] + xs[i+2]   // 3 check biên riêng (không biết i, i+1, i+2 hợp lệ)
}
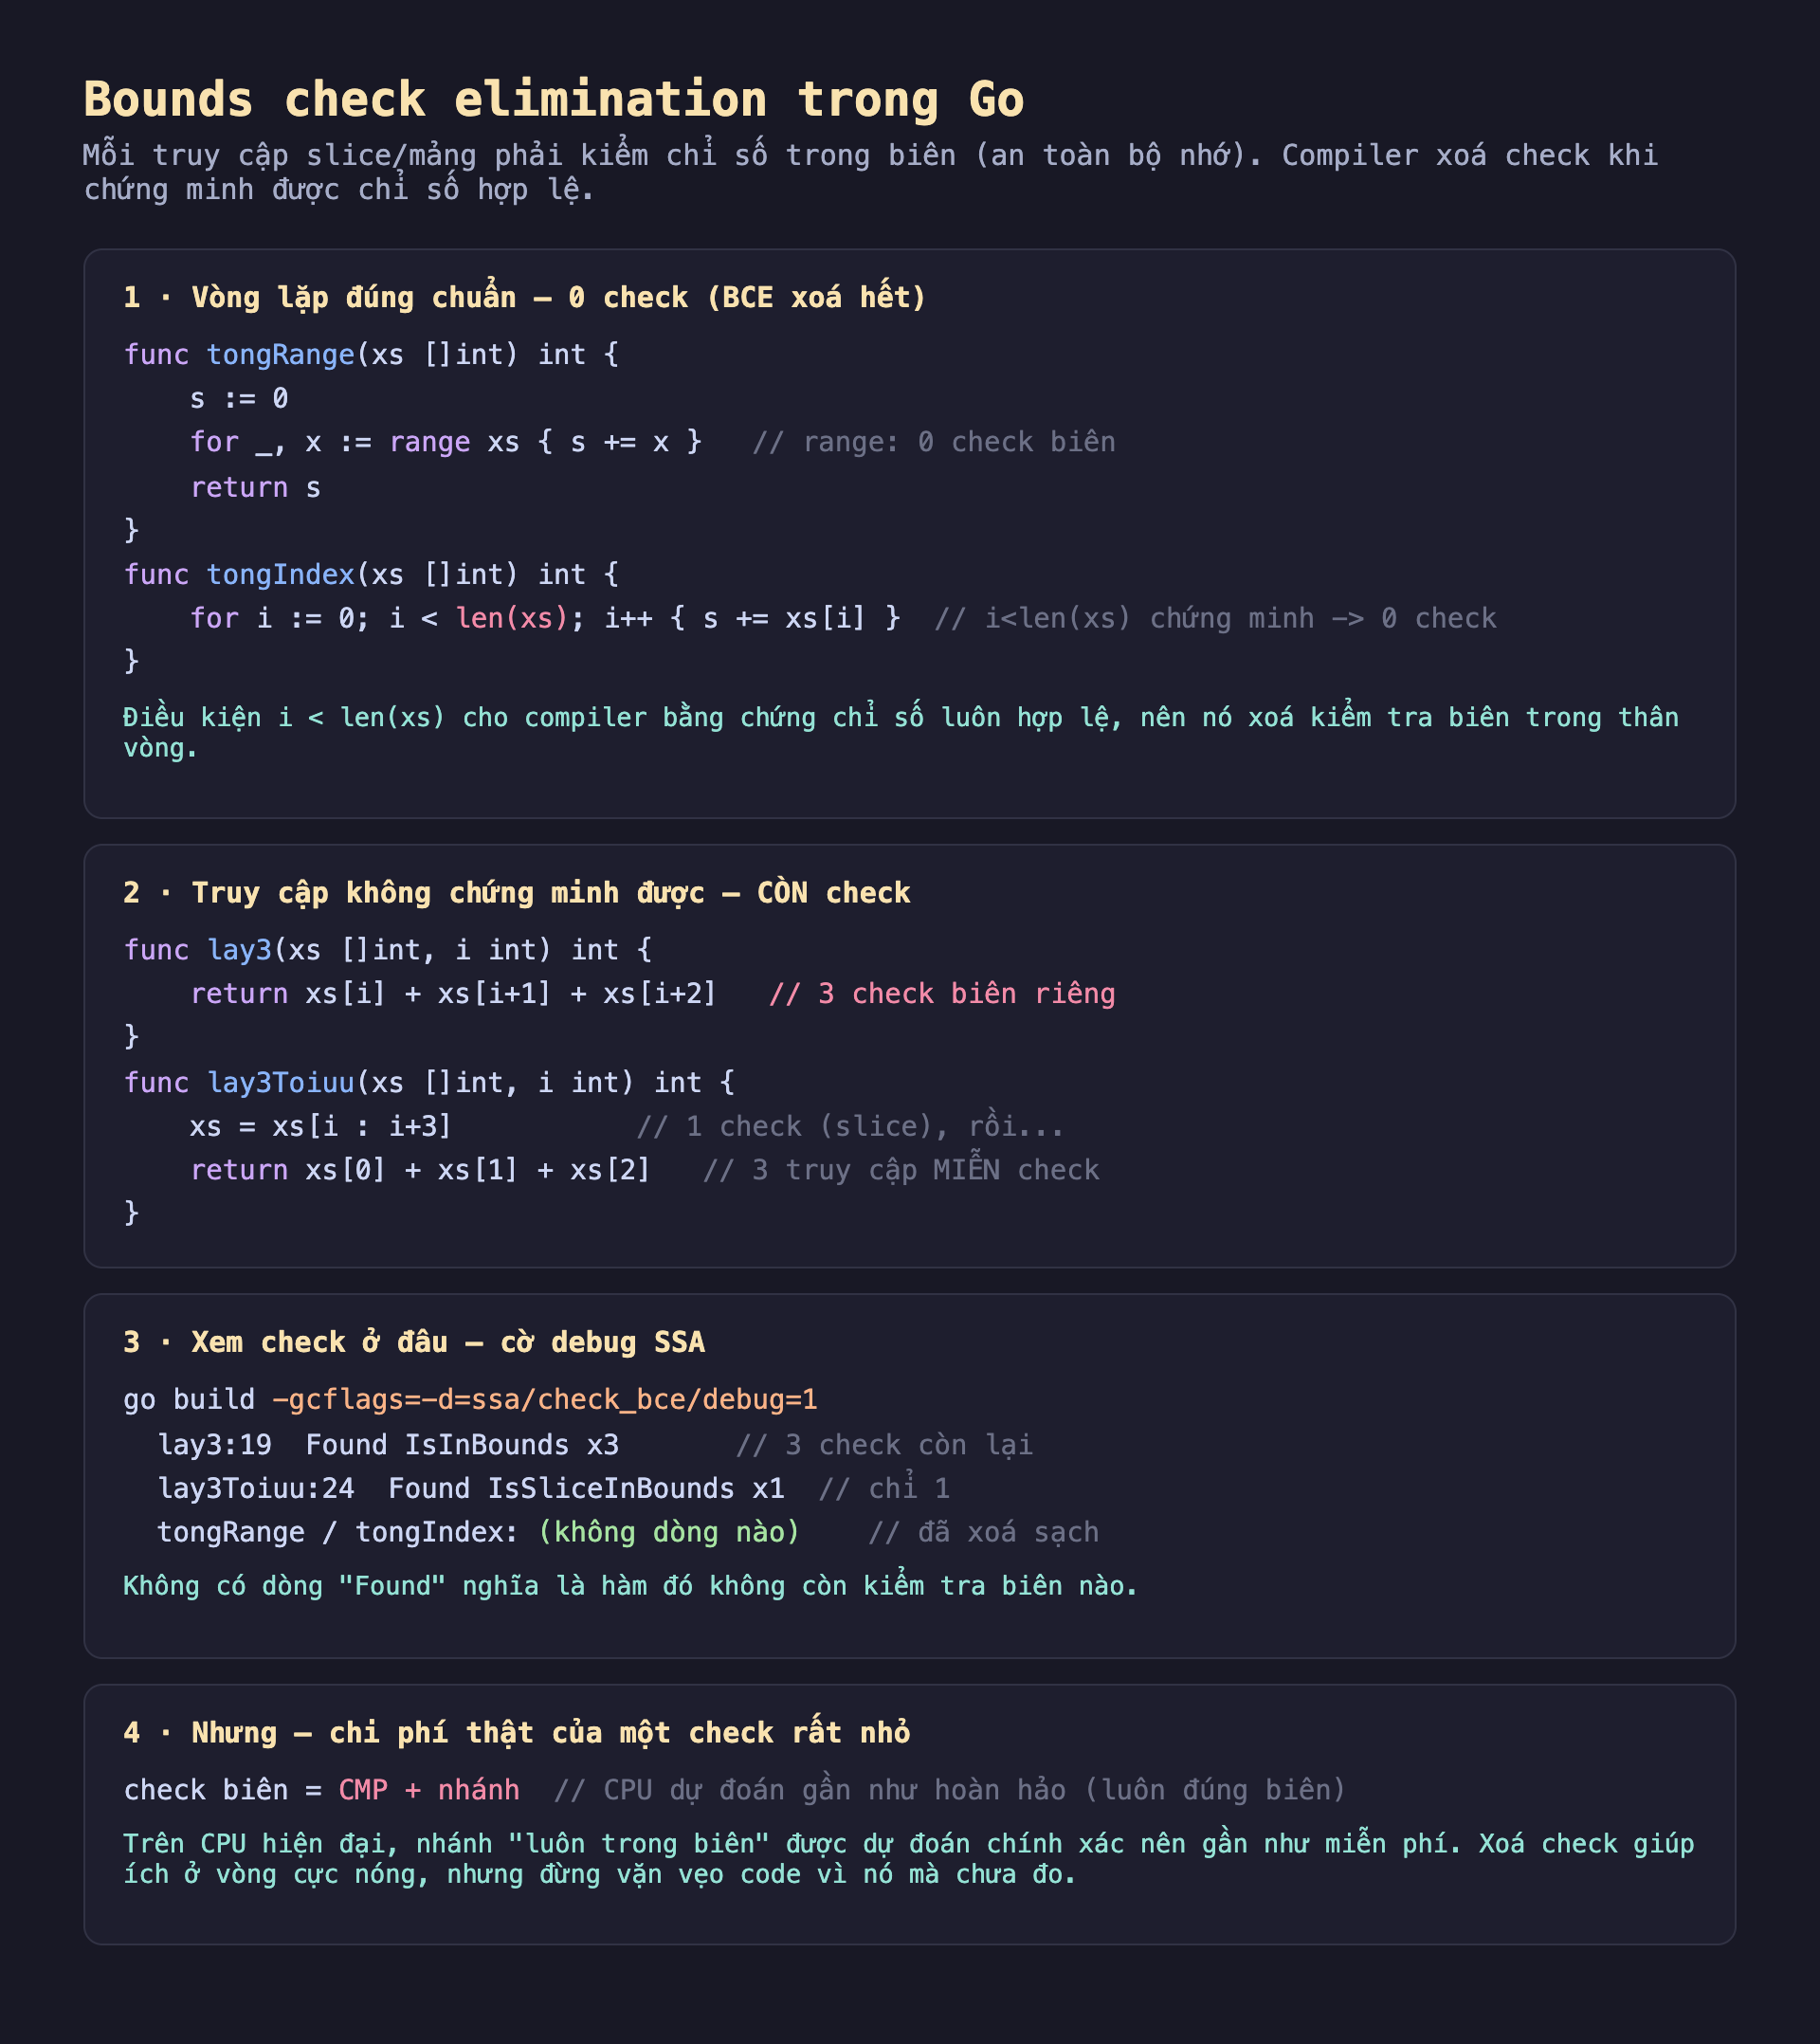
Hình 1: Vòng range và i < len(xs) được BCE xoá hết check; lay3 giữ 3 check; reslice xs[i:i+3] gộp còn 1 check. Xem bằng cờ debug SSA.
Xem check ở đâu: cờ debug SSA
Go có cờ để in chính xác truy cập nào còn giữ check:
go build -gcflags=-d=ssa/check_bce/debug=1
  lay3:19        Found IsInBounds x3        // 3 check còn lại
  lay3Toiuu:24   Found IsSliceInBounds x1   // reslice: chỉ 1
  tongRange / tongIndex: (không dòng nào)    // đã xoá sạch
Không có dòng Found nghĩa là hàm đó không còn kiểm tra biên. Đây là công cụ chuẩn để kiểm tra một vòng lặp nóng có bị check thừa không.
Đo thật: check tốn bao nhiêu, reslice có đáng?
Đây là phần ít ai đo và cho kết quả bất ngờ. Ta so lay3 (3 check) với lay3Toiuu (reslice xs[i:i+3] còn 1 check), và so mặc định với -gcflags=-B (tắt hẳn kiểm biên) để lộ chi phí thuần:
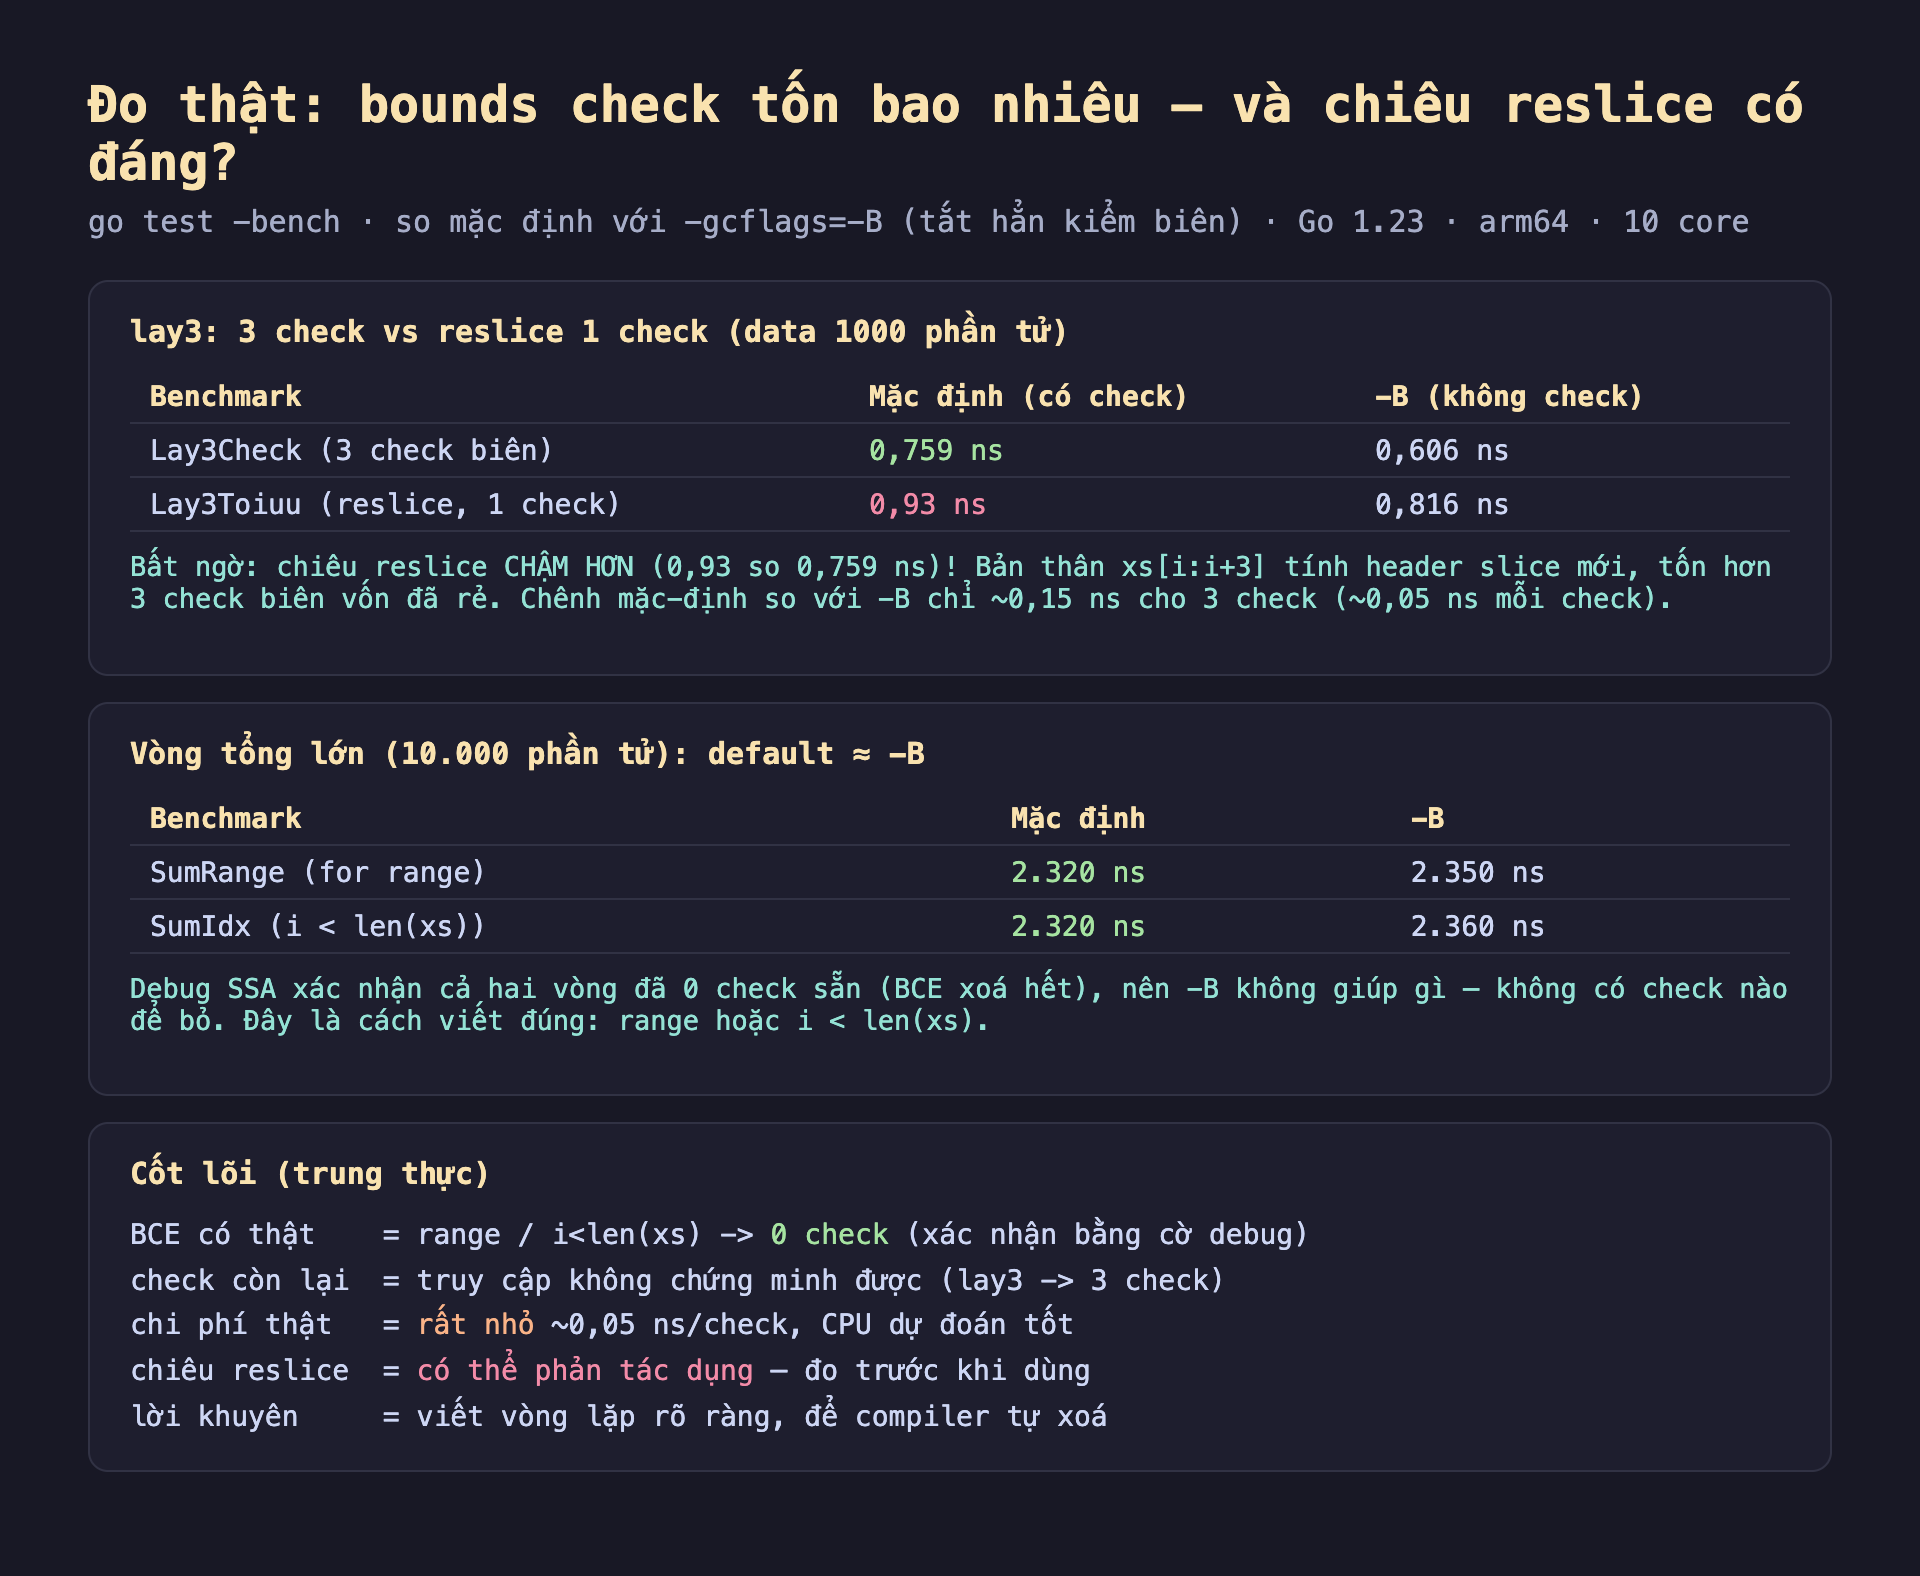
Hình 2: Lay3Check (3 check) 0,759 ns so với Lay3Toiuu (reslice) 0,93 ns — chiêu reslice chậm hơn. Vòng tổng lớn: mặc định ≈ -B (~2.320 ns) vì đã 0 check sẵn.
Kết quả trung thực:
lay33 check: 0,759 ns.lay3Toiuureslice 1 check: 0,93 ns — chậm hơn! Bản thânxs[i:i+3]phải tính một slice header mới, tốn hơn cả 3 check biên vốn đã rẻ.- Chi phí thuần của check: so mặc định (0,759) với
-B(0,606) → ~0,15 ns cho 3 check, tức ~0,05 ns mỗi check. Rất nhỏ, vì CPU dự đoán nhánh "luôn trong biên" gần như hoàn hảo. - Vòng tổng lớn (10.000 phần tử):
SumRangevàSumIdxcho mặc định ≈-B(~2.320 ns). Cờ debug xác nhận cả hai đã 0 check sẵn — nên tắt kiểm biên không giúp gì, không có check nào để bỏ.
Bài học trung thực: BCE là thật và kiểm chứng được, nhưng chi phí một check biên trên CPU hiện đại rất nhỏ, và các chiêu vi tối ưu như reslice có thể phản tác dụng.
Ứng dụng thực tế
Viết vòng lặp rõ ràng — compiler tự xoá check. Dùng for _, x := range xs hoặc for i := 0; i < len(xs); i++. Cả hai được BCE xoá sạch check mà không cần bạn làm gì. Đây là 95% trường hợp — code rõ ràng đã là code nhanh.
Kiểm vòng nóng bằng cờ debug, đừng đoán. Nếu một vòng lặp thật sự nóng (pprof chỉ ra), chạy -gcflags=-d=ssa/check_bce/debug=1 xem nó còn check không. Nếu có và bạn muốn xoá, thử tái cấu trúc — nhưng đo lại để chắc chắn có lợi.
Gán len ra biến giúp compiler trong vài mẫu. Đôi khi truy cập nhiều slice trong một vòng, gán độ dài chung ra biến và kiểm nó trước có thể giúp BCE. Nhưng như đo trên cho thấy, lợi ích thường nhỏ — chỉ đáng ở vòng xử lý hàng tỷ phần tử.
Đánh đổi cần cân nhắc
Chi phí check nhỏ, nhưng không phải luôn bằng 0. Ở vòng lặp cực nóng xử lý khối lượng dữ liệu khổng lồ (mã hóa, nén, xử lý ảnh), tổng chi phí check có thể tích lũy đáng kể. Ở đó BCE quan trọng — nhưng cách tốt nhất vẫn là viết code để compiler tự xoá, không phải chiêu trò.
Đừng dùng -gcflags=-B trong production. Tắt kiểm biên bỏ đi lưới an toàn bộ nhớ của Go — một chỉ số sai giờ đọc/ghi bộ nhớ tùy tiện thay vì panic sạch sẽ. Cờ này chỉ để đo chi phí check, không bao giờ để build thật.
Reslice và các chiêu BCE là con dao hai lưỡi. Như đo được, xs[i:i+3] thêm chi phí tạo slice header có thể lớn hơn phần check tiết kiệm được. Mọi vi tối ưu BCE phải đo trước-sau; nhiều "mẹo" lan truyền trên mạng đã lỗi thời vì compiler Go ngày càng giỏi BCE hơn.
Ba ý mang về
- BCE là thật và kiểm chứng được: vòng
rangevài < len(xs)được xoá sạch check (xác nhận bằng-gcflags=-d=ssa/check_bce/debug=1); truy cập không chứng minh được nhưlay3giữ 3 check. - Chi phí một check biên rất nhỏ trên CPU hiện đại: đo thật ~0,05 ns mỗi check (so mặc định với
-B), vì nhánh "luôn trong biên" được dự đoán gần như hoàn hảo — và vòng tổng lớn cho mặc định ≈-Bvì đã 0 check sẵn. - Chiêu reslice để gợi ý BCE có thể phản tác dụng: đo thật
lay3Toiuu(reslice, 1 check) chậm hơnlay3(3 check) vì tạo slice header tốn hơn — viết vòng lặp rõ ràng để compiler tự xoá, và đo trước-sau mọi vi tối ưu BCE.
Phần sau ta xem một tối ưu compiler họ hàng cũng chạy âm thầm: Phần sau mổ xẻ dead code elimination — cách compiler nhận ra và xoá mã không bao giờ chạy, vì sao nó phá benchmark (như bài //go:noinline đã chạm tới), và giới hạn của nó.
