Suốt chặng GC, ta đã học từng mảnh: allocator, escape analysis, tái dùng buffer, sync.Pool, GOGC, GOMEMLIMIT, write barrier. Bài này gộp chúng lại thành một quy trình thực chiến. Giảm áp lực GC hiếm khi là một mẹo — nó là áp nhiều kỹ thuật cùng lúc lên đường nóng, dẫn dắt bởi số đo. Ta lấy một tác vụ đời thực, đo áp lực GC của bản ngây thơ, tối ưu, rồi đo lại để thấy cải thiện thật.
Tác vụ: ghép chuỗi từ nghìn record
Một tác vụ cực phổ biến: ghép 1000 record thành một chuỗi (ví dụ dựng response, dòng log, CSV). Bản ngây thơ viết tự nhiên nhưng đầy nguồn cấp phát:
func xuLyNaive() string {
    var lines []string                          // slice từ nil -> nhiều realloc
    for _, r := range recs {
        lines = append(lines, fmt.Sprintf("%d:%s", r.id, r.name))
    }                                            // Sprintf: boxing interface{} mỗi record
    return strings.Join(lines, "\n")             // còn cấp chuỗi trung gian
}
Bản này có ba nguồn cấp phát chồng lên nhau: slice lines lớn dần từ nil, mỗi fmt.Sprintf đóng gói r.id/r.name vào interface{} và tạo chuỗi mới, và strings.Join cấp thêm chuỗi kết quả.
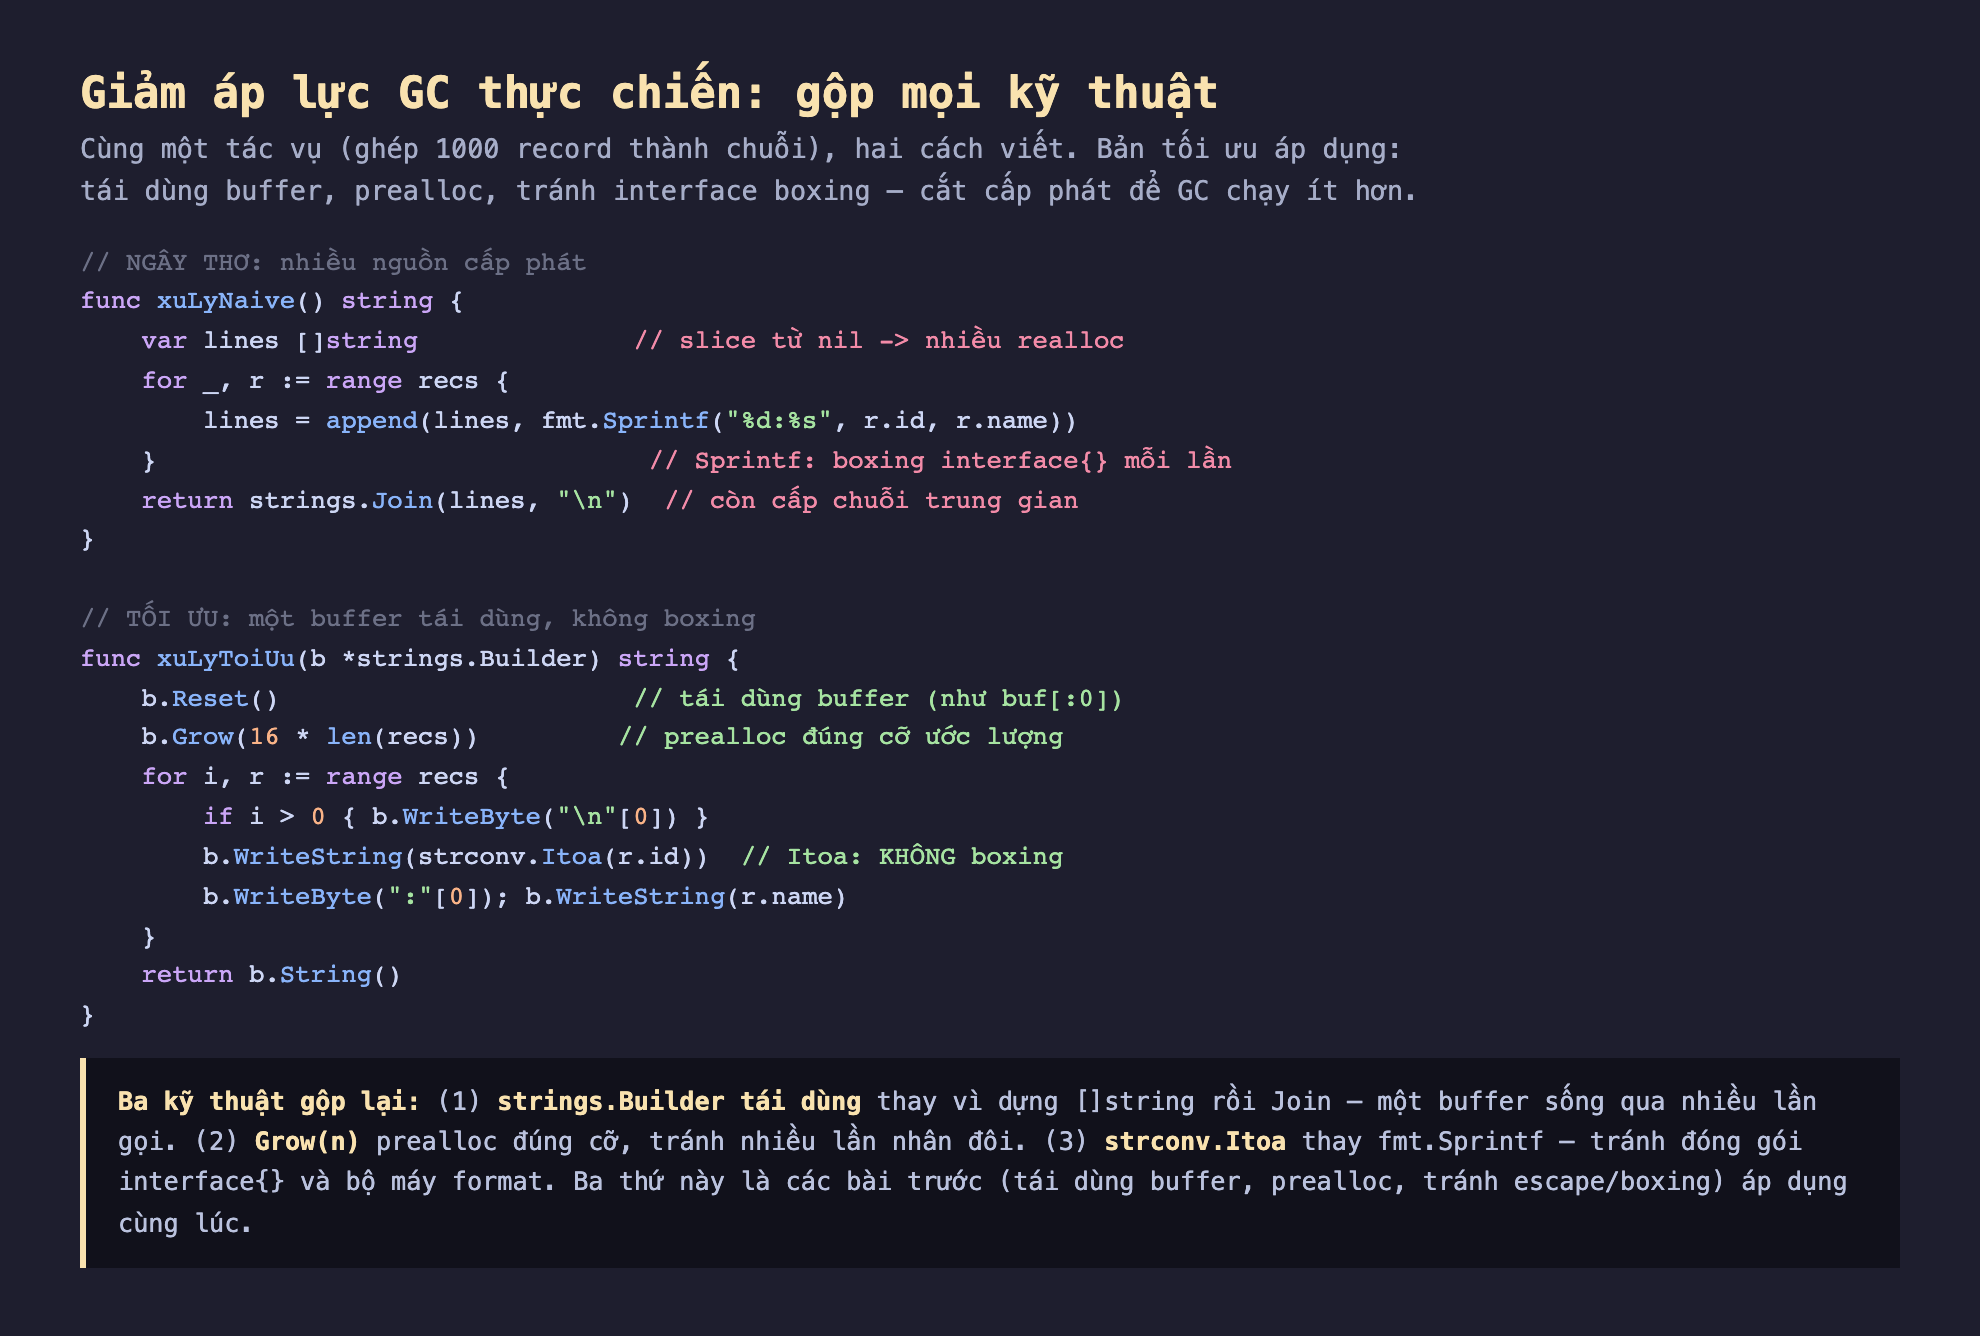
Hình 1: Bản ngây thơ (nhiều nguồn cấp phát) vs bản tối ưu áp ba kỹ thuật cùng lúc: tái dùng strings.Builder, Grow prealloc, và strconv.Itoa thay fmt.Sprintf để tránh boxing.
Bản tối ưu: ba kỹ thuật gộp lại
func xuLyToiUu(b *strings.Builder) string {
    b.Reset()                      // tái dùng buffer (như buf[:0])
    b.Grow(16 * len(recs))         // prealloc đúng cỡ ước lượng
    for i, r := range recs {
        if i > 0 { b.WriteByte('\n') }
        b.WriteString(strconv.Itoa(r.id))  // Itoa: KHÔNG boxing
        b.WriteByte(':'); b.WriteString(r.name)
    }
    return b.String()
}
Ba kỹ thuật từ các bài trước áp cùng lúc: (1) strings.Builder tái dùng — một buffer sống qua nhiều lần gọi (bài tái dùng buffer), thay vì dựng []string rồi Join. (2) Grow(n) prealloc đúng cỡ ước lượng (bài prealloc), tránh nhiều lần nhân đôi. (3) strconv.Itoa thay fmt.Sprintf — tránh đóng gói interface{} (bài escape/boxing) và bộ máy format nặng.
Đo thật: cắt GC 4 lần, nhanh 4 lần
Benchmark cả hai với -benchmem, rồi đo áp lực GC qua 100.000 lần gọi:
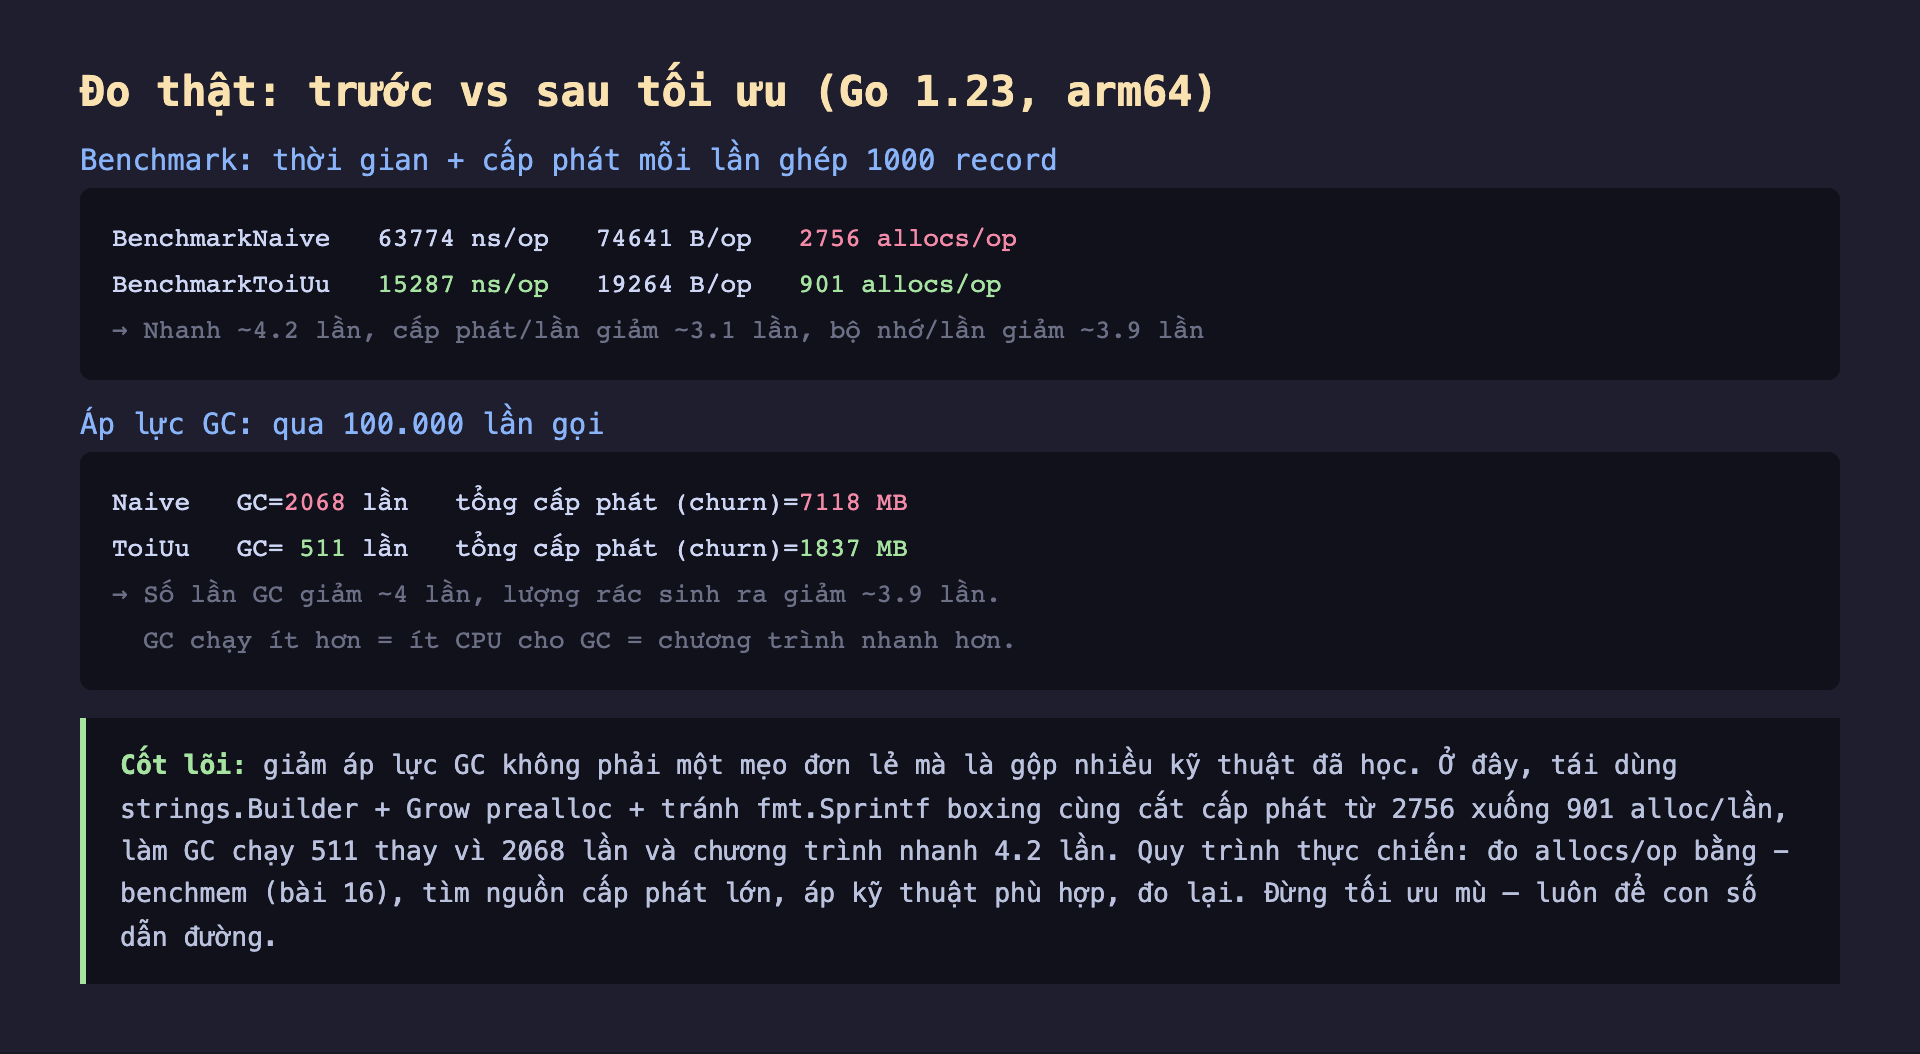
Hình 2: Bản tối ưu nhanh 4,2 lần (15287 vs 63774 ns), cấp phát mỗi lần giảm từ 2756 xuống 901 alloc. Qua 100k lần gọi, GC chạy 511 thay vì 2068 lần (giảm 4 lần), rác sinh ra giảm từ 7118 xuống 1837 MB.
Kết quả rõ ràng ở hai tầng:
- Mỗi lần gọi: bản tối ưu nhanh 4,2 lần (15.287 vs 63.774 ns), số cấp phát giảm từ 2756 xuống 901 (~3,1 lần), bộ nhớ mỗi lần giảm ~3,9 lần.
- Áp lực GC (qua 100.000 lần gọi): bản tối ưu làm GC chạy 511 lần thay vì 2068 (giảm ~4 lần), tổng rác sinh ra giảm từ 7118 MB xuống 1837 MB (~3,9 lần).
Mắt xích nhân quả: ít cấp phát → ít rác → GC chạy thưa hơn → ít CPU dành cho GC → chương trình nhanh hơn. Tốc độ 4,2 lần không chỉ từ code chạy nhanh hơn mà còn từ việc GC không phải làm việc nhiều.
Quy trình thực chiến
Đây là quy trình chuẩn để giảm áp lực GC, không phải đoán mò:
- Đo
allocs/opbằng-benchmem(bài đo cấp phát). Đây là điểm khởi đầu — biết hàm nào cấp phát nhiều. - Tìm nguồn cấp phát lớn: slice từ nil,
fmt.Sprintf/interface boxing, con trỏ thoát heap, cấp buffer mới mỗi lần. Đọc-gcflags=-m(bài escape) nếu cần. - Áp kỹ thuật phù hợp: tái dùng buffer (
Reset/[:0]), prealloc (Grow/make(...,0,n)), thayfmtbằngstrconv,sync.Poolcho object lớn bị churn. - Đo lại: xác nhận
allocs/opgiảm vàns/opgiảm. Nếu không cải thiện, hoàn tác — độ phức tạp thêm không đáng.
Ứng dụng thực tế
Đường nóng của server là nơi đáng tối ưu nhất. Hàm xử lý mỗi request, mỗi message, mỗi dòng dữ liệu — chạy hàng triệu lần — là nơi cắt cấp phát có tác động lớn nhất tới GC toàn cục. Profile để tìm chúng (bài pprof sau).
strconv và strings.Builder là bạn thân của đường nóng. Bất cứ chỗ nào ghép chuỗi hay format số trong vòng lặp nóng, fmt.Sprintf là nghi phạm đầu tiên. Thay bằng strconv.Itoa/AppendInt và strings.Builder thường cắt phần lớn cấp phát.
Giảm cấp phát bổ trợ cho chỉnh GOGC/GOMEMLIMIT. Hai hướng phối hợp: giảm cấp phát làm GC làm ít việc hơn mỗi lần, còn chỉnh GOGC/GOMEMLIMIT điều tiết tần suất. Cùng nhau cho kết quả tốt nhất.
Đánh đổi cần cân nhắc
Đừng tối ưu mù — luôn để con số dẫn đường. Bản tối ưu phức tạp hơn (thêm tham số buffer, quản lý Reset). Chỉ đáng ở đường nóng profiler chỉ ra. Với code chạy vài lần, bản ngây thơ dễ đọc hơn thắng — 4 lần nhanh của một hàm chạy 10 lần chẳng đáng gì.
Tái dùng buffer thêm trạng thái và rủi ro. Truyền *strings.Builder qua các lần gọi nghĩa là buffer sống lâu hơn — cẩn thận không chia sẻ nó giữa các goroutine (không an toàn) và luôn Reset trước dùng. Bài tái dùng buffer đã cảnh báo về chia sẻ backing array.
Cải thiện phụ thuộc workload. Con số 4 lần ở đây là của tác vụ ghép chuỗi cụ thể. Workload khác (tính toán số, I/O) có tỉ lệ cấp phát khác, nên mức cải thiện khác. Luôn đo trên chính workload của bạn, đừng giả định con số của bài này áp cho mọi trường hợp.
Ba ý mang về
- Giảm áp lực GC là gộp nhiều kỹ thuật, không phải một mẹo: đo thật, tái dùng
strings.Builder+Growprealloc +strconv.Itoathayfmt.Sprintfcùng cắt cấp phát từ 2756 xuống 901 alloc/lần. - Ít cấp phát dẫn tới ít GC dẫn tới nhanh hơn: qua 100k lần gọi, GC chạy 511 thay vì 2068 lần (giảm 4 lần) và rác giảm từ 7118 xuống 1837 MB — tốc độ 4,2 lần đến từ cả code nhanh hơn lẫn GC làm ít việc.
- Quy trình đo-tìm-sửa-đo lại: dùng
-benchmemtìm nguồn cấp phát, áp kỹ thuật phù hợp, xác nhận cảallocs/oplẫnns/opgiảm — chỉ tối ưu đường nóng profiler chỉ ra, đừng tối ưu mù.
Bài tập làm thử
Bài 1 (đọc hiểu). Bản xuLyNaive trong bài có ba nguồn cấp phát chồng lên nhau. Kể tên cả ba.
Đáp án
(1) slice lines bắt đầu từ nil nên lớn dần qua nhiều lần append, gây nhiều lần cấp phát lại (realloc); (2) mỗi fmt.Sprintf("%d:%s", r.id, r.name) đóng gói r.id/r.name vào interface{} (boxing) và tạo chuỗi mới; (3) strings.Join(lines, "\n") cấp thêm chuỗi kết quả trung gian.
Bài 2 (sửa lỗi). Đoạn xuLyToiUu sau có lỗi khiến việc "tái dùng buffer" mất tác dụng khi hàm được gọi nhiều lần liên tiếp trên cùng một *strings.Builder. Tìm và sửa lỗi.
func xuLyToiUu(b *strings.Builder) string {
    b.Grow(16 * len(recs))
    for i, r := range recs {
        if i > 0 { b.WriteByte('\n') }
        b.WriteString(strconv.Itoa(r.id))
        b.WriteByte(':'); b.WriteString(r.name)
    }
    return b.String()
}
Đáp án
Thiếu b.Reset() ở đầu hàm. Không reset thì mỗi lần gọi hàm sẽ nối thêm nội dung vào phần đã có từ lần gọi trước thay vì tái sử dụng buffer rỗng, làm kết quả sai dần và buffer phình to vô ích. Sửa bằng cách thêm b.Reset() làm dòng đầu tiên trong thân hàm, trước b.Grow(...).
Bài 3 (đọc hiểu số liệu). Theo số đo trong bài, bản tối ưu giảm số lần gọi allocs/op từ 2756 xuống 901, và qua 100.000 lần gọi thì số lần GC chạy giảm từ 2068 xuống 511. Giải thích chuỗi nhân quả nối hai con số này lại với nhau.
Đáp án
Ít cấp phát mỗi lần gọi (allocs/op giảm) → tổng lượng rác (churn) sinh ra qua nhiều lần gọi giảm theo (7118 MB xuống 1837 MB) → GC có ít rác để dọn hơn nên chạy thưa hơn (2068 xuống 511 lần) → ít chu kỳ GC hơn nghĩa là ít CPU dành cho GC hơn → chương trình nhanh hơn tổng thể (4,2 lần), không chỉ nhờ code tự thân chạy nhanh hơn mà còn nhờ GC làm ít việc hơn.
Bài 4 (vận dụng thực tế). Bài đưa ra quy trình 4 bước để giảm áp lực GC. Hãy liệt kê đúng thứ tự bốn bước đó.
Đáp án
- Đo
allocs/opbằng-benchmemđể biết hàm nào cấp phát nhiều. 2. Tìm nguồn cấp phát lớn (slice từ nil,fmt.Sprintf/interface boxing, con trỏ thoát heap, cấp buffer mới mỗi lần), có thể dùng-gcflags=-m. 3. Áp kỹ thuật phù hợp (tái dùng buffer, prealloc bằngGrow/make(...,0,n), thayfmtbằngstrconv,sync.Poolcho object lớn). 4. Đo lại để xác nhận cảallocs/oplẫnns/opđều giảm — nếu không cải thiện thì hoàn tác.
Bài 5 (bẫy/đánh đổi). Bài cảnh báo "tái dùng buffer thêm trạng thái và rủi ro". Nếu bạn truyền cùng một *strings.Builder cho nhiều goroutine gọi xuLyToiUu đồng thời, điều gì có thể xảy ra, và tại sao "chỉ 4 lần nhanh hơn" không phải lý do đủ để luôn tối ưu theo cách này?
Đáp án
strings.Builder không an toàn khi dùng đồng thời (không có khoá bên trong), nên nhiều goroutine cùng ghi vào một buffer sẽ gây dữ liệu đua (race) và kết quả sai/hỏng — mỗi goroutine cần Builder riêng hoặc phải đồng bộ hoá. Về đánh đổi: độ phức tạp thêm (quản lý tham số buffer, gọi Reset đúng lúc) chỉ đáng khi đây là đường nóng chạy hàng triệu lần; với code chạy vài lần, bản ngây thơ dễ đọc hơn và 4 lần nhanh hơn của một hàm ít gọi là không đáng kể.
Phần sau ta học công cụ tìm chính xác cái gì cấp phát: Phần sau đào sâu heap profiling với pprof — cách chụp và đọc heap profile, tìm hàm/dòng cấp phát nhiều nhất, và phân biệt inuse vs alloc.
