Bài trước ta thấy unshare --pid tạo một PID namespace mới và shell trở thành PID 1. Trong Docker, điều này xảy ra với ứng dụng của bạn: tiến trình chính của container luôn là PID 1 — vị trí thường dành cho init của cả một hệ điều hành. Nghe vô hại, nhưng nó kéo theo một hành vi kernel đặc biệt khiến rất nhiều container "không chịu tắt" khi docker stop, bị giết cứng và mất dữ liệu. Bài này (phần 2 loạt Docker) chạy thật để thấy cạm bẫy PID 1 và cách sửa đúng.
Mỗi container một cây tiến trình riêng
PID namespace khiến các tiến trình trong container được đánh số độc lập với host. Tiến trình chính thành PID 1, và cùng một tiến trình có PID khác nhau nhìn từ trong và ngoài:
docker run alpine sh -c 'echo $$'          # -> 1 (nhìn từ trong container)
docker inspect -f '{{.State.Pid}}' <ct>    # -> 75513 (chính nó, nhìn từ host)
Đây là cơ chế cô lập: container thấy cây tiến trình của riêng mình, bắt đầu từ 1, không thấy (và không giết được) tiến trình của host hay container khác.
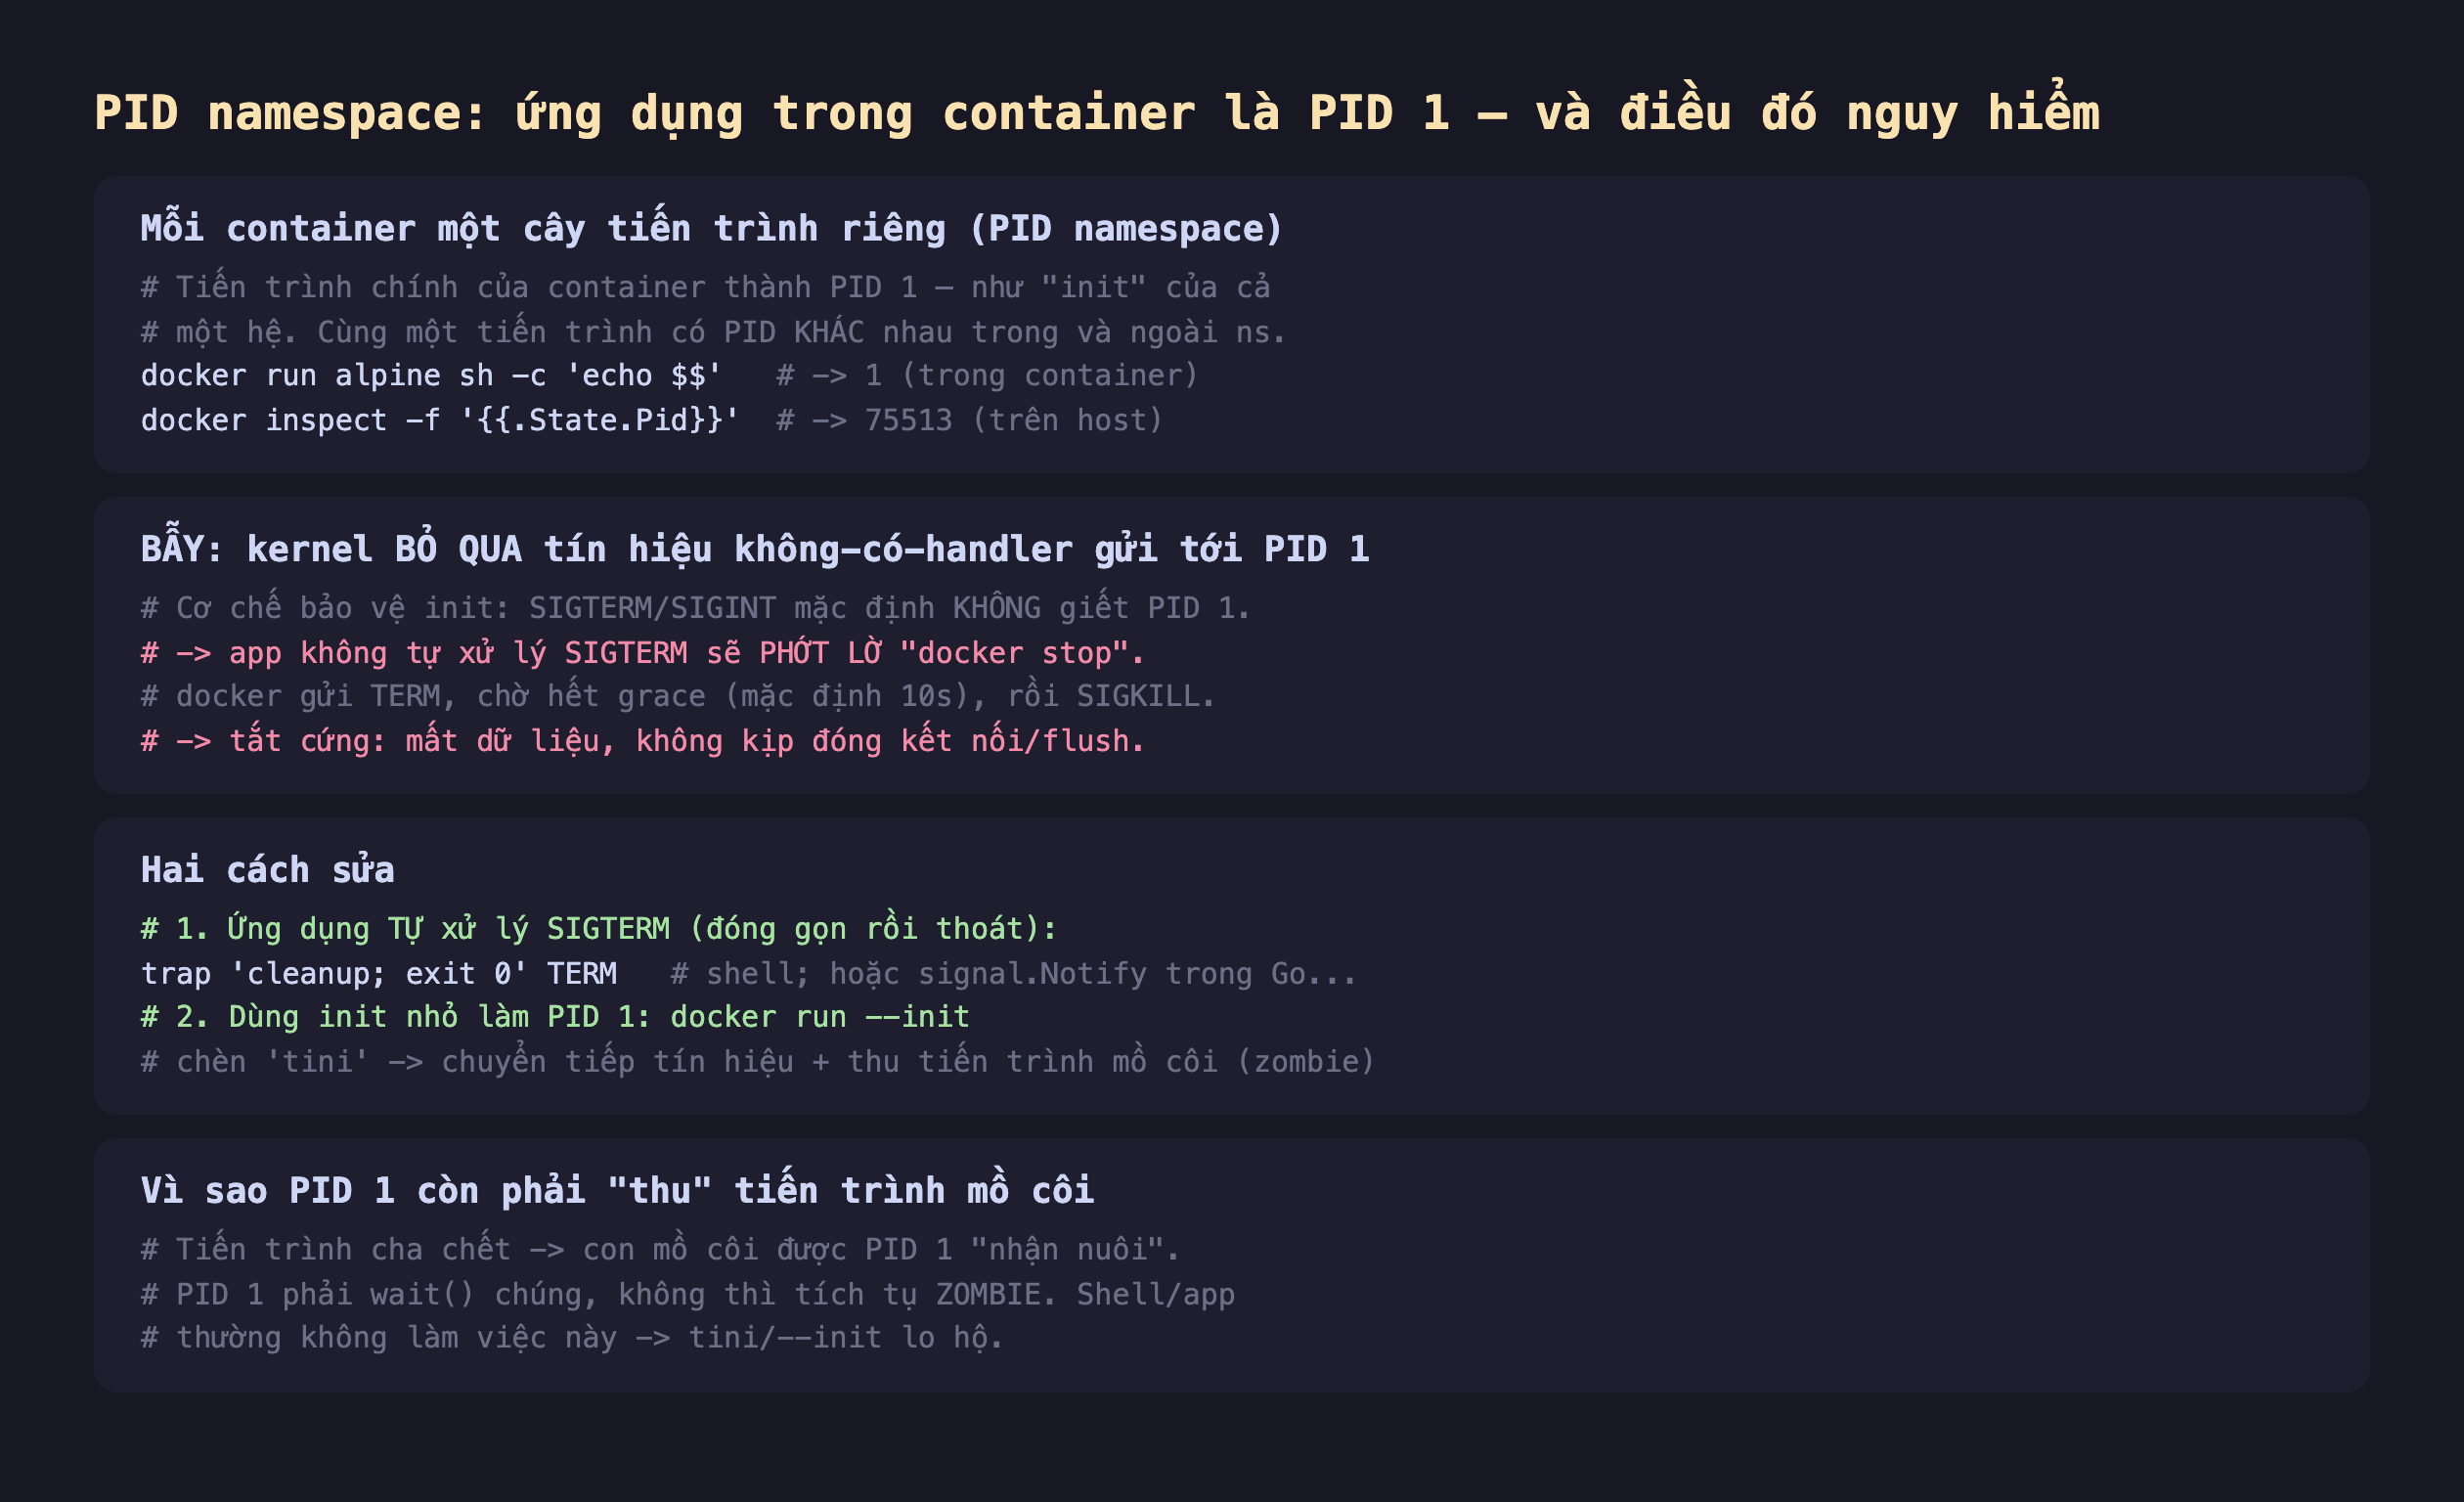
Hình 1: Tiến trình chính của container là PID 1 (PID khác host); kernel bỏ qua tín hiệu không-handler cho PID 1 nên app không xử lý SIGTERM sẽ phớt lờ docker stop; sửa bằng cách tự xử lý SIGTERM hoặc dùng --init (tini).
Đo thật: PID 1 phớt lờ SIGTERM
Kernel Linux có một cơ chế bảo vệ đặc biệt cho PID 1: nó không áp hành vi mặc định của các tín hiệu (như SIGTERM giết tiến trình) lên PID 1. Chỉ những tín hiệu mà PID 1 cài handler mới có tác dụng. Ý định là bảo vệ init khỏi bị giết nhầm — nhưng trong container, "init" chính là app của bạn. Đo thật:
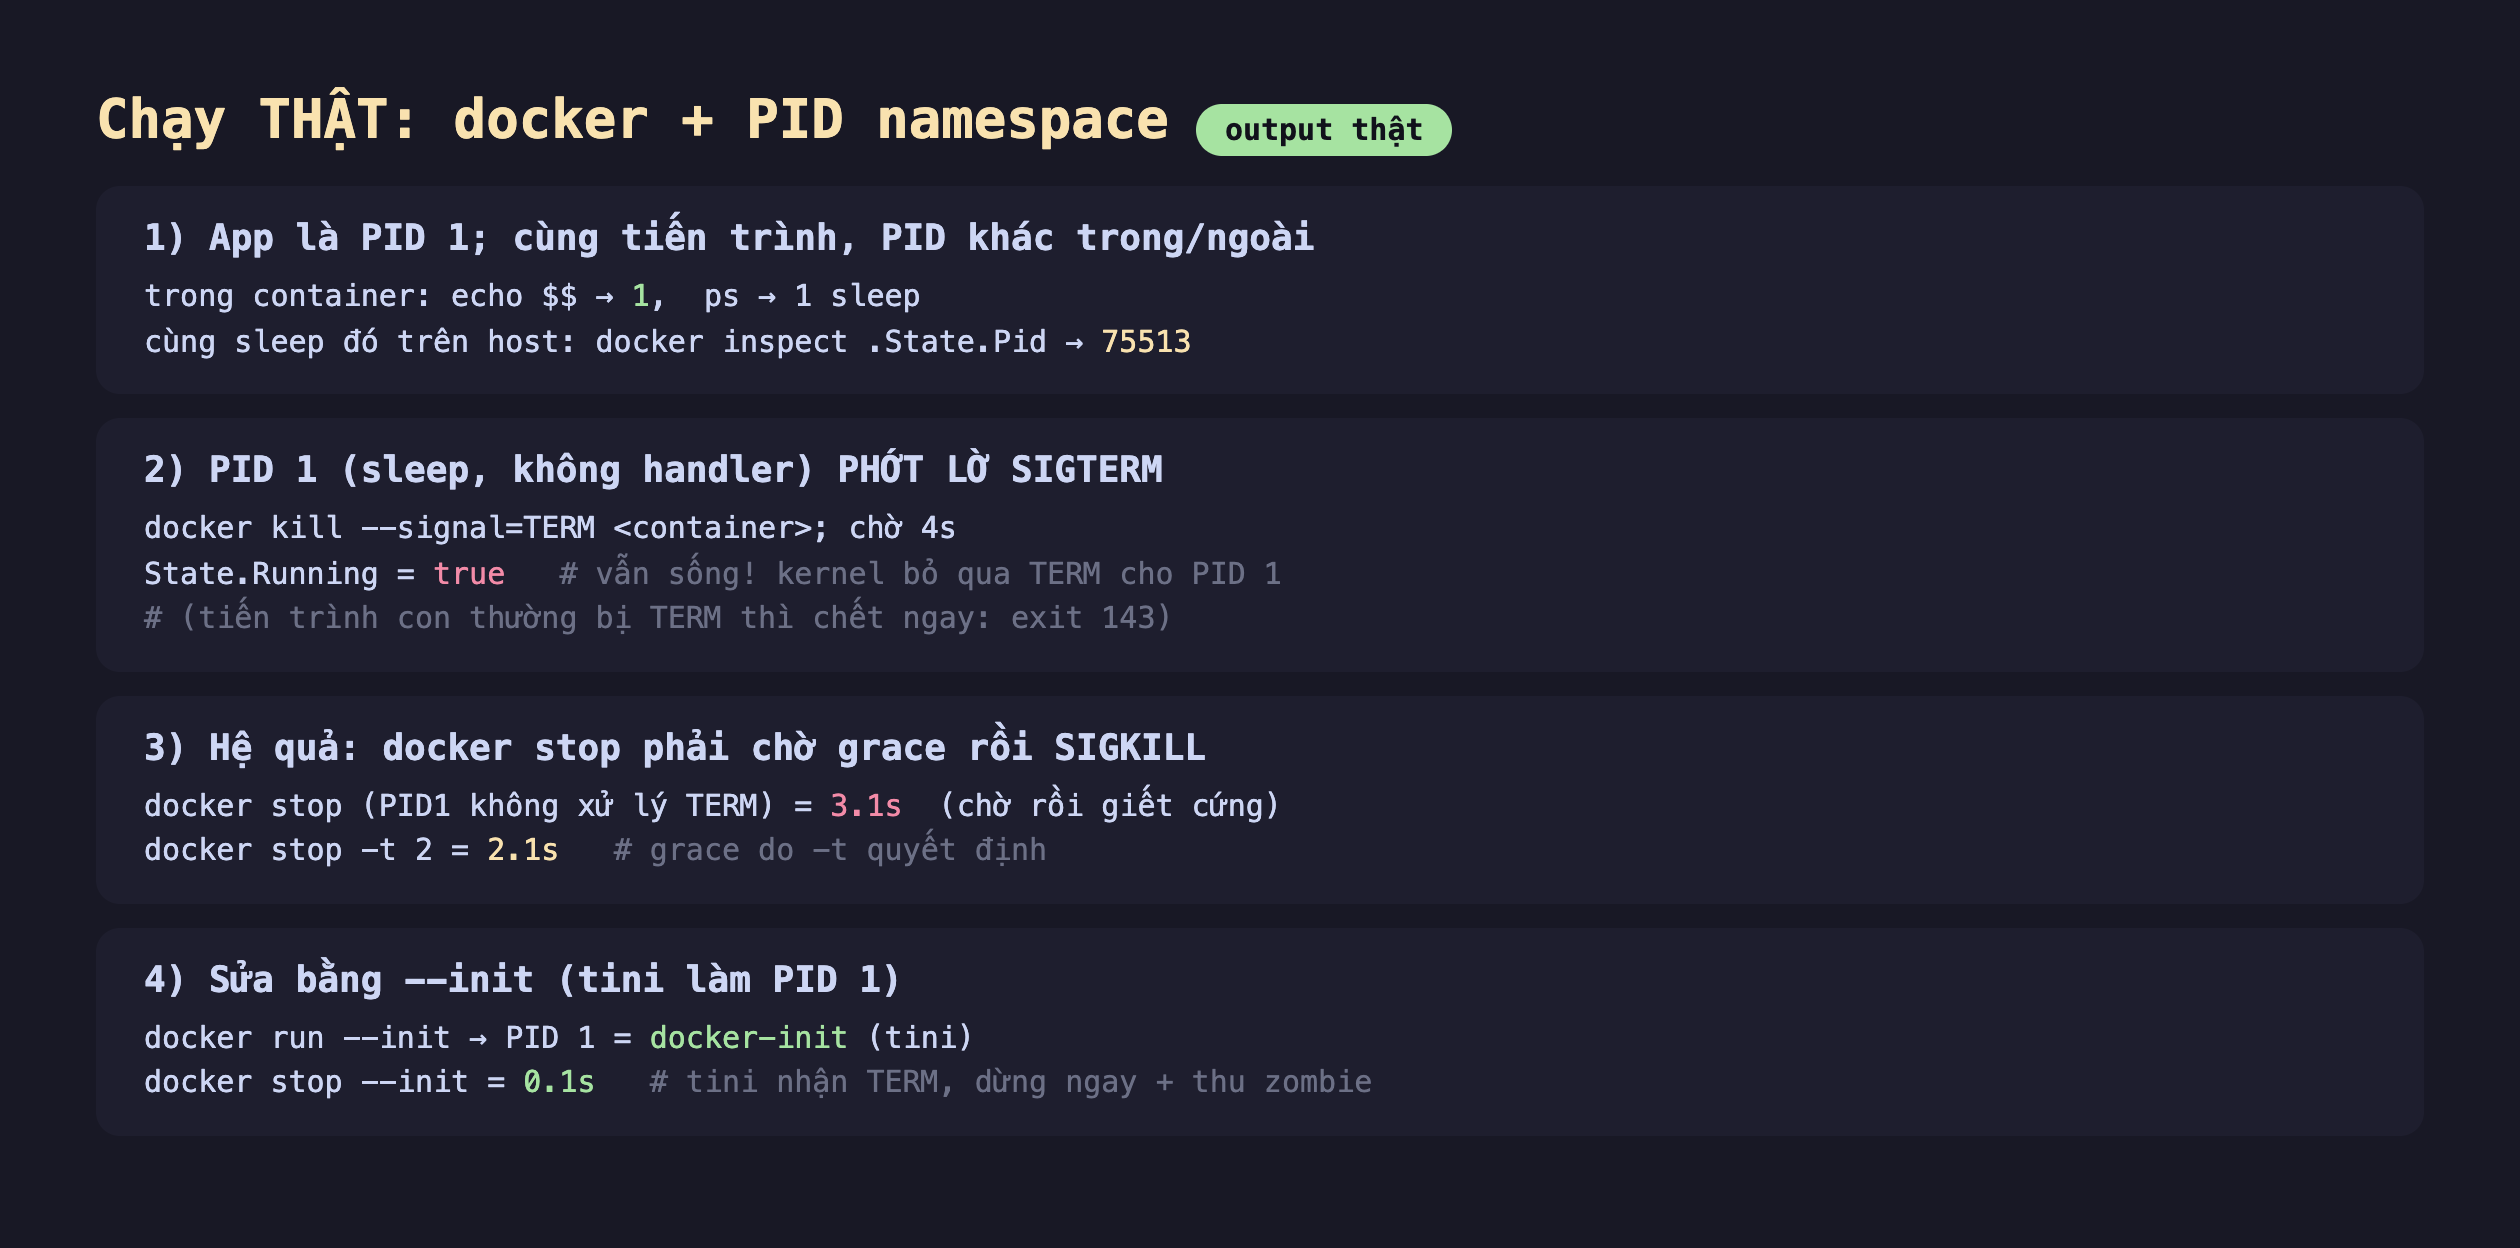
Hình 2: Chạy thật — app là PID 1 (PID host 75513); gửi SIGTERM cho PID 1 (sleep, không handler) → sau 4s State.Running=true (vẫn sống!); docker stop mất 3.1s (chờ grace rồi SIGKILL), -t 2 còn 2.1s; --init cho PID 1 = docker-init (tini) → docker stop chỉ 0.1s.
- PID 1 sống sót SIGTERM: chạy
alpine sleep 300(busybox exec luônsleepthành PID 1), gửiSIGTERM, chờ 4 giây — container vẫnRunning=true. Cùng tín hiệu đó gửi cho một tiến trình con thường sẽ giết nó ngay (exit 143). Đây là bằng chứng kernel bảo vệ PID 1. - Hệ quả cho
docker stop:docker stopgửiSIGTERMrồi chờ một khoảng ân hạn trước khiSIGKILL. Vì PID 1 không xử lý TERM, nó phớt lờ và bị giết cứng sau khi hết grace — đo thật 3.1s mặc định, vàdocker stop -t 2xuống 2.1s (grace do-tquyết định). BịSIGKILLnghĩa là app không kịp đóng kết nối, flush dữ liệu, dọn dẹp — nguy cơ mất dữ liệu.
Hai cách sửa
- Ứng dụng tự xử lý SIGTERM: cài handler để đóng gọn rồi thoát —
trap 'cleanup; exit 0' TERMtrong shell,signal.Notifytrong Go,process.on('SIGTERM')trong Node. Khi đódocker stopdừng ngay và sạch. - Dùng init nhỏ làm PID 1:
docker run --initchèntinilàm PID 1. tini nhận tín hiệu và chuyển tiếp xuống app, đồng thời thu tiến trình mồ côi (zombie). Đo thật: với--init, PID 1 làdocker-initvàdocker stopchỉ mất 0.1s.
Vì sao PID 1 còn phải "thu" tiến trình mồ côi
PID 1 mang thêm một trách nhiệm của init: khi một tiến trình cha chết, các con mồ côi được PID 1 "nhận nuôi", và PID 1 phải wait() chúng khi chúng kết thúc — nếu không, chúng thành zombie tích tụ trong bảng tiến trình. Một app bình thường (hay shell) không làm việc reaping này, nên trong container chạy nhiều tiến trình con (ví dụ shell gọi nhiều lệnh) có thể rò rỉ zombie. tini/--init lo hộ việc đó — thêm một lý do nên dùng khi app của bạn không phải là một init thực thụ.
Đánh đổi cần cân nhắc
Không phải app nào cũng cần --init. Nếu app của bạn đã xử lý SIGTERM đúng và không sinh tiến trình con mồ côi (nhiều server viết tốt làm được), thì --init là thừa. --init cần thiết nhất khi PID 1 là một script/shell, hoặc app không reaping con. Biết app mình thuộc loại nào; đừng thêm --init như một câu thần chú.
exec trong entrypoint script quan trọng. Một lỗi phổ biến: entrypoint là sh -c "myapp" — shell thành PID 1, myapp thành con, và tín hiệu gửi cho shell (PID 1) không tới myapp. Dùng exec myapp để myapp thay thế shell và trở thành PID 1 trực tiếp nhận tín hiệu. Đây là lý do nhiều Dockerfile viết ENTRYPOINT ["myapp"] (dạng exec) thay vì dạng shell.
Grace period phải đủ cho app đóng gọn. docker stop mặc định chờ 10s (theo tài liệu; đo trong môi trường này ~3s) rồi SIGKILL. Nếu app cần lâu hơn để flush (ghi buffer lớn, đóng nhiều kết nối), tăng bằng --time/STOPSIGNAL/stop_grace_period. Ngược lại, đặt quá dài làm deploy/restart chậm. Cân theo thời gian shutdown thật của app.
Ba ý mang về
- App trong container là PID 1: đo thật, tiến trình chính có PID 1 trong container nhưng PID khác (75513) trên host — cô lập bằng PID namespace, mỗi container một cây tiến trình.
- Kernel bỏ qua tín hiệu không-handler cho PID 1: đo thật, PID 1 (sleep) sống sót SIGTERM sau 4s, khiến
docker stopphải chờ grace rồi SIGKILL (3.1s) — app không xử lý SIGTERM bị tắt cứng, nguy cơ mất dữ liệu. - Sửa bằng xử lý SIGTERM hoặc
--init: đo thật--init(tini làm PID 1) kéodocker stopxuống 0.1s và thu zombie; nhớ dùngexectrong entrypoint để app thật sự thành PID 1 nhận tín hiệu.
Nguồn
- man7.org — pid_namespaces(7): https://man7.org/linux/man-pages/man7/pid_namespaces.7.html
- Docker docs — Specify an init process (
--init): https://docs.docker.com/reference/cli/docker/container/run/#init - tini — A tiny but valid init for containers: https://github.com/krallin/tini
Phần sau ta xem container có hệ thống file riêng thế nào: mount namespace, chroot/pivot_root, và vì sao mỗi container thấy một cây thư mục gốc / của riêng nó dù dùng chung kernel.
