Bạn mở top hoặc ps, thấy app của mình có cột bộ nhớ ghi 2GB, và tim đập nhanh — "sao nó ngốn 2GB RAM?". Nhưng rất có thể app đó chỉ đang dùng vài trăm MB RAM thật. Vấn đề là bạn đang nhìn nhầm cột. Linux báo cáo hai con số bộ nhớ rất khác nhau: VSZ (bộ nhớ ảo) và RSS (bộ nhớ thật), và nhầm lẫn giữa chúng dẫn tới hoảng loạn vô cớ hoặc bỏ sót rò rỉ thật. Bài này (phần 5 loạt Debug) chạy thật để thấy sự khác biệt và biết nhìn con số nào.
Hai con số bộ nhớ
- VSZ (Virtual Size): toàn bộ không gian địa chỉ ảo mà tiến trình đã "đặt chỗ" — gồm cả phần đã xin nhưng chưa dùng, các thư viện được map, file được map vào bộ nhớ. Đây là "hạn mức tối đa có thể", không phải mức đang dùng.
- RSS (Resident Set Size): lượng RAM vật lý thật tiến trình đang chiếm ngay lúc này. Đây là con số bạn quan tâm khi lo về bộ nhớ.
Nhầm VSZ với RAM thật là lỗi phổ biến. Một app có VSZ khổng lồ (vì map nhiều file hoặc xin trước bộ nhớ) mà RSS nhỏ thì hoàn toàn lành mạnh.
Vì sao VSZ > RSS: cấp phát lười
Điểm mấu chốt: khi chương trình xin bộ nhớ (malloc/mmap), kernel không giao RAM thật ngay — nó chỉ ghi sổ rằng "vùng địa chỉ này thuộc về bạn". Chỉ khi bạn chạm vào một trang (đọc/ghi), kernel mới xử lý một page fault và giao một trang RAM thật cho trang đó. Đây là cấp phát lười (lazy allocation).
m = mmap(500MB)   # VSZ tăng 500MB, nhưng RSS gần như không đổi (chưa chạm)
m[offset] = 1     # chạm một trang -> kernel giao RAM thật -> RSS tăng
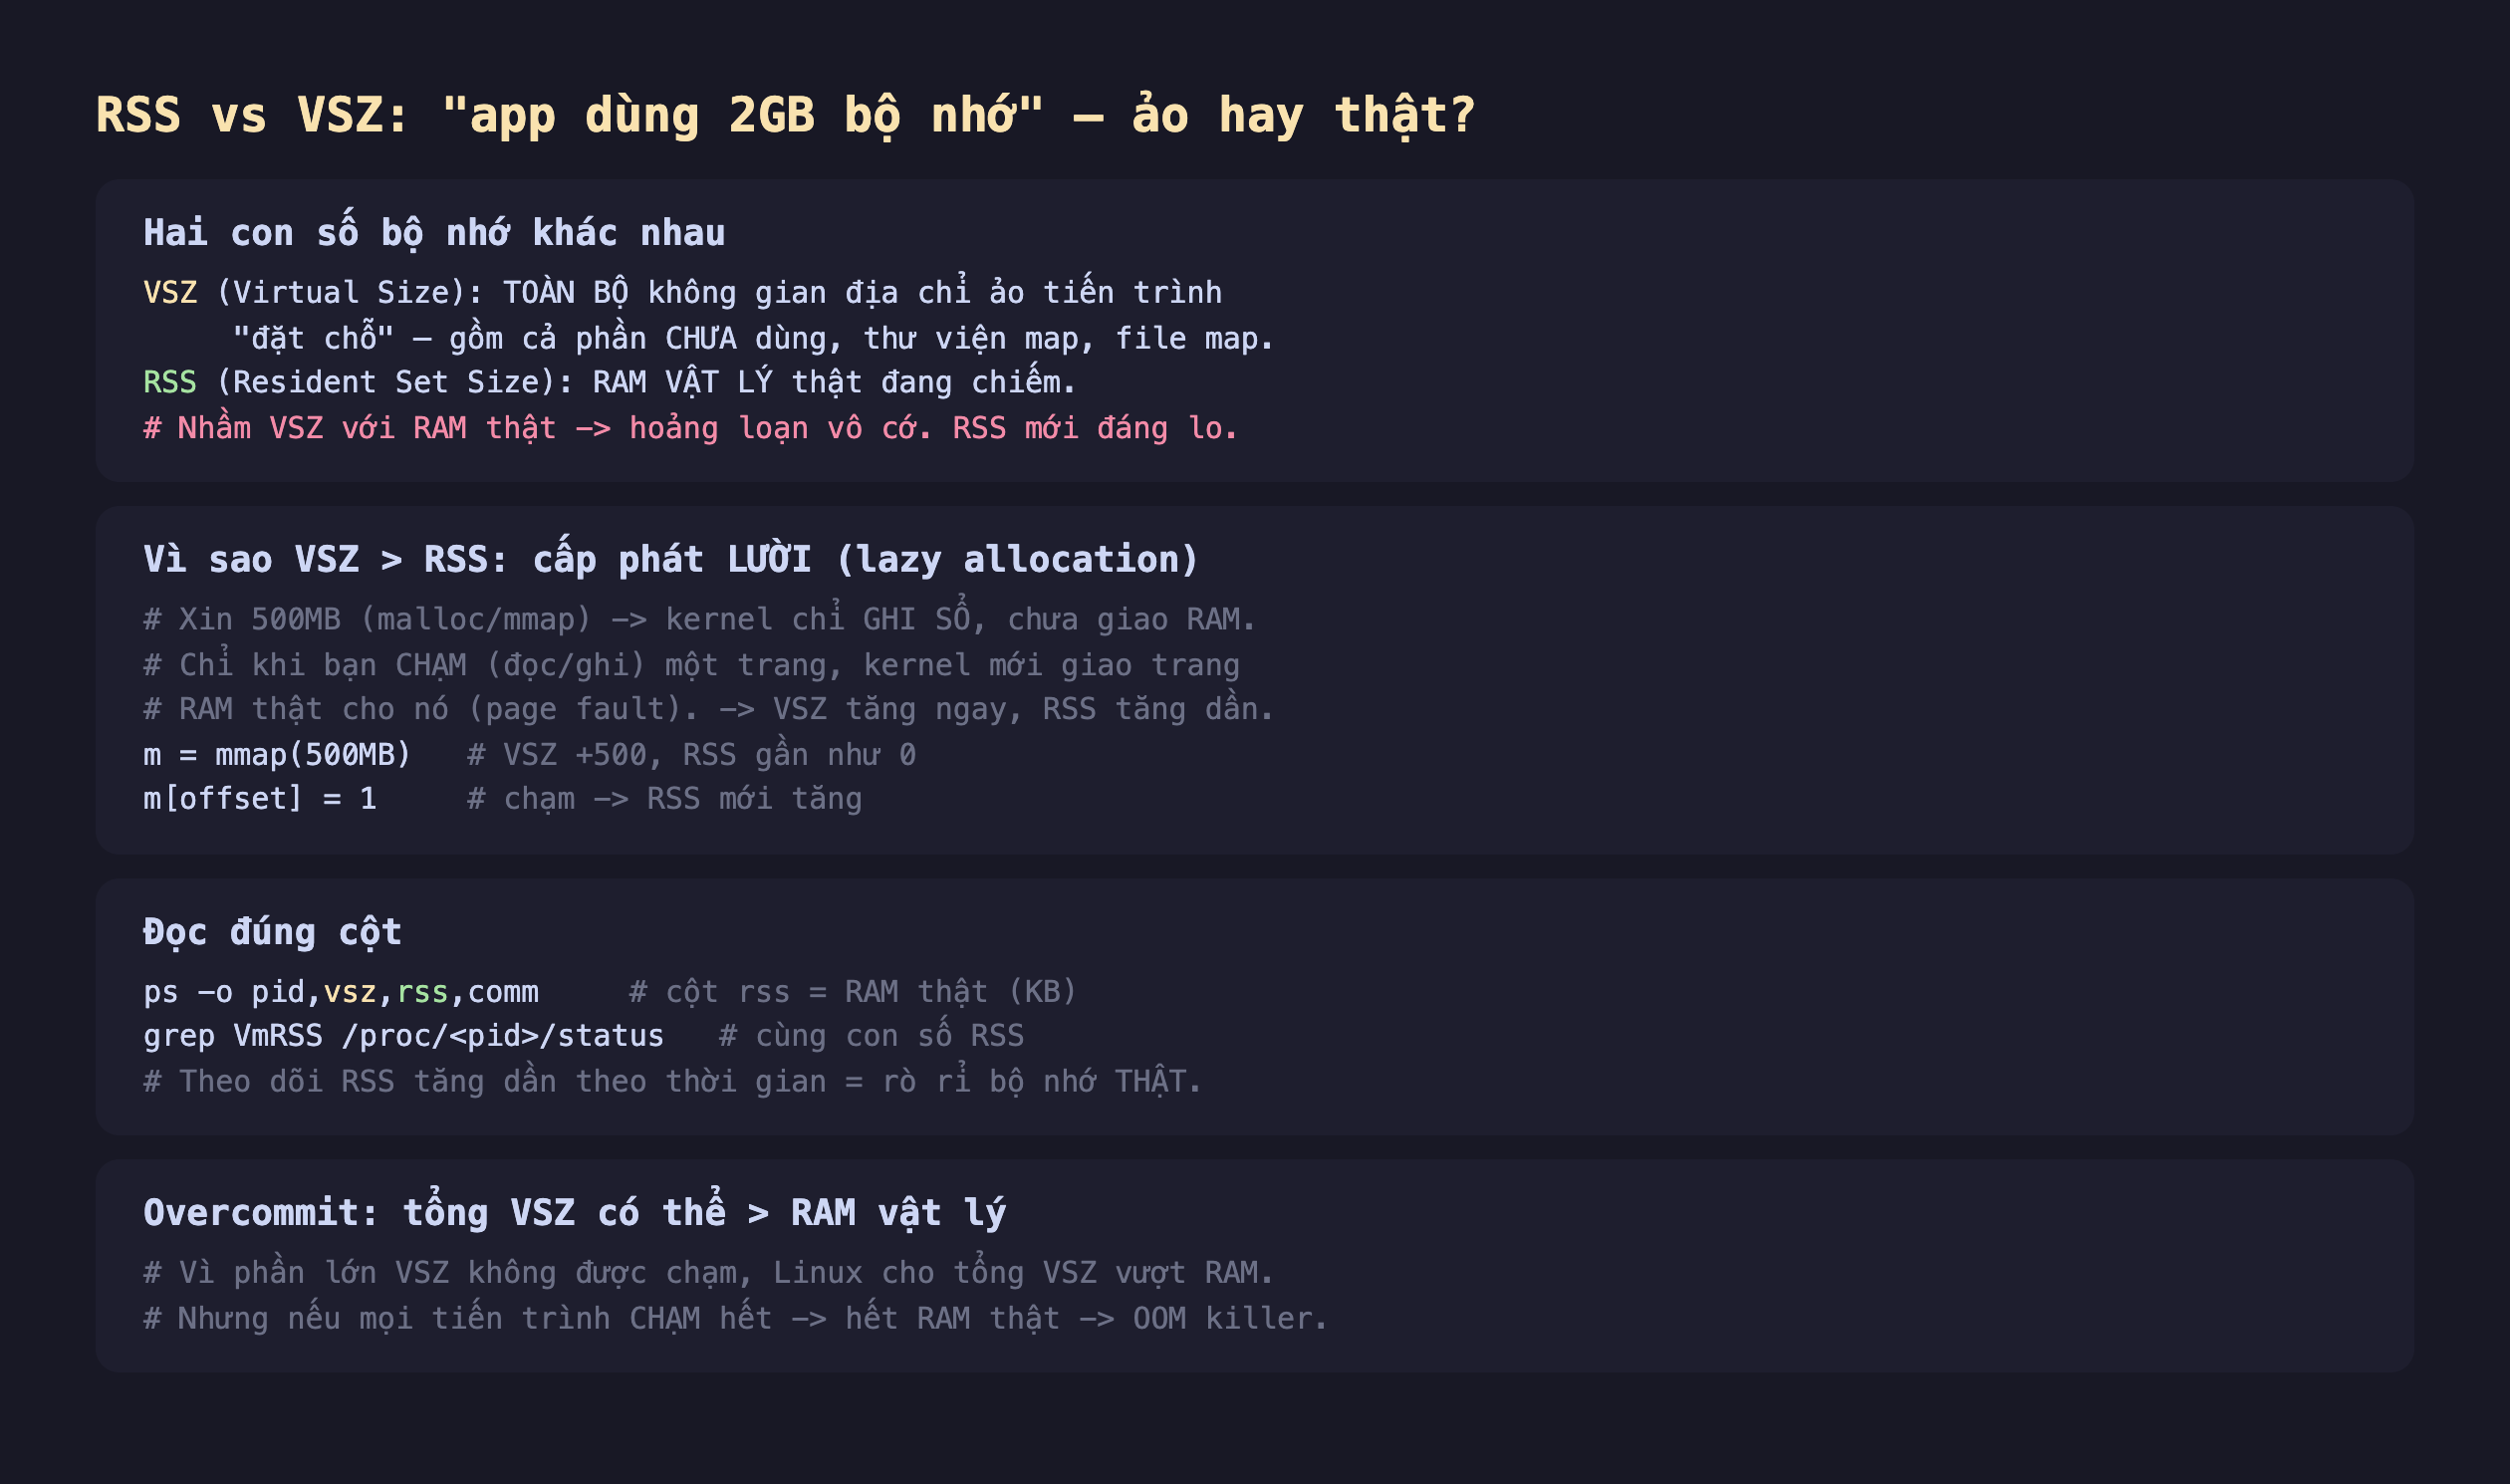
Hình 1: VSZ là không gian ảo đặt chỗ (gồm phần chưa dùng), RSS là RAM thật; cấp phát lười khiến VSZ tăng ngay khi xin nhưng RSS chỉ tăng khi chạm; đọc cột rss trong ps; overcommit cho tổng VSZ vượt RAM.
Đo thật: VSZ nhảy 500MB, RSS vẫn 7MB
Mình mmap 500MB rồi chạm dần, theo dõi VSZ và RSS qua /proc/<pid>/status:
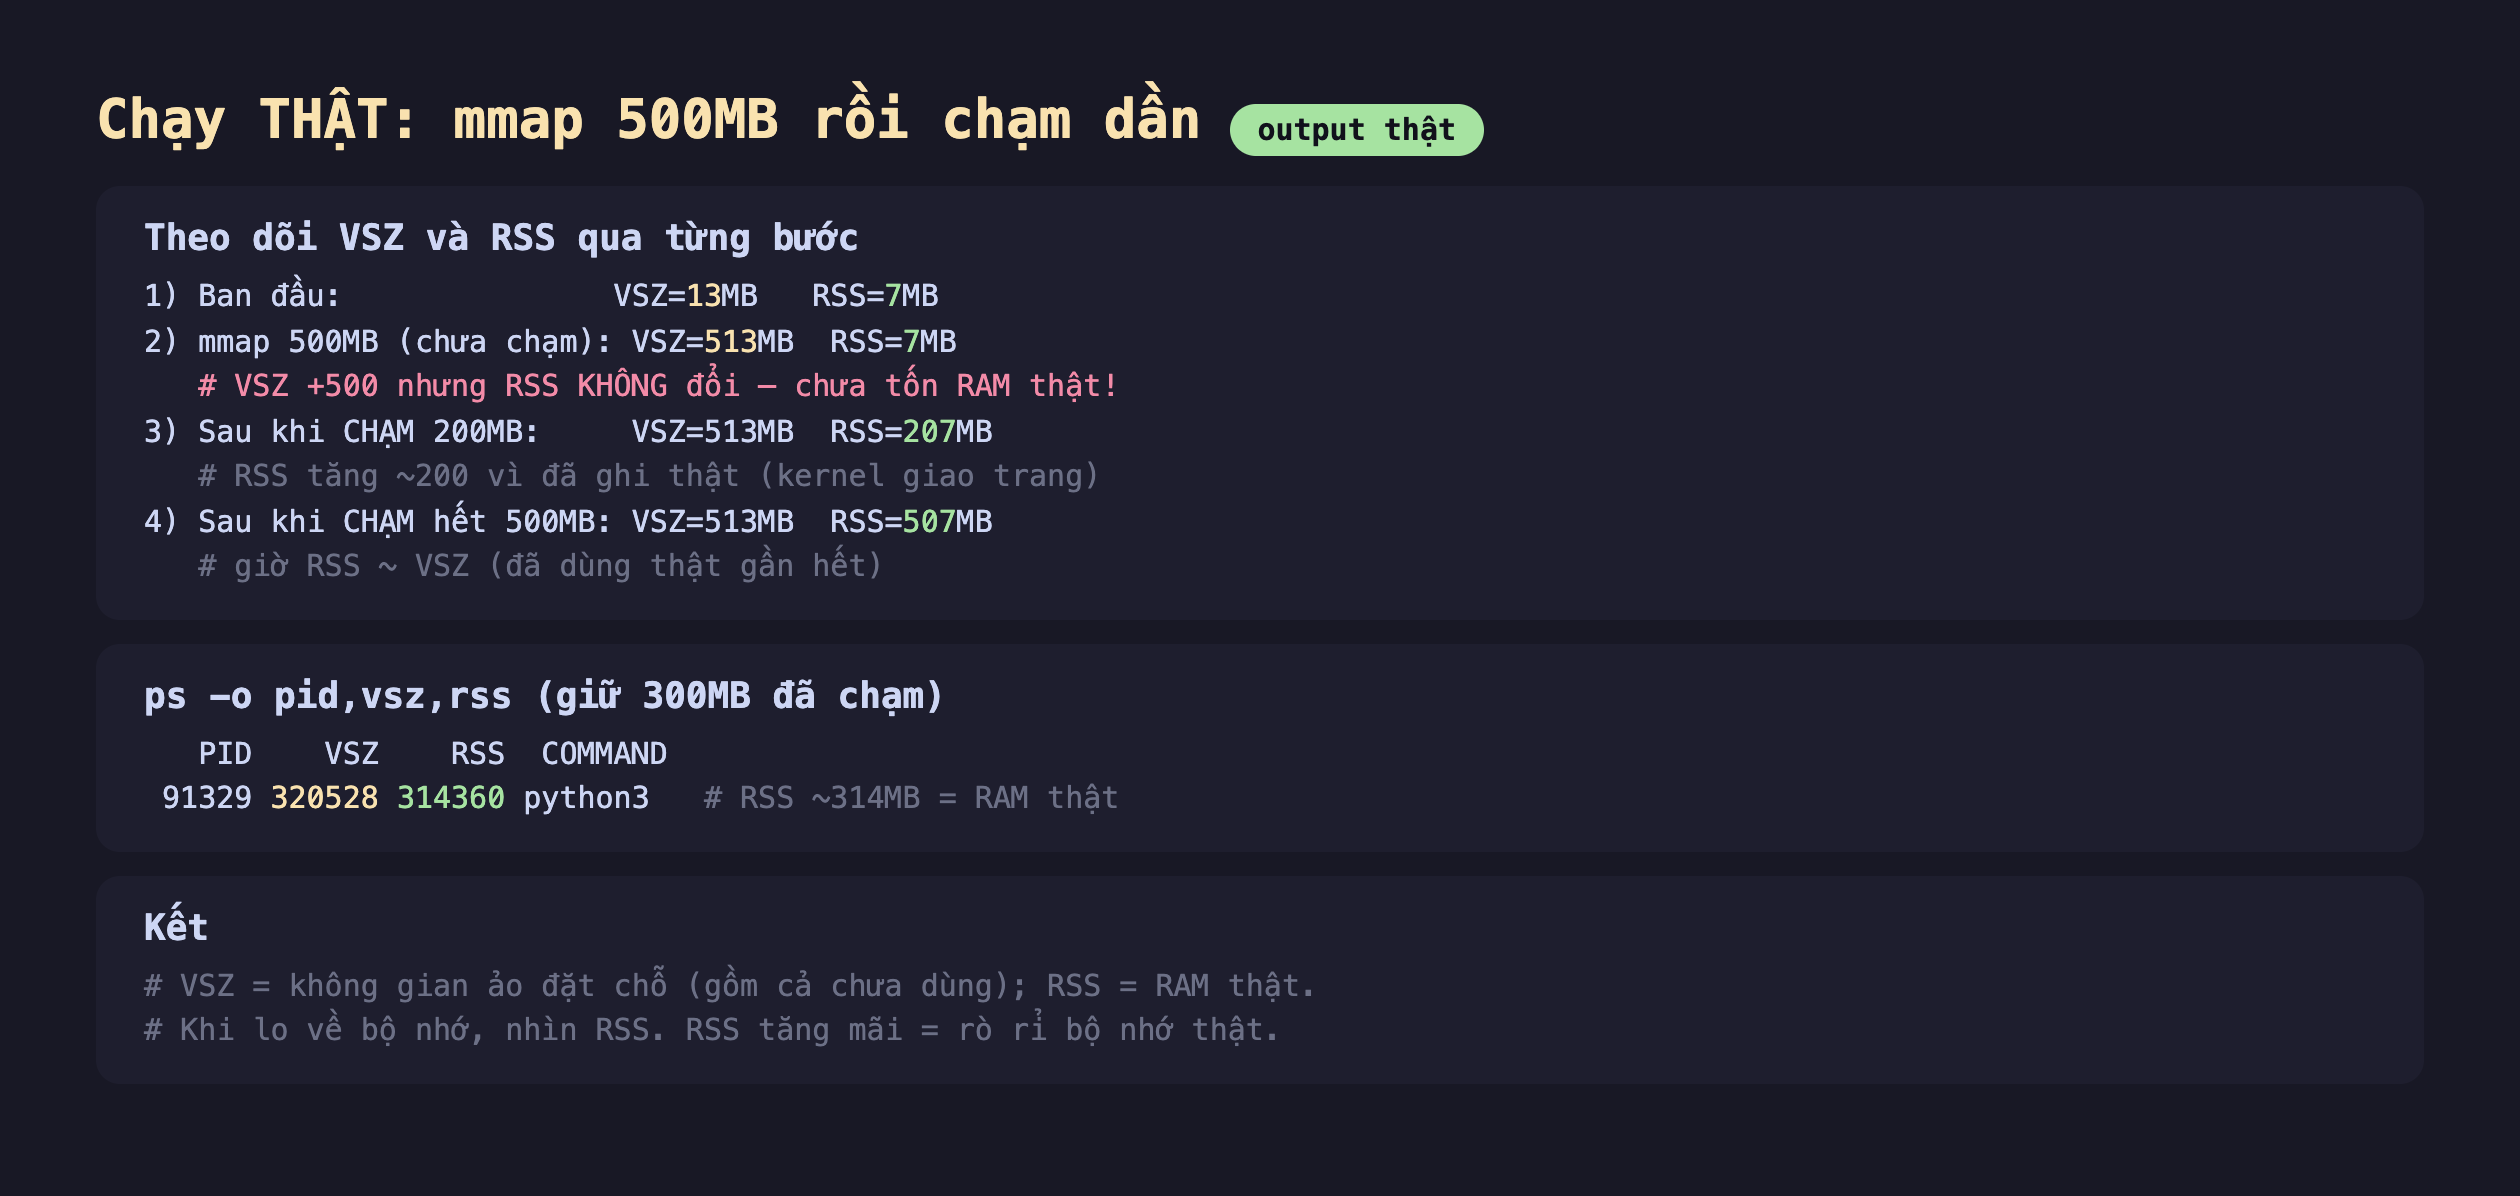
Hình 2: Chạy thật — ban đầu VSZ=13MB/RSS=7MB; sau mmap 500MB VSZ nhảy lên 513MB nhưng RSS vẫn 7MB (chưa chạm, chưa tốn RAM); chạm 200MB → RSS lên 207MB; chạm hết → RSS 507MB ≈ VSZ; ps cho RSS 314360KB cho tiến trình giữ 300MB đã chạm.
- VSZ tăng, RSS không: xin 500MB làm VSZ nhảy từ 13MB lên 513MB, nhưng RSS vẫn 7MB — chưa một byte RAM thật nào bị dùng, vì mình chưa chạm vào vùng đó. Đây chính là điều khiến một app có VSZ khổng lồ mà RAM thật nhỏ.
- RSS tăng khi chạm: ghi vào 200MB đầu → RSS lên ~207MB (kernel giao trang thật cho phần đã ghi). Ghi hết 500MB → RSS ~507MB ≈ VSZ. RSS chỉ phản ánh phần thực sự được dùng.
- Đọc đúng cột:
ps -o pid,vsz,rss,commcho cả hai; cộtrss(314360KB ≈ 314MB cho tiến trình giữ 300MB đã chạm) là RAM thật.topcũng có cộtRES= RSS. Đây là con số cần theo dõi.
Đánh đổi cần cân nhắc
Theo dõi RSS tăng dần để bắt rò rỉ bộ nhớ thật. Như rò rỉ fd ở bài trước, rò rỉ bộ nhớ hiện ra là RSS tăng không ngừng theo thời gian (cấp phát mà không giải phóng). Một lần chụp RSS không nói lên gì; theo dõi xu hướng (watch grep VmRSS /proc/$pid/status) mới thấy. RSS ổn định ở một mức = lành mạnh; RSS bò lên mãi = rò rỉ.
RSS gồm cả bộ nhớ chia sẻ — có thể đếm trùng. RSS của một tiến trình bao gồm các trang chia sẻ (thư viện dùng chung, file map chung). Nếu cộng RSS của nhiều tiến trình dùng chung một thư viện, bạn đếm trùng phần chia sẻ đó. Để đo bộ nhớ riêng thực sự của một tiến trình, xem PSS (Proportional Set Size, trong /proc/<pid>/smaps_rollup) — nó chia đều phần chia sẻ. Với ước lượng nhanh RSS đủ dùng; với kế toán bộ nhớ chính xác dùng PSS.
Overcommit: tổng VSZ có thể vượt RAM vật lý — nhưng có giới hạn. Vì phần lớn VSZ thường không được chạm, Linux cho phép tổng VSZ của mọi tiến trình vượt RAM vật lý (overcommit). Điều này thường an toàn, nhưng nếu các tiến trình bỗng chạm hết phần đã xin, RAM thật cạn và OOM killer ra tay giết một tiến trình (như bài cgroups). Đây là lý do đặt --memory cho container theo RSS đỉnh thật, không theo VSZ.
Ba ý mang về
- VSZ là ảo (đặt chỗ), RSS là RAM thật: đo thật
mmap 500MBlàm VSZ nhảy lên 513MB nhưng RSS vẫn 7MB — không tốn RAM cho tới khi chạm. Đừng hoảng vì VSZ lớn; nhìn RSS. - Cấp phát lười giải thích khoảng cách: đo thật RSS chỉ tăng khi ghi thật (200MB→RSS 207MB, 500MB→RSS 507MB) vì kernel giao trang RAM theo page fault, không giao ngay lúc xin.
- Đọc đúng cột và theo dõi xu hướng: cột
rsstrongps(hayREStrong top,VmRSStrong/proc) là RAM thật; RSS tăng mãi = rò rỉ bộ nhớ; và nhớ RSS đếm trùng bộ nhớ chia sẻ (dùng PSS để chính xác), overcommit có thể dẫn tới OOM.
Nguồn
- man7.org — proc_pid_status(5) (VmSize, VmRSS): https://man7.org/linux/man-pages/man5/proc_pid_status.5.html
- man7.org — ps(1) (vsz, rss): https://man7.org/linux/man-pages/man1/ps.1.html
- Kernel docs — Overcommit Accounting: https://docs.kernel.org/mm/overcommit-accounting.html
Phần sau ta phân tích một chương trình chậm: time cho real/user/sys — ba con số này khác nhau thế nào cho biết chương trình bị chặn ở CPU hay ở I/O, và cách đọc chúng để chẩn đoán đúng hướng.
