Phần 9 đo giới hạn tài nguyên của tiến trình trong container. Phần này đo một đặc thù khác, thứ gây ra hai sự cố vận hành kinh điển: deploy chậm vì container không chịu dừng, và bảng tiến trình rò rỉ zombie. Cả hai bắt nguồn từ cùng một chỗ: tiến trình đầu tiên trong container mang PID 1, và kernel đối xử với PID 1 khác hẳn mọi tiến trình thường. PID 1 là "init" của container, nhận hai trách nhiệm đặc biệt mà một ứng dụng bình thường không được thiết kế để làm: xử lý tín hiệu đúng cách và thu dọn tiến trình con mồ côi. Khi một app trần được nhét vào làm PID 1 mà không biết hai vai trò đó, nó dừng sai và rò rỉ. Bài này đo chính xác cả hai hiện tượng bằng docker stop, exit code, và đếm tiến trình zombie thật trong /proc.
PID 1 là tiến trình đặc biệt, kernel đối xử khác
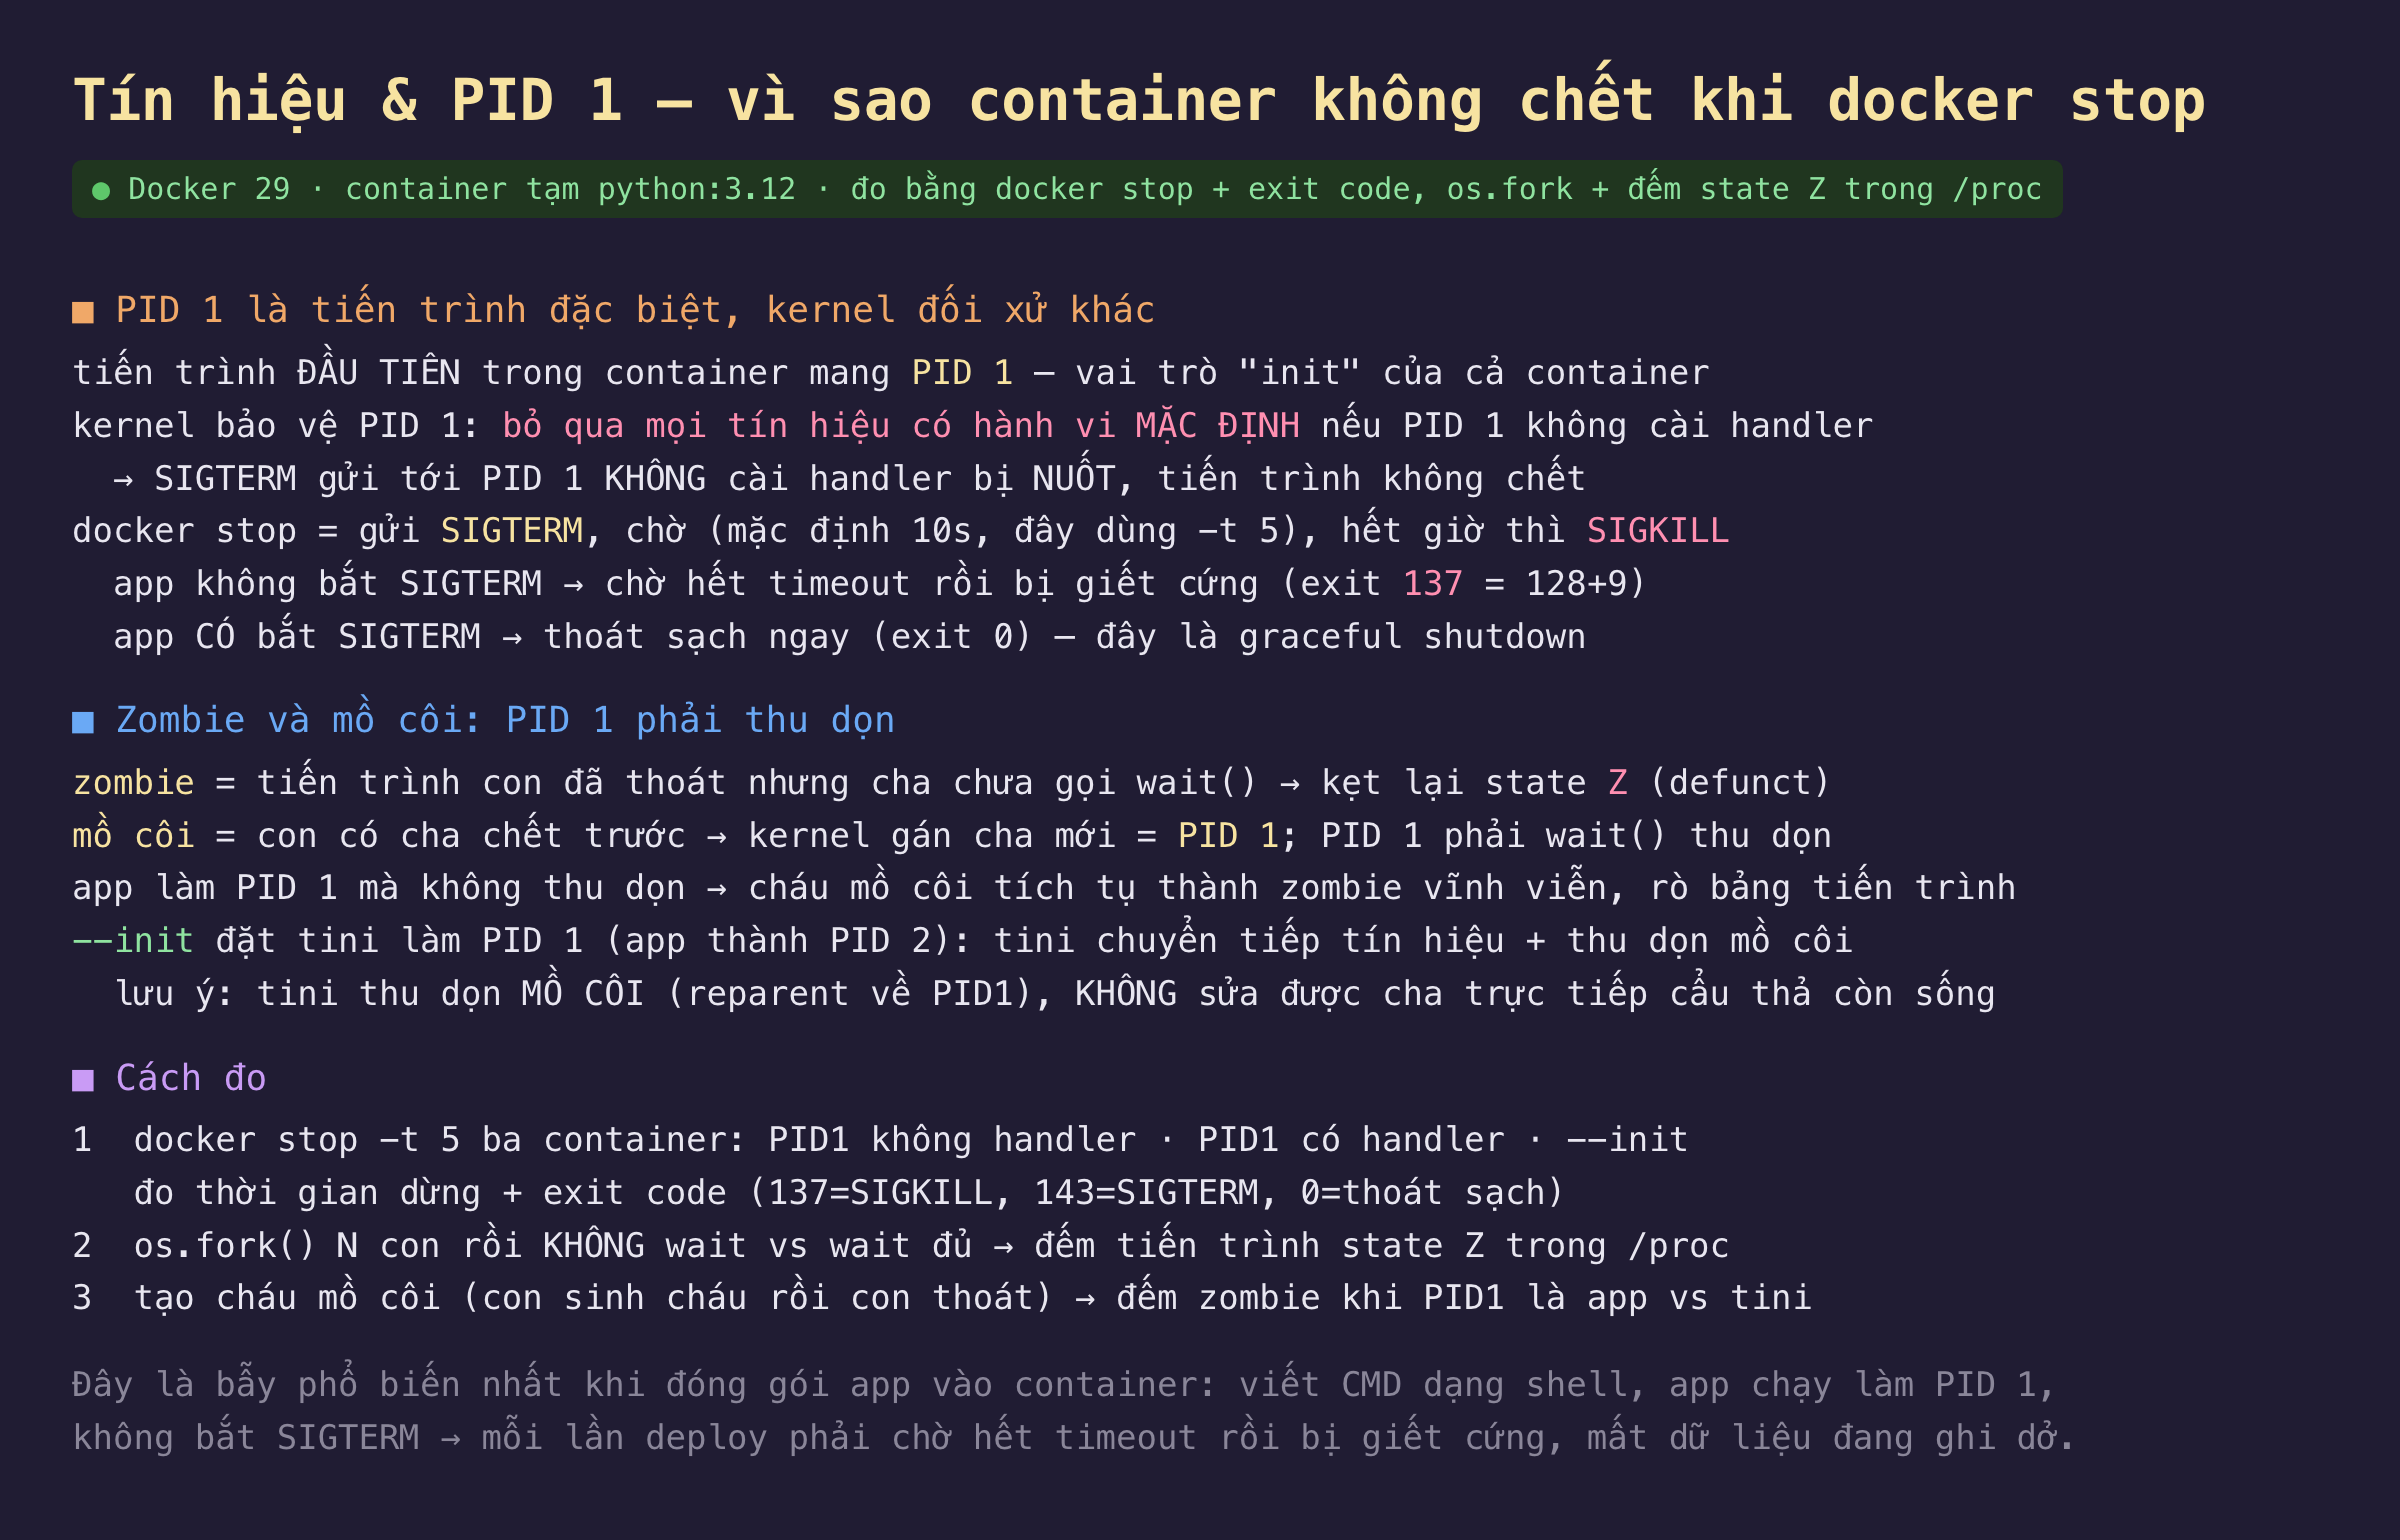
Hình 1: PID 1 được kernel bảo vệ khỏi tín hiệu mặc định, phải thu dọn tiến trình mồ côi, và ba cách đo bằng docker stop cùng os.fork.
Mọi container khởi động bằng cách chạy một tiến trình, và tiến trình đó nhận PID 1. Trên một hệ thống Linux thường, PID 1 là systemd hoặc một chương trình init được viết riêng cho vai trò này. Trong container, PID 1 thường là chính ứng dụng của bạn, và đó là gốc rễ của vấn đề, vì kernel dành cho PID 1 hai cách đối xử đặc biệt mà ứng dụng thường không lường trước. Thứ nhất là tín hiệu: kernel bỏ qua mọi tín hiệu có hành vi mặc định gửi tới PID 1 nếu PID 1 không cài handler cho tín hiệu đó. Nghĩa là SIGTERM, tín hiệu "hãy dừng lại một cách lịch sự", bị nuốt mất nếu app làm PID 1 không chủ động bắt nó. Cơ chế này bảo vệ tiến trình init khỏi bị giết nhầm, nhưng với một app không được viết để làm init, hệ quả là nó phớt lờ yêu cầu dừng.
Điều này va chạm trực tiếp với cách docker stop hoạt động: nó gửi SIGTERM, chờ một khoảng (mặc định 10 giây, bài này dùng -t 5 cho nhanh), rồi nếu container còn sống thì gửi SIGKILL, tín hiệu giết cứng không thể bắt hay bỏ qua. Vậy một app làm PID 1 không bắt SIGTERM sẽ phớt lờ tín hiệu đầu, chờ hết timeout, rồi bị SIGKILL kết liễu; exit code của nó là 137, tức 128 cộng 9, dấu hiệu bị giết bởi tín hiệu số 9. Ngược lại, app có cài handler SIGTERM sẽ nhận tín hiệu, dọn dẹp và thoát sạch với exit 0 ngay lập tức, đó chính là graceful shutdown.
Trách nhiệm đặc biệt thứ hai là thu dọn tiến trình con. Một zombie là tiến trình con đã thoát nhưng cha chưa gọi wait() để đọc kết quả; nó kẹt lại ở state Z, defunct, chiếm một ô trong bảng tiến trình. Một tiến trình mồ côi là con có cha chết trước nó; kernel lập tức gán cha mới cho nó, và cha mới luôn là PID 1. Vậy PID 1 có nghĩa vụ wait() thu dọn mọi tiến trình mồ côi được gán cho mình. Nếu app làm PID 1 không làm việc này, cháu mồ côi tích tụ thành zombie vĩnh viễn, rò rỉ bảng tiến trình cho tới khi container chết. Cách chữa chuẩn là cờ --init: nó đặt một init tối giản tên tini làm PID 1, đẩy app xuống PID 2; tini chuyển tiếp tín hiệu cho app và thu dọn mồ côi. Một lưu ý quan trọng và hay bị bỏ qua: tini chỉ thu dọn mồ côi được reparent về PID 1, nó không sửa được lỗi cha trực tiếp còn sống mà cẩu thả không wait() con của chính mình, đó là bug của app.
Cách đo gồm ba phần: chạy ba container rồi docker stop -t 5, đo thời gian dừng và exit code cho trường hợp PID 1 không handler, PID 1 có handler, và --init; fork N con rồi không wait so với wait đủ, đếm tiến trình state Z; và tạo cháu mồ côi bằng cách cho con sinh cháu rồi con thoát ngay, đếm zombie khi PID 1 là app so với khi PID 1 là tini.
Đo thật: chờ 5,1 giây rồi bị giết, so với 0,1 giây thoát sạch
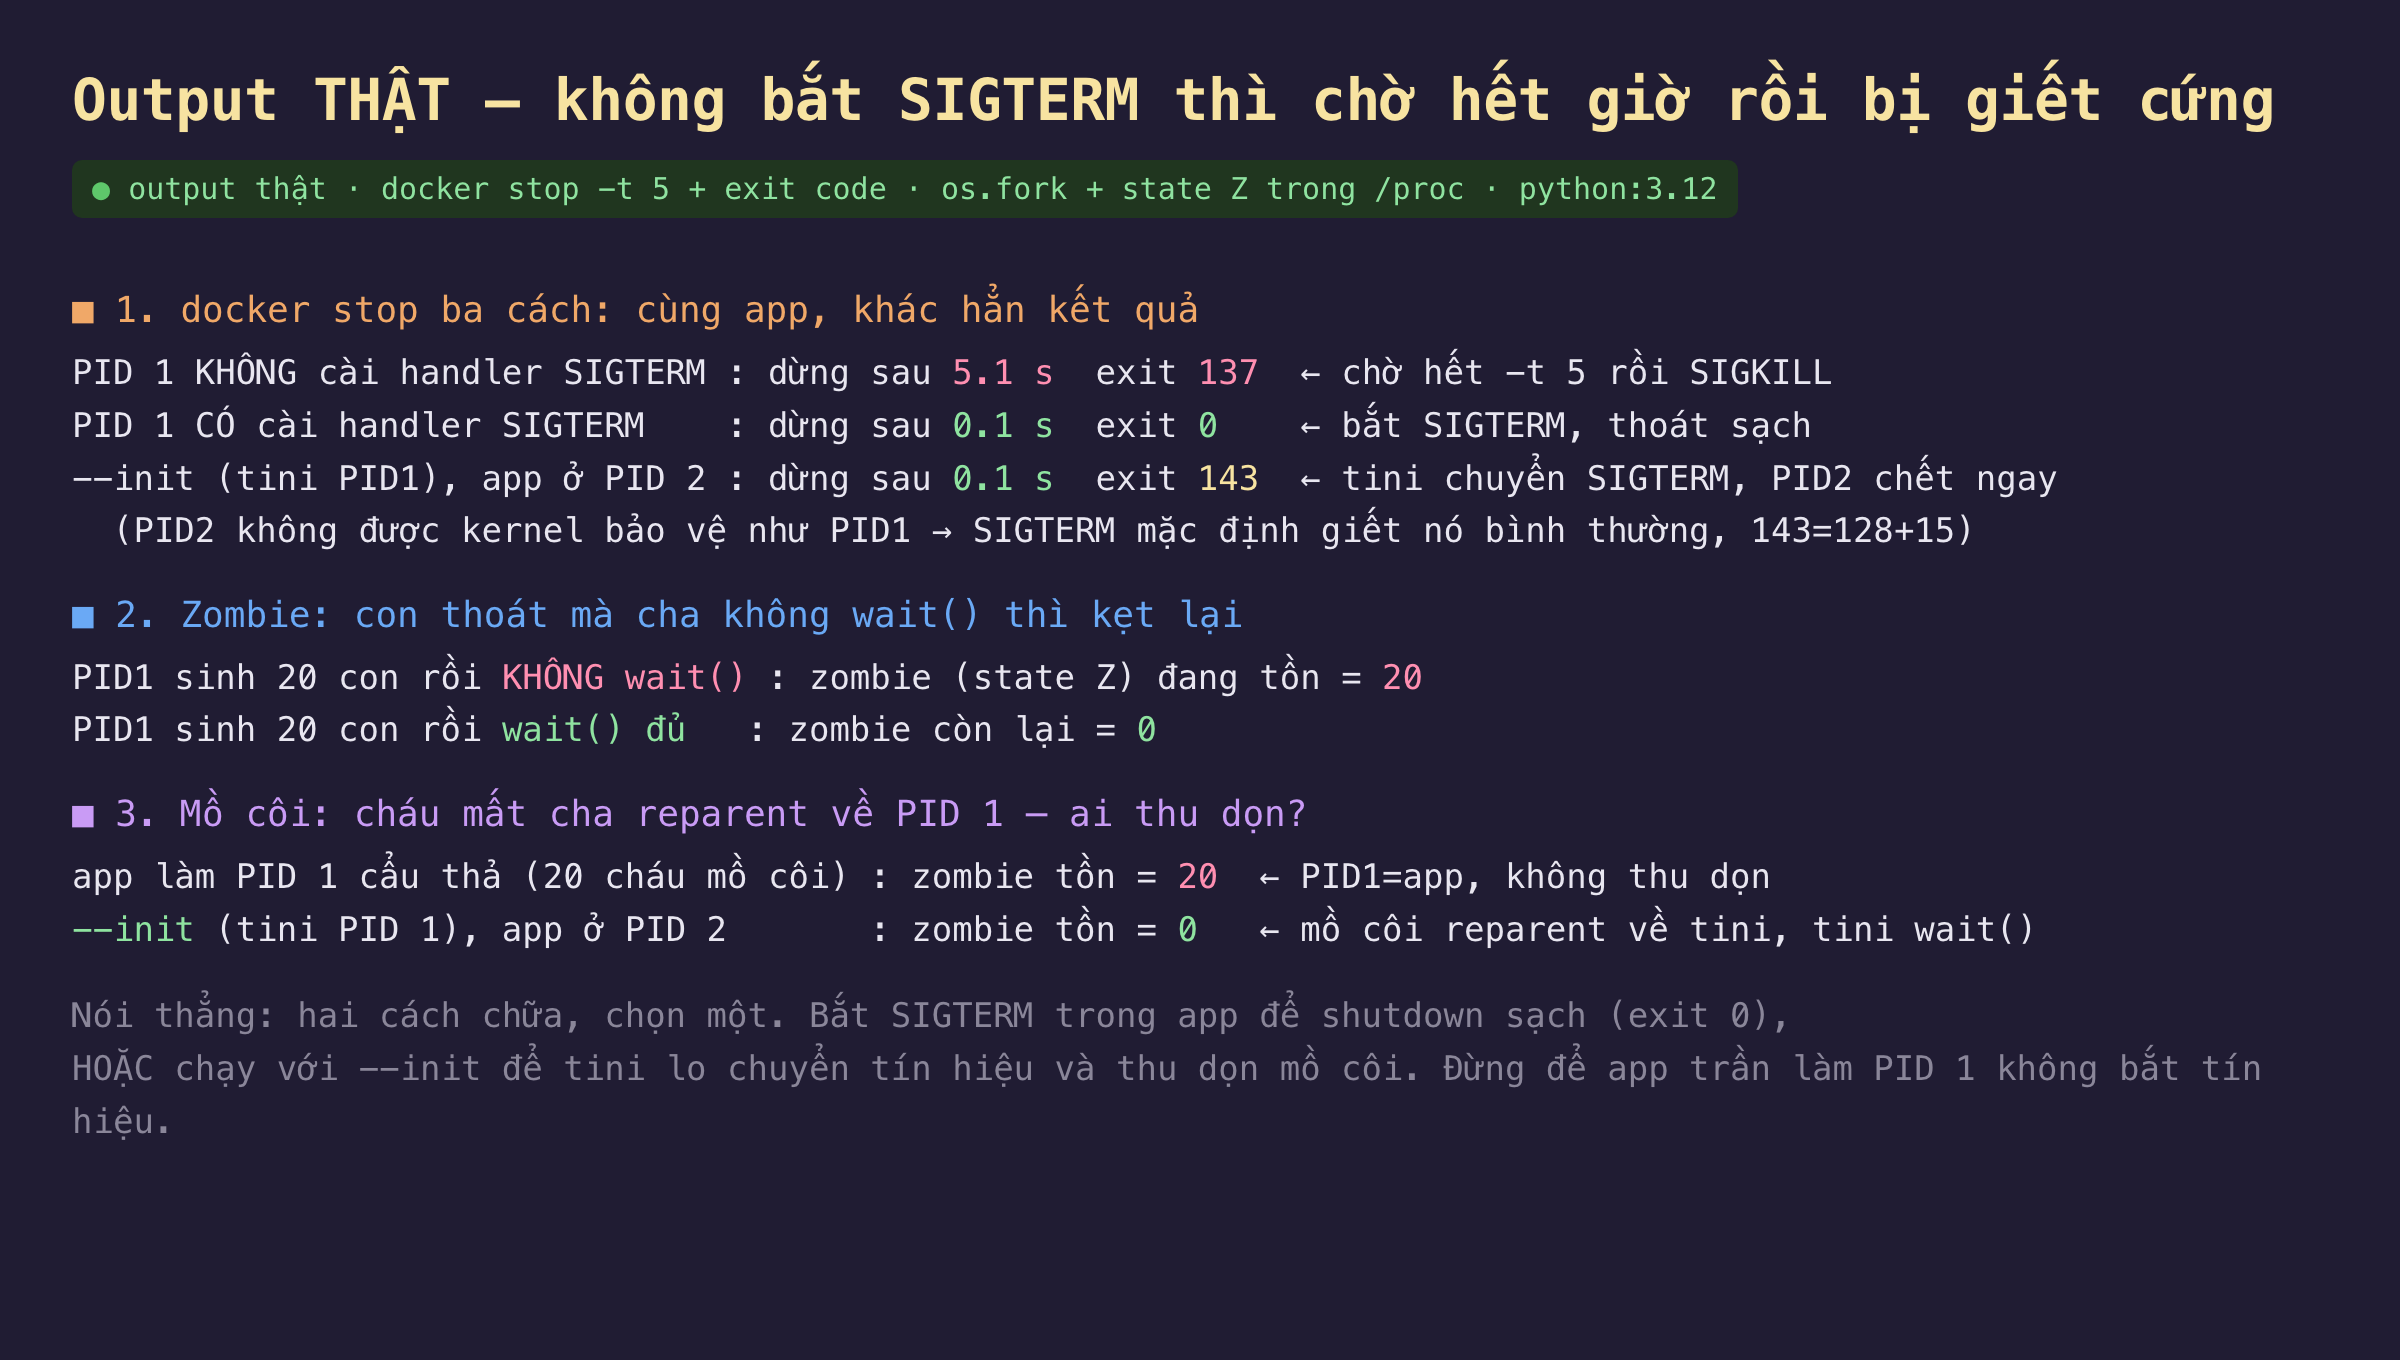
Hình 2: Không bắt SIGTERM thì chờ hết timeout rồi SIGKILL, và cháu mồ côi tích tụ 20 zombie khi app làm PID 1 nhưng về 0 với --init.
| phép đo | kết quả |
|---|---|
PID 1 không handler SIGTERM, docker stop -t 5 |
5,1 giây, exit 137 (SIGKILL) |
PID 1 có handler SIGTERM, docker stop -t 5 |
0,1 giây, exit 0 (thoát sạch) |
--init (tini PID 1), app PID 2, docker stop -t 5 |
0,1 giây, exit 143 (SIGTERM) |
fork 20 con, không wait() |
20 zombie (state Z) |
fork 20 con, wait() đủ |
0 zombie |
| 20 cháu mồ côi, app làm PID 1 cẩu thả | 20 zombie |
20 cháu mồ côi, --init (tini PID 1) |
0 zombie |
Không bắt SIGTERM, container chờ hết timeout rồi bị giết cứng. Container đầu chạy một app làm PID 1 không cài handler SIGTERM. Gọi docker stop -t 5 lên nó mất 5,1 giây và kết thúc với exit code 137. Con số kể toàn bộ câu chuyện: docker stop gửi SIGTERM, nhưng vì app là PID 1 không có handler, kernel nuốt tín hiệu và app vẫn ngủ; Docker chờ đủ 5 giây timeout, rồi gửi SIGKILL; exit 137 là 128 cộng 9, xác nhận bị giết bởi tín hiệu 9. Đây đúng là trải nghiệm bực mình khi deploy: mỗi lần dừng container phải chờ trọn timeout, và việc giết cứng không cho app cơ hội đóng kết nối cơ sở dữ liệu hay ghi nốt dữ liệu đang dở.
Bắt SIGTERM, app thoát sạch trong một phần mười giây. Container thứ hai chạy cùng app nhưng cài một handler SIGTERM gọi sys.exit(0). docker stop -t 5 lên nó mất 0,1 giây và exit 0. App nhận tín hiệu, chạy logic dọn dẹp, thoát sạch, và Docker không cần dùng tới SIGKILL. Đây là graceful shutdown đúng nghĩa, và nó chỉ cần vài dòng code bắt tín hiệu. Container thứ ba cho thấy cách khác không cần sửa app: chạy với --init, tini làm PID 1 còn app xuống PID 2. docker stop -t 5 mất 0,1 giây, exit 143, tức 128 cộng 15, bị kết thúc bởi SIGTERM. tini chuyển tiếp SIGTERM xuống app ở PID 2, và vì PID 2 không được kernel bảo vệ như PID 1, tín hiệu với hành vi mặc định giết nó bình thường và nhanh. Cùng một app trần, chỉ thêm một cờ, và hành vi dừng chuyển từ chờ hết timeout sang dừng tức thì.
Zombie tích tụ khi không ai thu dọn, và --init là người thu dọn đó. Phần hai đo trực tiếp định nghĩa zombie: một tiến trình fork 20 con rồi thoát ngay mà không wait(), để lại đúng 20 tiến trình state Z trong /proc; cùng tiến trình đó nếu wait() đủ 20 con thì còn 0 zombie. Phần ba đo tình huống thực tế hơn, cháu mồ côi: con sinh cháu rồi con thoát ngay, khiến cháu bị reparent về PID 1. Khi app làm PID 1 và chỉ thu dọn con trực tiếp của nó mà bỏ mặc cháu mồ côi, 20 cháu đó đọng lại thành 20 zombie, vì PID 1 chính là app và nó không wait(). Chạy cùng kịch bản với --init, cháu mồ côi reparent về tini ở PID 1, tini wait() chúng, và số zombie về 0. Đây là công việc thật mà một init làm và một app bình thường không làm: liên tục thu dọn mọi tiến trình mồ côi được gán cho PID 1.
Đánh đổi cần cân nhắc
Dùng exec form trong Dockerfile, đừng dùng shell form. Một nguyên nhân phổ biến khiến app vô tình làm PID 1 sai cách là viết CMD app chạy dạng shell thay vì CMD ["app", "chạy"] dạng exec. Dạng shell khiến Docker chạy /bin/sh -c "app chạy", nên PID 1 là sh, còn app là con của sh; khi đó sh nhận SIGTERM nhưng nhiều shell không chuyển tiếp nó xuống con, và app không bao giờ thấy tín hiệu. Dạng exec cho app trực tiếp làm PID 1, để nó nhận tín hiệu, với điều kiện app có cài handler. Đây là lỗi âm thầm: container vẫn chạy đúng, chỉ dừng chậm, nên dễ lọt qua test và chỉ lộ ra khi deploy thật.
Chọn một trong hai cách chữa, không cần cả hai. Có hai con đường tới một container dừng đúng và không rò zombie. Cách thứ nhất là viết app để nó tự xử lý: bắt SIGTERM, chạy shutdown sạch, và nếu app có sinh tiến trình con thì wait() chúng. Cách thứ hai là chạy với --init để tini lo cả chuyển tín hiệu lẫn thu dọn mồ côi, không đụng vào code. Với app đơn giản không sinh tiến trình con, chỉ cần bắt SIGTERM là đủ. Với app chạy nhiều tiến trình con hoặc dùng thư viện sinh tiến trình ngầm, --init an toàn hơn vì nó bắt cả những mồ côi mà app không biết tới. Nhiều nền tảng như Kubernetes cũng có cơ chế init tương đương; điểm chung là đừng để một app trần không bắt tín hiệu làm PID 1.
Phạm vi đo. Bài đo SIGTERM, exit code, và đếm zombie bằng state Z, không đi vào chi tiết cách tini chuyển tiếp nhóm tín hiệu đầy đủ hay xử lý process group. Timeout dùng -t 5 cho nhanh; mặc định của docker stop là 10 giây, nên hậu quả thực tế của việc không bắt tín hiệu còn lớn gấp đôi. Chưa đo tương tác với SIGINT khi chạy container ở foreground, chưa đo trường hợp app cần thời gian shutdown dài hơn timeout và bị cắt giữa chừng, và chưa đo các init thay thế tini như dumb-init, những biến thể không đổi kết luận về vai trò đặc biệt của PID 1.
Ba ý mang về
- PID 1 bị kernel bỏ qua tín hiệu mặc định nếu không cài handler. App làm PID 1 không bắt
SIGTERMthìdocker stopchờ hết timeout rồiSIGKILL: 5,1 giây và exit 137, mất cơ hội shutdown sạch. - Bắt SIGTERM hoặc chạy --init để dừng tức thì. Có handler cho exit 0 trong 0,1 giây;
--initđẩy app xuống PID 2 không được bảo vệ nênSIGTERMgiết nó ngay, exit 143. - PID 1 phải thu dọn tiến trình mồ côi. App PID 1 cẩu thả để 20 cháu mồ côi thành zombie;
--initcho tini thu dọn về 0. tini chỉ dọn mồ côi reparent về PID 1, không sửa cha trực tiếp cẩu thả.
Nguồn
- Linux
signal(7)— hành vi tín hiệu đặc biệt với PID 1, SIG_DFL bị bỏ qua: https://man7.org/linux/man-pages/man7/signal.7.html - Linux
wait(2)— zombie, thu dọn con, reparent mồ côi về PID 1: https://man7.org/linux/man-pages/man2/wait.2.html - Docker —
docker stop, SIGTERM rồi SIGKILL sau timeout: https://docs.docker.com/reference/cli/docker/container/stop/ - Docker — cờ
--initvà tini: https://docs.docker.com/engine/containers/run/#specify-an-init-process - tini — init tối giản cho container, thu dọn zombie và chuyển tín hiệu: https://github.com/krallin/tini
- Kubernetes — Pod lifecycle, xử lý tín hiệu termination và grace period: https://kubernetes.io/docs/concepts/workloads/pods/pod-lifecycle/#pod-termination
Phần sau quay lại cgroups để đo bộ nhớ ở mức chi tiết hơn phần 4: không chỉ OOM khi vượt trần, mà RSS so với page cache, và memory pressure khi cgroup gần chạm giới hạn. Xem kernel đẩy cache ra sao dưới áp lực, đọc memory.current, memory.stat và memory.pressure thật để thấy một container sống sót hay bị giết khi bộ nhớ căng.
