Hầu hết lập trình viên backend chạy ứng dụng của mình trong container mỗi ngày mà không cần biết bên trong đó có gì, và điều đó phần lớn là ổn. Nhưng khi một sự cố xảy ra, một tiến trình bị giết không rõ lý do, một cổng không nối được, một giới hạn tài nguyên siết nhầm, thì cái "phần lớn là ổn" ấy sụp xuống, và câu hỏi đầu tiên luôn là: container thật ra là cái gì. Sê-ri này trả lời bằng cách đo, không bằng cách tin. Phần đầu tiên bắt đầu từ nền tảng: namespace, cơ chế Linux làm cho một tiến trình trong container nhìn thấy một thế giới khác với tiến trình ngoài nó, dù cả hai chạy trên cùng một kernel. Chúng ta sẽ dựng hai container thật và đo xem chúng bị cô lập ở đâu, chia sẻ cái gì, và vì sao điều đó quan trọng với bảo mật.
Namespace là gì và cách kiểm chứng
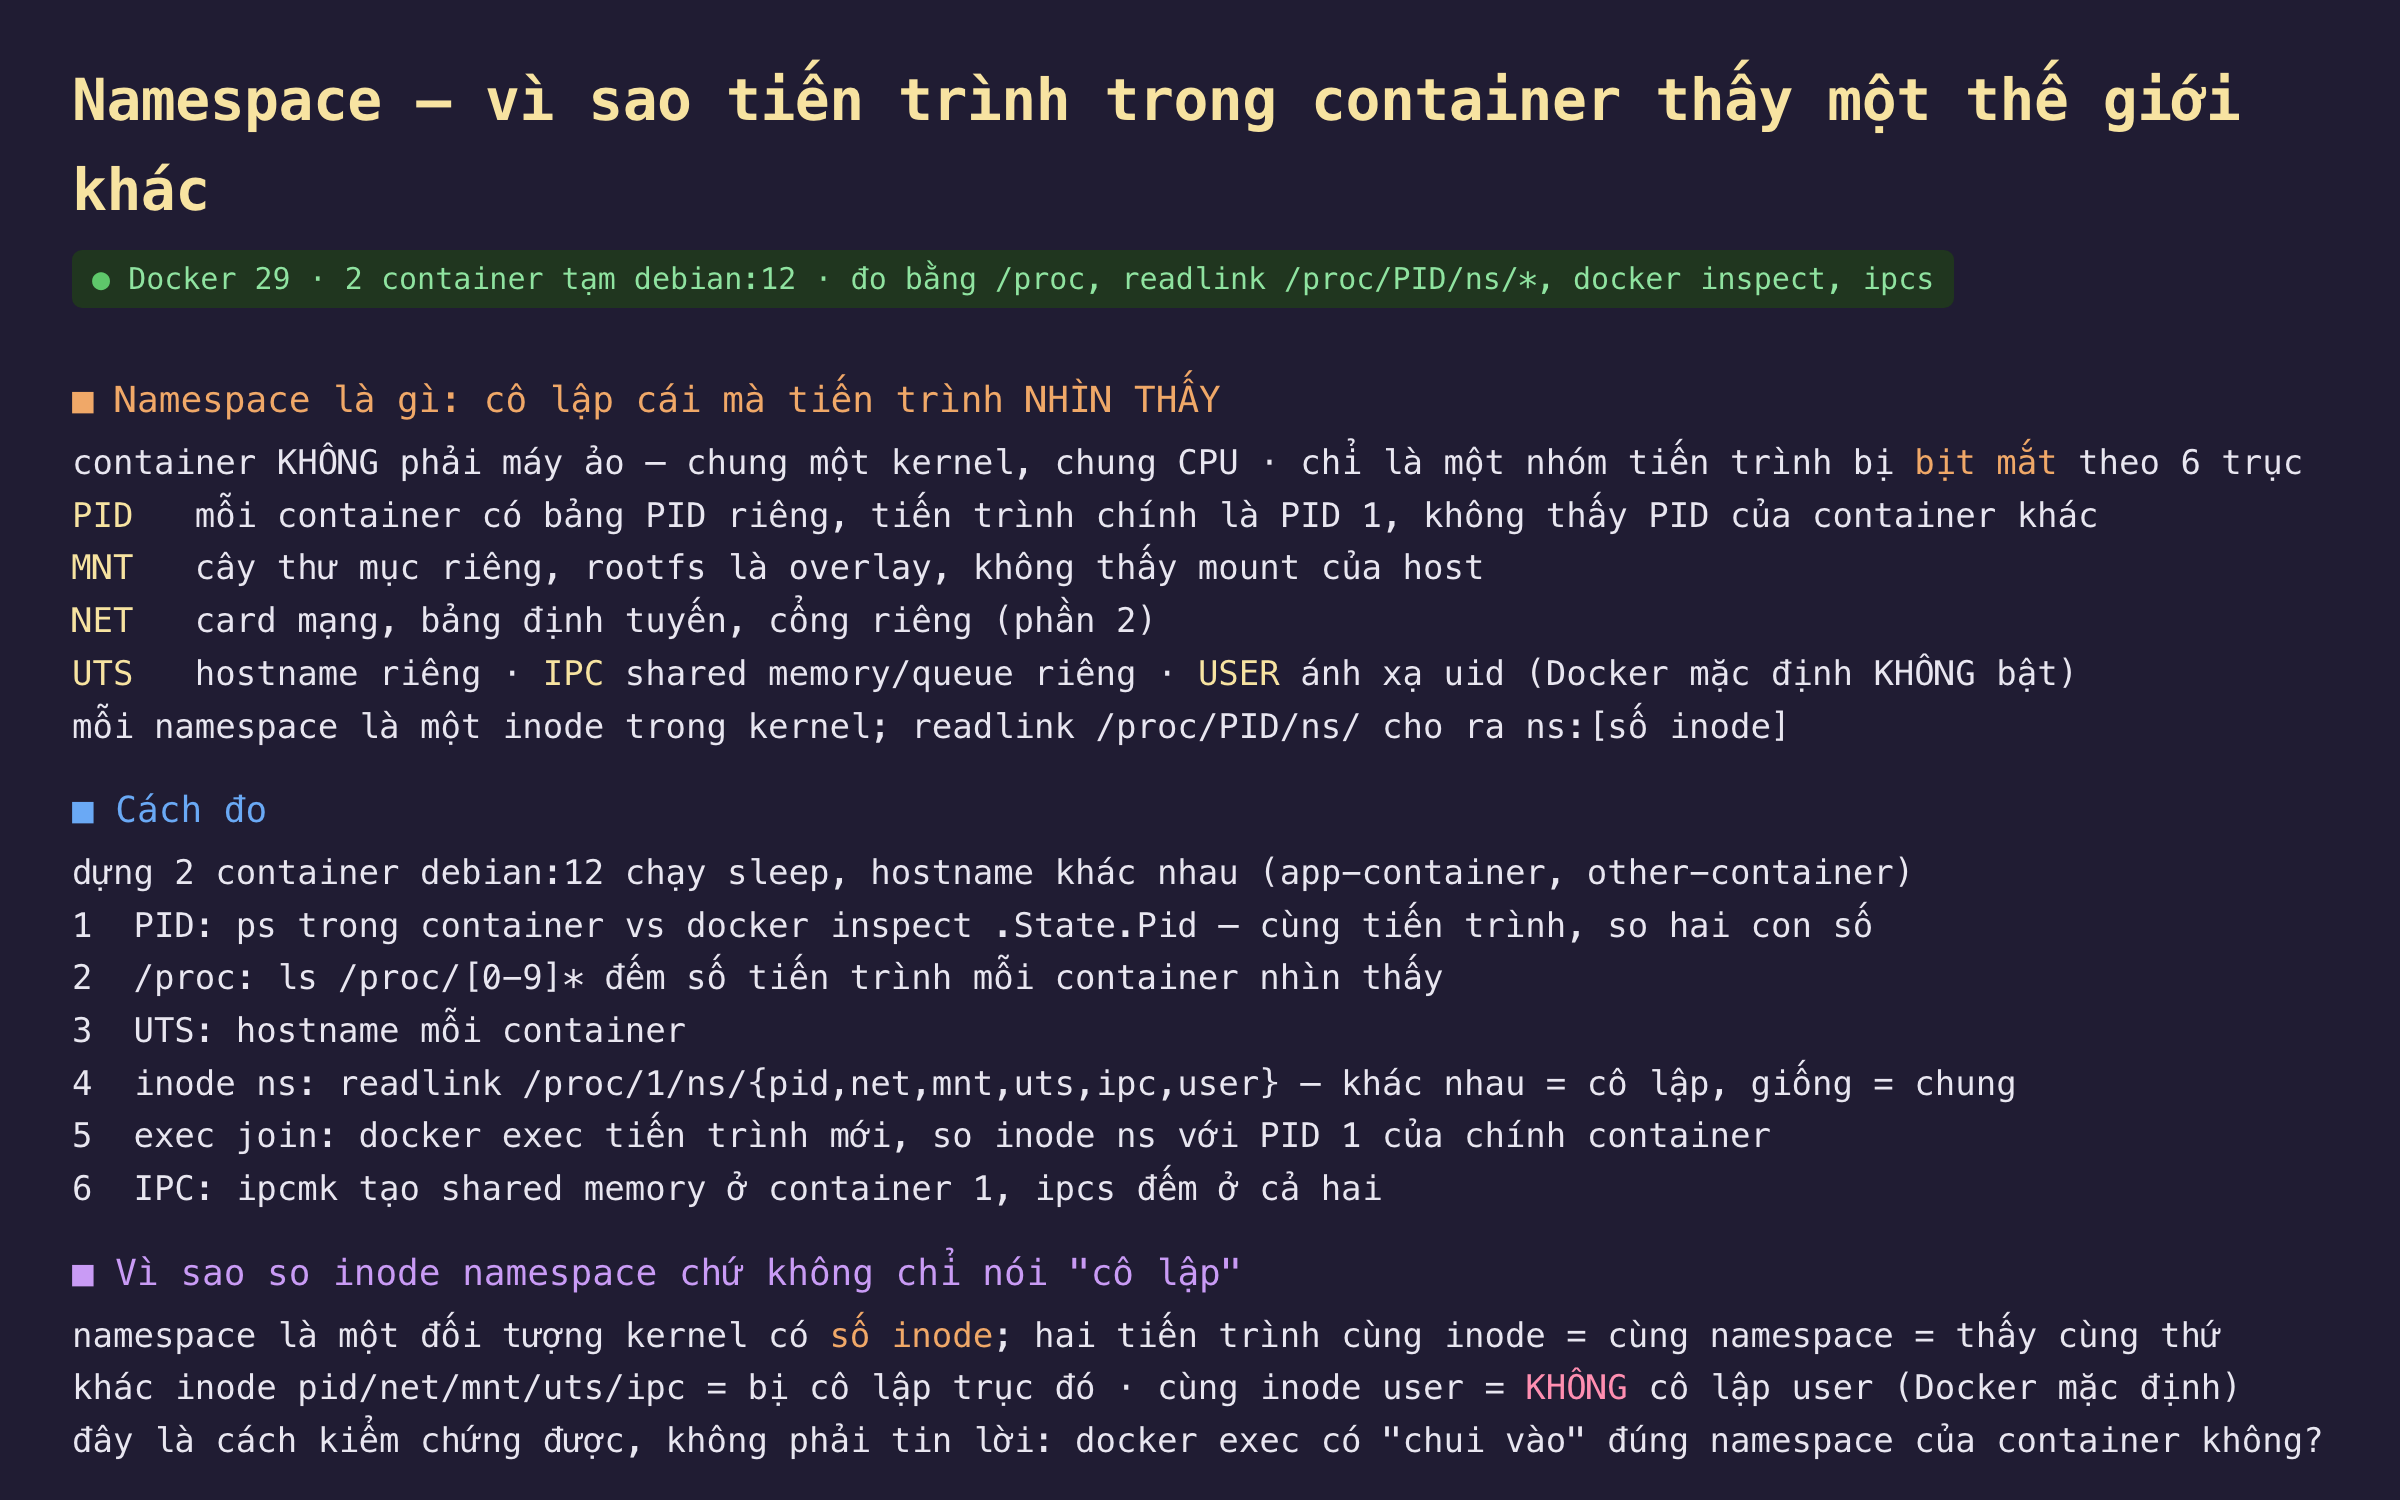
Hình 1: Sáu trục namespace, cách đo bằng hai container, và lý do so inode namespace thay vì chỉ nói "cô lập".
Một container không phải là máy ảo. Máy ảo giả lập cả phần cứng và chạy một kernel riêng; container thì dùng chung đúng kernel của host, chung CPU, chung bộ nhớ vật lý, và chỉ là một nhóm tiến trình bị kernel "bịt mắt" theo một số trục. Cơ chế bịt mắt đó là namespace, và Linux có sáu loại chính. PID cho mỗi container một bảng số tiến trình riêng, nên tiến trình chính của container là PID 1 và nó không thấy tiến trình của container khác. MNT cho cây thư mục riêng, với rootfs là một lớp overlay chứ không phải đĩa. NET cho card mạng, bảng định tuyến và cổng riêng, chủ đề của phần 2. UTS cho hostname riêng. IPC cho shared memory và message queue riêng. USER ánh xạ uid, nhưng Docker mặc định không bật nó, một điểm sẽ trở lại ở cuối bài.
Điều làm namespace kiểm chứng được là mỗi namespace là một đối tượng kernel có số inode. Đọc liên kết /proc/PID/ns/<loại> cho ra một chuỗi dạng ns:[số inode], và quy tắc rất đơn giản: hai tiến trình có cùng số inode cho một loại namespace thì ở cùng namespace đó, tức thấy cùng một thứ; khác inode thì bị cô lập ở trục đó. Vì vậy thay vì nói chung chung "container được cô lập", ta đo được chính xác nó cô lập ở đâu. Cách đo: dựng hai container debian:12 chạy sleep với hostname khác nhau, app-container và other-container. Sau đó so PID của tiến trình nhìn từ trong container với PID nhìn từ host qua docker inspect; đếm số tiến trình mỗi container thấy trong /proc; đọc inode của sáu namespace ở cả hai container; kiểm docker exec có chui vào đúng namespace của container không; và tạo một shared memory ở container này để xem container kia có thấy không.
Đo thật: một tiến trình, hai PID, năm trục cô lập
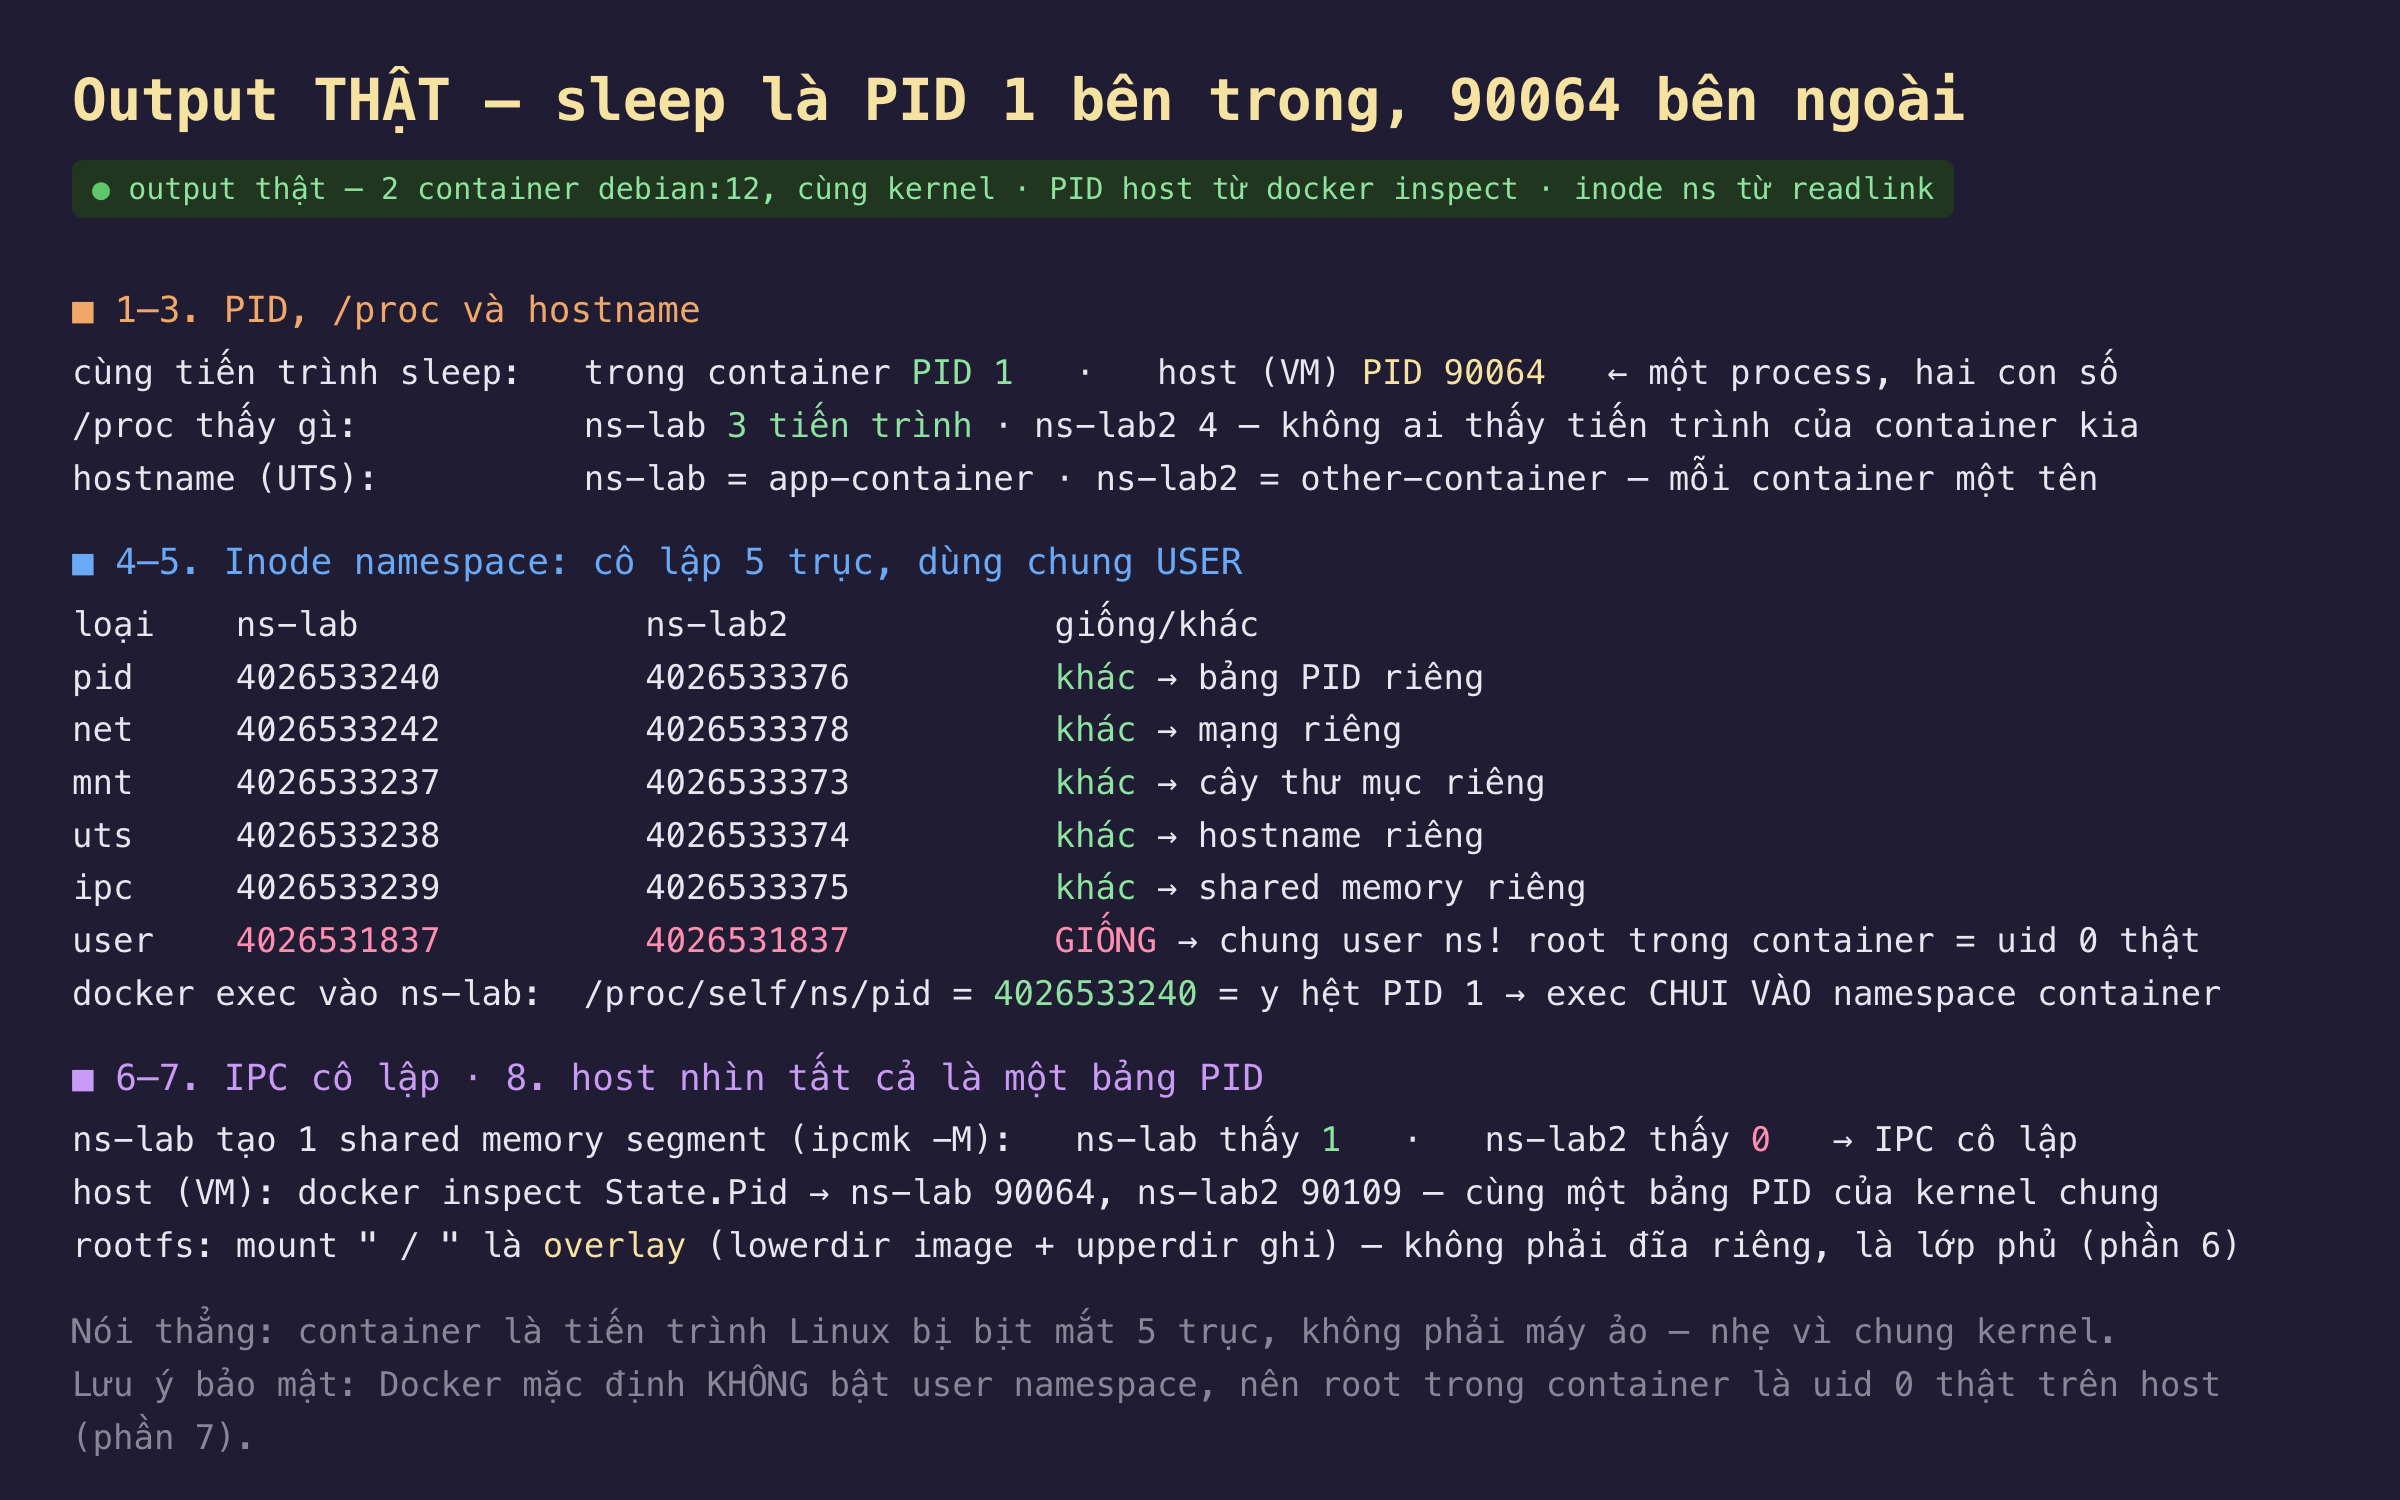
Hình 2: Cùng một tiến trình có hai PID, năm namespace cô lập và một dùng chung, IPC cô lập, và host nhìn mọi container trong một bảng PID.
| phép đo | kết quả |
|---|---|
PID của sleep: trong container / trên host |
1 / 90064, cùng một tiến trình |
số tiến trình /proc mỗi container thấy |
3 và 4, không thấy của nhau |
| hostname (UTS) | app-container / other-container |
| inode pid, net, mnt, uts, ipc giữa hai container | khác nhau cả năm |
| inode user namespace | 4026531837 ở cả hai, dùng chung |
docker exec pid-ns so với PID 1 |
cùng 4026533240, exec chui vào |
| shared memory tạo ở container 1 | container 1 thấy 1, container 2 thấy 0 |
Cùng một tiến trình mang hai số PID, và đó là bản chất của PID namespace. Lệnh sleep chạy trong container là PID 1 khi nhìn từ bên trong, nhưng docker inspect cho biết nó là PID 90064 trong bảng PID của host, tức của máy ảo Linux mà Docker Desktop chạy. Không có hai tiến trình; chỉ có một, với hai cái tên số tuỳ theo ai nhìn. PID 1 bên trong là một con số đặc biệt với hệ quả riêng, chủ đề của phần 10 về zombie và tín hiệu. Và vì mỗi container có bảng PID riêng, /proc trong container chỉ liệt kê tiến trình của chính nó, 3 và 4 tiến trình trong hai container, không container nào thấy tiến trình của container kia; một chương trình giám sát chạy trong container không thể quét tiến trình của container khác hay của host qua /proc, vì /proc nó đọc cũng đã bị namespace lọc.
Năm namespace cô lập, đo bằng năm cặp inode khác nhau. Đọc /proc/1/ns/ ở hai container cho năm cặp số rõ ràng: pid 4026533240 so với 4026533376, net 4026533242 so với 4026533378, mnt, uts, ipc đều khác. Mỗi cặp khác nhau là một bằng chứng cô lập cụ thể: bảng PID riêng, ngăn mạng riêng, cây thư mục riêng, hostname riêng, vùng IPC riêng. Hostname xác nhận trục UTS một cách trực quan: một container tự gọi mình là app-container, container kia là other-container, dù đổi hostname trong một container không ảnh hưởng gì tới container kia hay host. Đây là lý do một container có thể nghĩ nó là web-01 trong khi host tên khác hẳn.
Nhưng user namespace dùng chung, và đó là điều quan trọng nhất về bảo mật. Trong khi năm namespace kia khác nhau, inode user namespace của hai container giống hệt: 4026531837, và đó cũng chính là user namespace của host. Nghĩa là Docker, với cấu hình mặc định, không bật user namespace. Hệ quả trực tiếp: uid 0, tức root, bên trong container là uid 0 thật trên host. Một tiến trình chạy root trong container, nếu thoát được ra ngoài qua một lỗ hổng kernel hay một mount sai, là root trên máy chủ, không phải một user bị giới hạn. Phần 7 về capabilities sẽ đo chính xác root trong container làm được gì và bị chặn gì; ở đây chỉ cần ghi nhận rằng "cô lập" của container không bao gồm cô lập danh tính user theo mặc định, và đây là khác biệt lớn so với trực giác "container như một máy riêng".
docker exec chui vào đúng namespace của container, kiểm chứng được bằng inode. Khi chạy docker exec để mở một shell trong container đang chạy, tiến trình mới đó có /proc/self/ns/pid bằng đúng 4026533240, y hệt inode của PID 1 trong container. Đây không phải điều hiển nhiên: docker exec là một tiến trình mới do daemon tạo, nhưng nó được đặt vào đúng các namespace của container đích, nên nó thấy đúng cây tiến trình, đúng mạng, đúng filesystem mà ứng dụng trong container thấy. Đó là lý do một lệnh gỡ lỗi chạy qua docker exec quan sát được đúng môi trường của ứng dụng, chứ không phải môi trường của host.
IPC cô lập, và host nhìn tất cả trong một bảng PID chung. Tạo một shared memory segment bằng ipcmk trong container thứ nhất: ipcs trong chính nó thấy một segment, còn container thứ hai thấy 0; vùng IPC của chúng tách biệt, nên hai ứng dụng dùng shared memory hay POSIX message queue trong hai container không đụng nhau. Ở chiều ngược lại, từ phía host, docker inspect cho thấy hai container là PID 90064 và 90109 trong cùng một bảng PID của kernel chung; host thấy mọi tiến trình của mọi container, vì chúng chỉ là tiến trình thường trên kernel đó. Và rootfs của container là một mount kiểu overlay, lớp image chỉ đọc chồng với lớp ghi riêng, không phải một đĩa độc lập, chi tiết mà phần 6 sẽ đo về dung lượng và chi phí ghi.
Đánh đổi cần cân nhắc
Nhẹ vì chung kernel, nhưng cô lập không bằng máy ảo. Lợi thế của container so với máy ảo đến thẳng từ việc không có kernel riêng: khởi động mili giây thay vì giây, chi phí bộ nhớ gần như chỉ là tiến trình, mật độ cao. Giá phải trả là ranh giới cô lập mỏng hơn: một lỗ hổng kernel ảnh hưởng mọi container trên host, và như đo được, danh tính user không cô lập mặc định. Với tải cần cô lập mạnh, ví dụ chạy mã không tin cậy của nhiều khách hàng, container thường được đặt thêm trong một lớp máy ảo nhẹ như Firecracker hay gVisor; cho dịch vụ nội bộ của cùng một tổ chức thì namespace là đủ.
Bật user namespace nếu chạy mã không tin cậy, nhưng cân nhắc chi phí vận hành. Docker hỗ trợ user namespace qua userns-remap, ánh xạ root trong container sang một uid không đặc quyền trên host, đóng phần lớn khoảng trống mà bài này đo. Lý do nó không bật mặc định là nó làm phức tạp việc chia sẻ volume và một số image giả định root thật; vì vậy đây là một quyết định cân nhắc, không phải bật vô điều kiện. Biết rằng mặc định là không bật đã là bước đầu để không ngạc nhiên.
Phạm vi đo. Các số PID và inode ở đây là của một máy ảo Linux trong Docker Desktop trên máy Mac; trên host Linux trực tiếp, "host" là chính máy thật và các con số sẽ khác, nhưng mọi quan hệ, một tiến trình hai PID, năm trục cô lập, user ns chung, giữ nguyên. Chưa đo network namespace chi tiết, phần 2; chưa đo cgroups, cơ chế khác hẳn namespace vì cgroups giới hạn tài nguyên tiến trình được dùng chứ không phải thứ nó thấy, chủ đề của phần 3 đến 5.
Ba ý mang về
- Container là tiến trình Linux bị bịt mắt theo trục, không phải máy ảo. Cùng một
sleeplà PID 1 bên trong và 90064 trên host; nhẹ vì chung kernel, nhưng cũng vì thế ranh giới cô lập mỏng hơn máy ảo. - Cô lập đo được bằng inode namespace. Năm trục pid, net, mnt, uts, ipc có inode khác nhau giữa hai container là bằng chứng cô lập;
docker execchia sẻ inode với PID 1 là bằng chứng nó chui vào đúng namespace container. - User namespace dùng chung theo mặc định. Root trong container là uid 0 thật trên host, nên "container như một máy riêng" là trực giác sai về bảo mật; bật
userns-remapnếu chạy mã không tin cậy.
Nguồn
- Linux
namespaces(7)— bảy loại namespace và ngữ nghĩa cô lập: https://man7.org/linux/man-pages/man7/namespaces.7.html - Linux
pid_namespaces(7)— PID namespace và PID 1: https://man7.org/linux/man-pages/man7/pid_namespaces.7.html - Linux
user_namespaces(7)— ánh xạ uid và vì sao quan trọng cho bảo mật: https://man7.org/linux/man-pages/man7/user_namespaces.7.html - Docker — Isolate containers with a user namespace (
userns-remap): https://docs.docker.com/engine/security/userns-remap/ - Linux
proc(5)—/proc/PID/ns/, inode namespace: https://man7.org/linux/man-pages/man5/proc.5.html - Michael Kerrisk — Namespaces in operation (LWN, loạt bài nền tảng): https://lwn.net/Articles/531114/
Phần sau đi sâu vào trục NET: network namespace cho container một ngăn mạng riêng với card ảo, bảng định tuyến và cổng tách biệt. Đo gói đi qua cặp veth và bridge docker0, so địa chỉ IP nhìn từ trong và ngoài, và dựng một network namespace bằng tay để thấy Docker thật ra làm gì.
