Rust hứa một điều nghe như quảng cáo: trừu tượng chi phí bằng không (zero-cost abstraction) — bạn viết bằng iterator, closure, generic cho gọn và an toàn, mà mã máy sinh ra nhanh ngang với vòng lặp cấp thấp viết tay. "Nhanh ngang" là một khẳng định đo được, nên bài này đo nó ba cách trong container rust:1 (rustc 1.99.1): bấm giờ, đếm lệnh assembly, và tìm lệnh gọi hàm. Và ta cũng đo đúng cái bẫy của câu khẩu hiệu đó: "bằng không" chỉ đúng sau khi tối ưu.
Cùng một bài toán, hai cách viết
Bài toán: tính tổng bình phương các số chẵn trong một lát cắt 50 triệu phần tử. Viết kiểu Rust hiện đại bằng chuỗi iterator, và viết kiểu cổ điển bằng vòng for:
fn bang_iterator(v: &[u64]) -> u64 {
    v.iter().filter(|&&x| x % 2 == 0).map(|&x| x * x).sum()
}
fn bang_vong_tay(v: &[u64]) -> u64 {
    let mut s = 0u64;
    for &x in v {
        if x % 2 == 0 { s += x * x; }
    }
    s
}
Bản iterator đọc như một câu: "lấy từng phần tử, lọc số chẵn, bình phương, cộng dồn". Nó không có chỉ số, không có biến tích luỹ lộ ra, khó viết sai. Câu hỏi là: cái gọn gàng đó có phải trả giá bằng tốc độ không?
Bản release: ngang nhau
Biên dịch với -O (tối ưu, như cargo build --release), chạy mỗi hàm 5 lần lấy trung bình:
n = 50.000.000 phần tử
iterator (filter.map.sum) : 9,94 ms   kết quả=8308350000000
vòng for viết tay          : 10,44 ms   kết quả=8308350000000
chênh lệch: 4,7%
Hai con số nằm trong khoảng nhiễu đo của nhau — bản iterator thậm chí nhỉnh hơn một chút, nhưng chênh lệch 4,7% là không đáng kể và đảo chiều giữa các lần chạy. Cùng kết quả, cùng tốc độ. Lời hứa "chi phí bằng không" đứng vững ở mức thời gian. Nhưng thời gian dễ nhiễu; để chắc chắn, ta nhìn thẳng vào mã máy.
Assembly: closure biến mất hoàn toàn
Xuất assembly của cả hai hàm ở bản release (kiến trúc aarch64) rồi đếm. Nếu iterator thật sự miễn phí, mã máy của nó phải không còn dấu vết nào của các lớp filter, map, sum:
                        bang_iterator   bang_vong_tay
số dòng lệnh                 52              56
lệnh gọi hàm (bl/blr)         0               0
lệnh nhân (mul)               5               5
Đây là bằng chứng cứng hơn cả thời gian. Không lệnh gọi hàm nào trong bang_iterator: ba closure truyền vào filter và map, cùng toàn bộ máy móc iterator, đã bị nội tuyến (inline) sạch sẽ — không còn tồn tại dưới dạng hàm để mà gọi. Và cùng 5 lệnh mul ở cả hai hàm cho thấy trình tối ưu đã mở cuộn (unroll) vòng lặp y hệt nhau — xử lý nhiều phần tử mỗi vòng để tận dụng pipeline của CPU. Chênh lệch 52 với 56 dòng chỉ là khác biệt vụn vặt trong cách sắp lệnh; cốt lõi hai hàm là cùng một vòng lặp. Chuỗi iter().filter().map().sum() không phải một lớp bọc mỏng quanh vòng lặp — sau tối ưu, nó chính là vòng lặp đó.
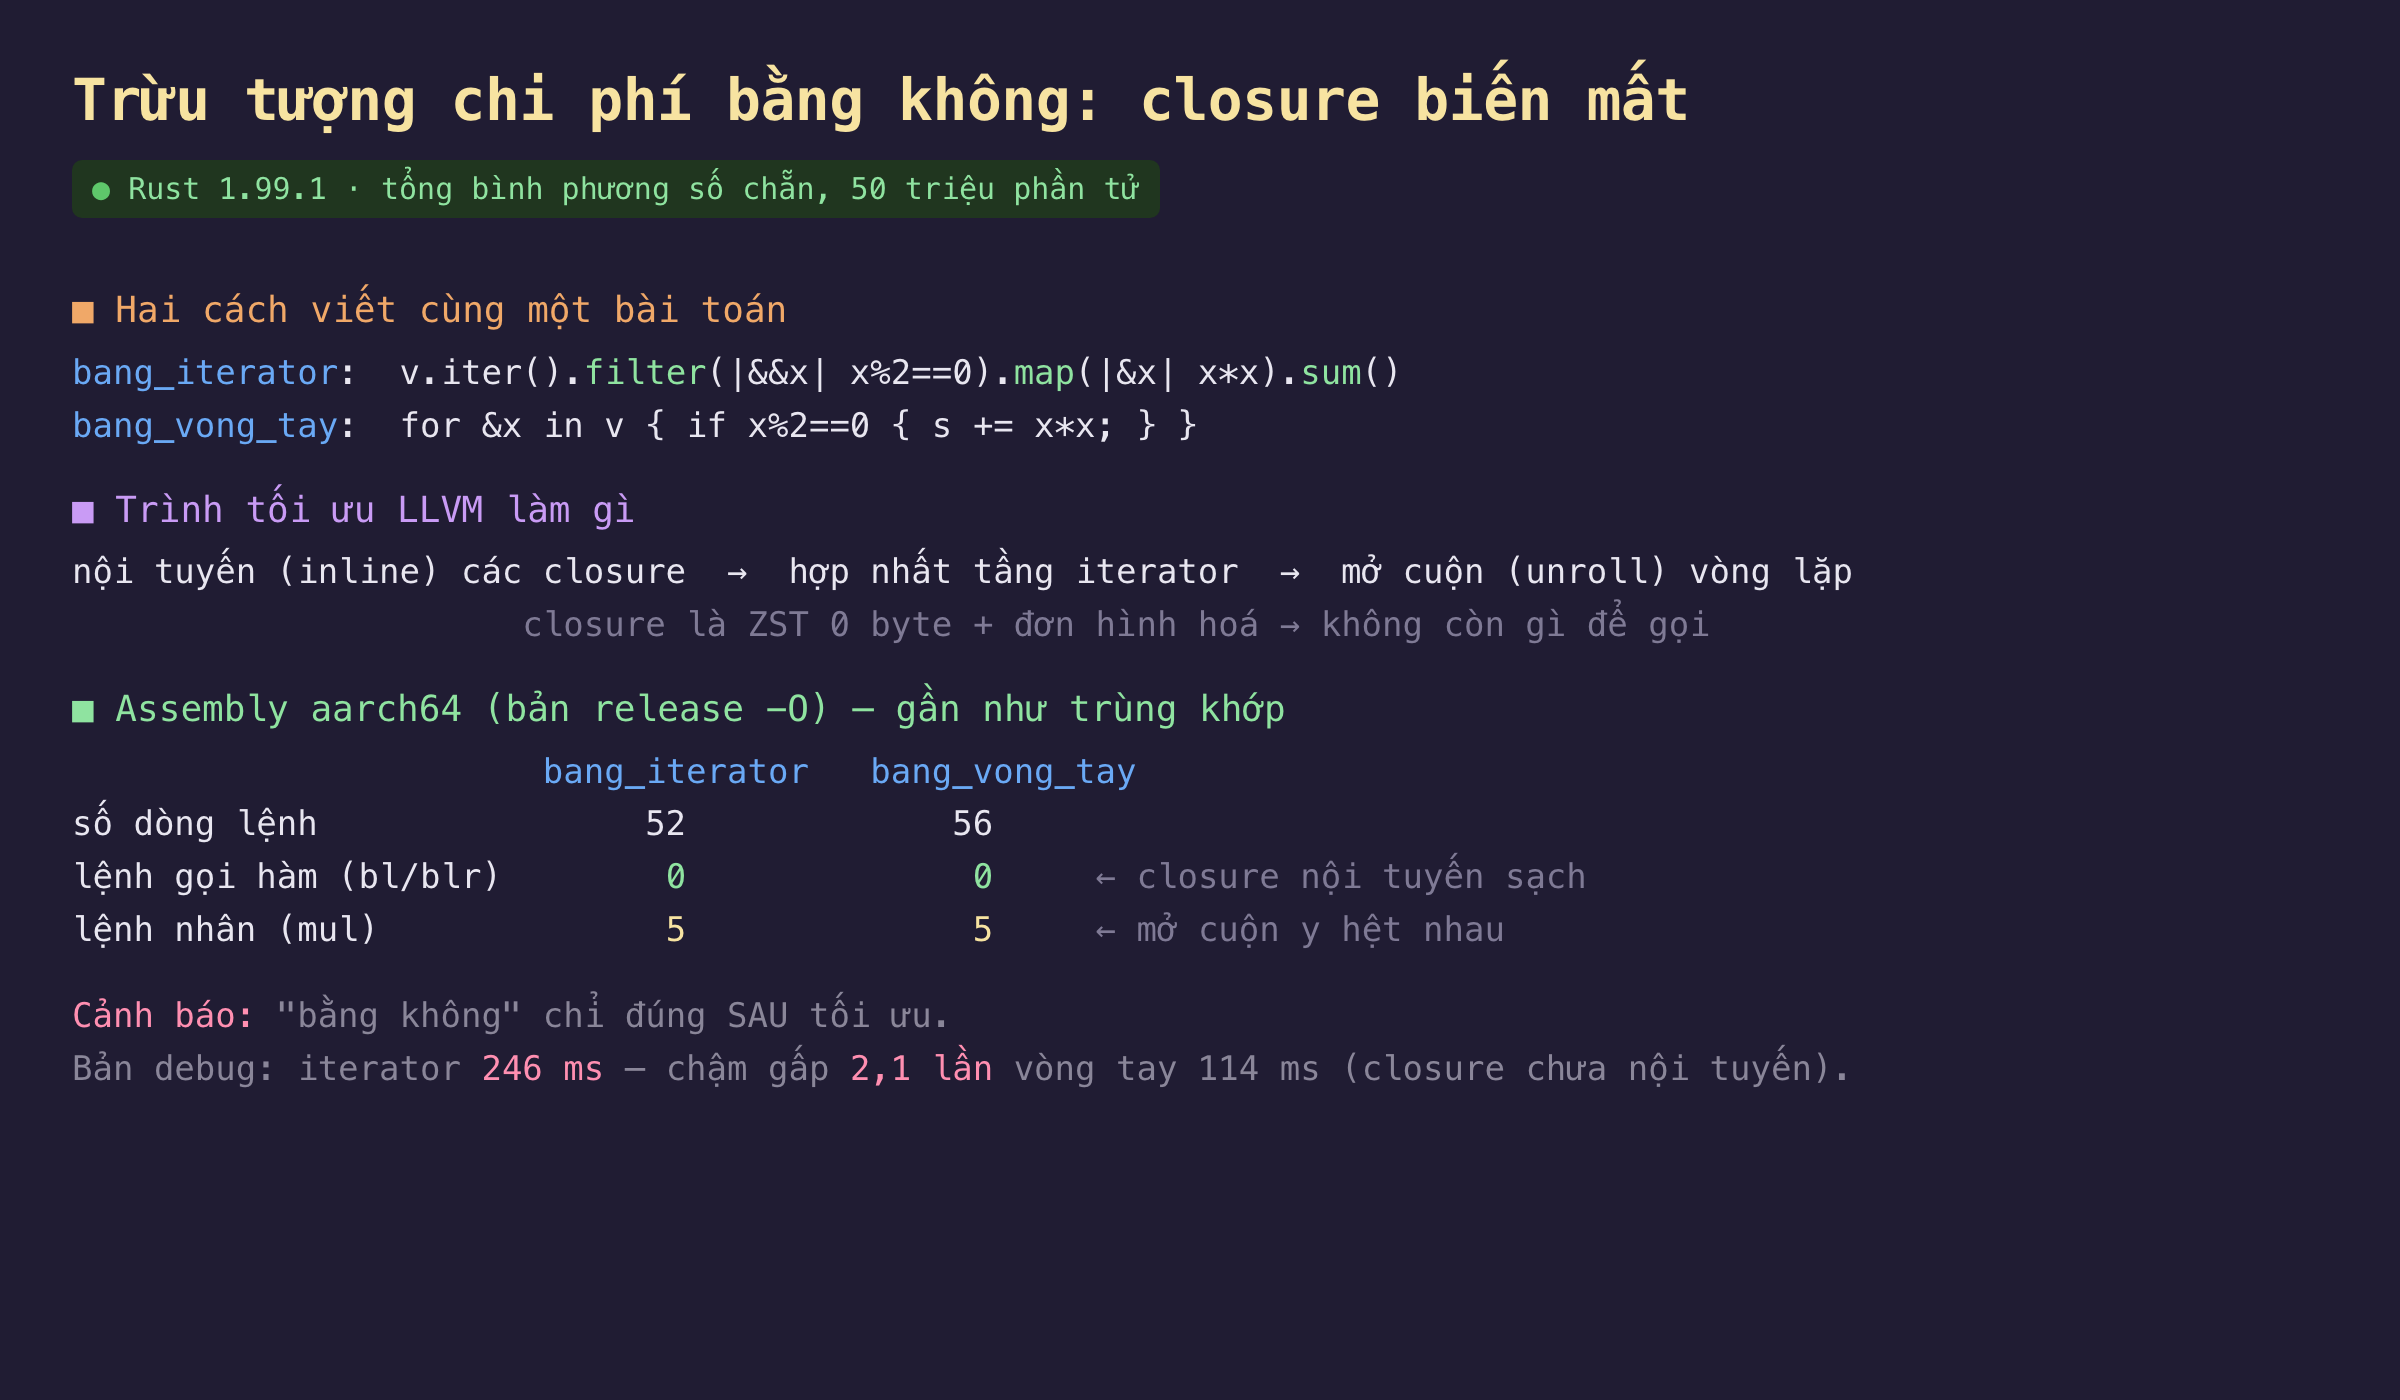
Hình 1: Sau tối ưu, trình biên dịch nội tuyến các closure và hợp nhất các tầng iterator thành đúng một vòng lặp — assembly hai hàm gần như trùng khớp, cùng 0 lệnh gọi và 5 lệnh nhân.
Cái bẫy: "bằng không" chỉ đúng sau tối ưu
Đây là vế mà các bài giới thiệu hay bỏ qua. Biên dịch không -O (bản debug, mặc định của cargo build), cùng mã đó cho kết quả rất khác:
                          debug (không -O)   release (-O)
iterator (filter.map.sum)   246,14 ms          9,94 ms
vòng for viết tay            114,30 ms         10,44 ms
chênh lệch                   53,6%              4,7%
Ở bản debug, iterator chậm gấp 2,1 lần vòng tay. Lý do đúng là điều mà bản release xoá đi: khi không tối ưu, mỗi tầng filter, map, sum vẫn là lời gọi hàm thật, mỗi closure vẫn được gọi riêng cho từng phần tử — hàng trăm triệu lời gọi không được nội tuyến. "Chi phí bằng không" không phải phép màu của cú pháp; nó là kết quả của trình tối ưu. Bản thân iterator có chi phí; trình tối ưu mới là thứ bào nó về không. Hệ quả thực tế rất rõ: đừng bao giờ đánh giá hiệu năng Rust ở bản debug — con số debug không liên quan gì tới cái bạn triển khai. Và cũng vì vậy, iterator tăng gấp 24,7 lần tốc độ khi bật -O (246 ms xuống 9,94 ms), trong khi vòng tay chỉ tăng 11 lần: phần lớn công tối ưu là để trả lại cái giá của trừu tượng.
Vì sao làm được: nội tuyến và đơn hình
Cơ chế đằng sau không huyền bí, và nó nối thẳng với bài về bố cục bộ nhớ. Closure trong Rust là một struct nhỏ (thường là ZST, 0 byte, như bài trước đo) mang mã, không phải một con trỏ hàm cấp phát trên heap. Iterator là generic được đơn hình hoá (monomorphization): trình biên dịch sinh một bản mã cụ thể cho đúng kiểu u64 và các closure cụ thể, thay vì một bản chung đi qua con trỏ. Khi đã có mã cụ thể, closure nhỏ và không trạng thái, trình tối ưu LLVM nội tuyến chúng vào vòng lặp, thấy các tầng filter/map/sum chỉ là điều kiện và phép nhân lồng nhau, rồi hợp nhất và mở cuộn. Không có dyn, không có con trỏ hàm, không có lớp gián tiếp nào sót lại để trả giá lúc chạy. (Điều ngược lại — điều phối động qua dyn Trait, có chi phí — là chủ đề bài về trait.)
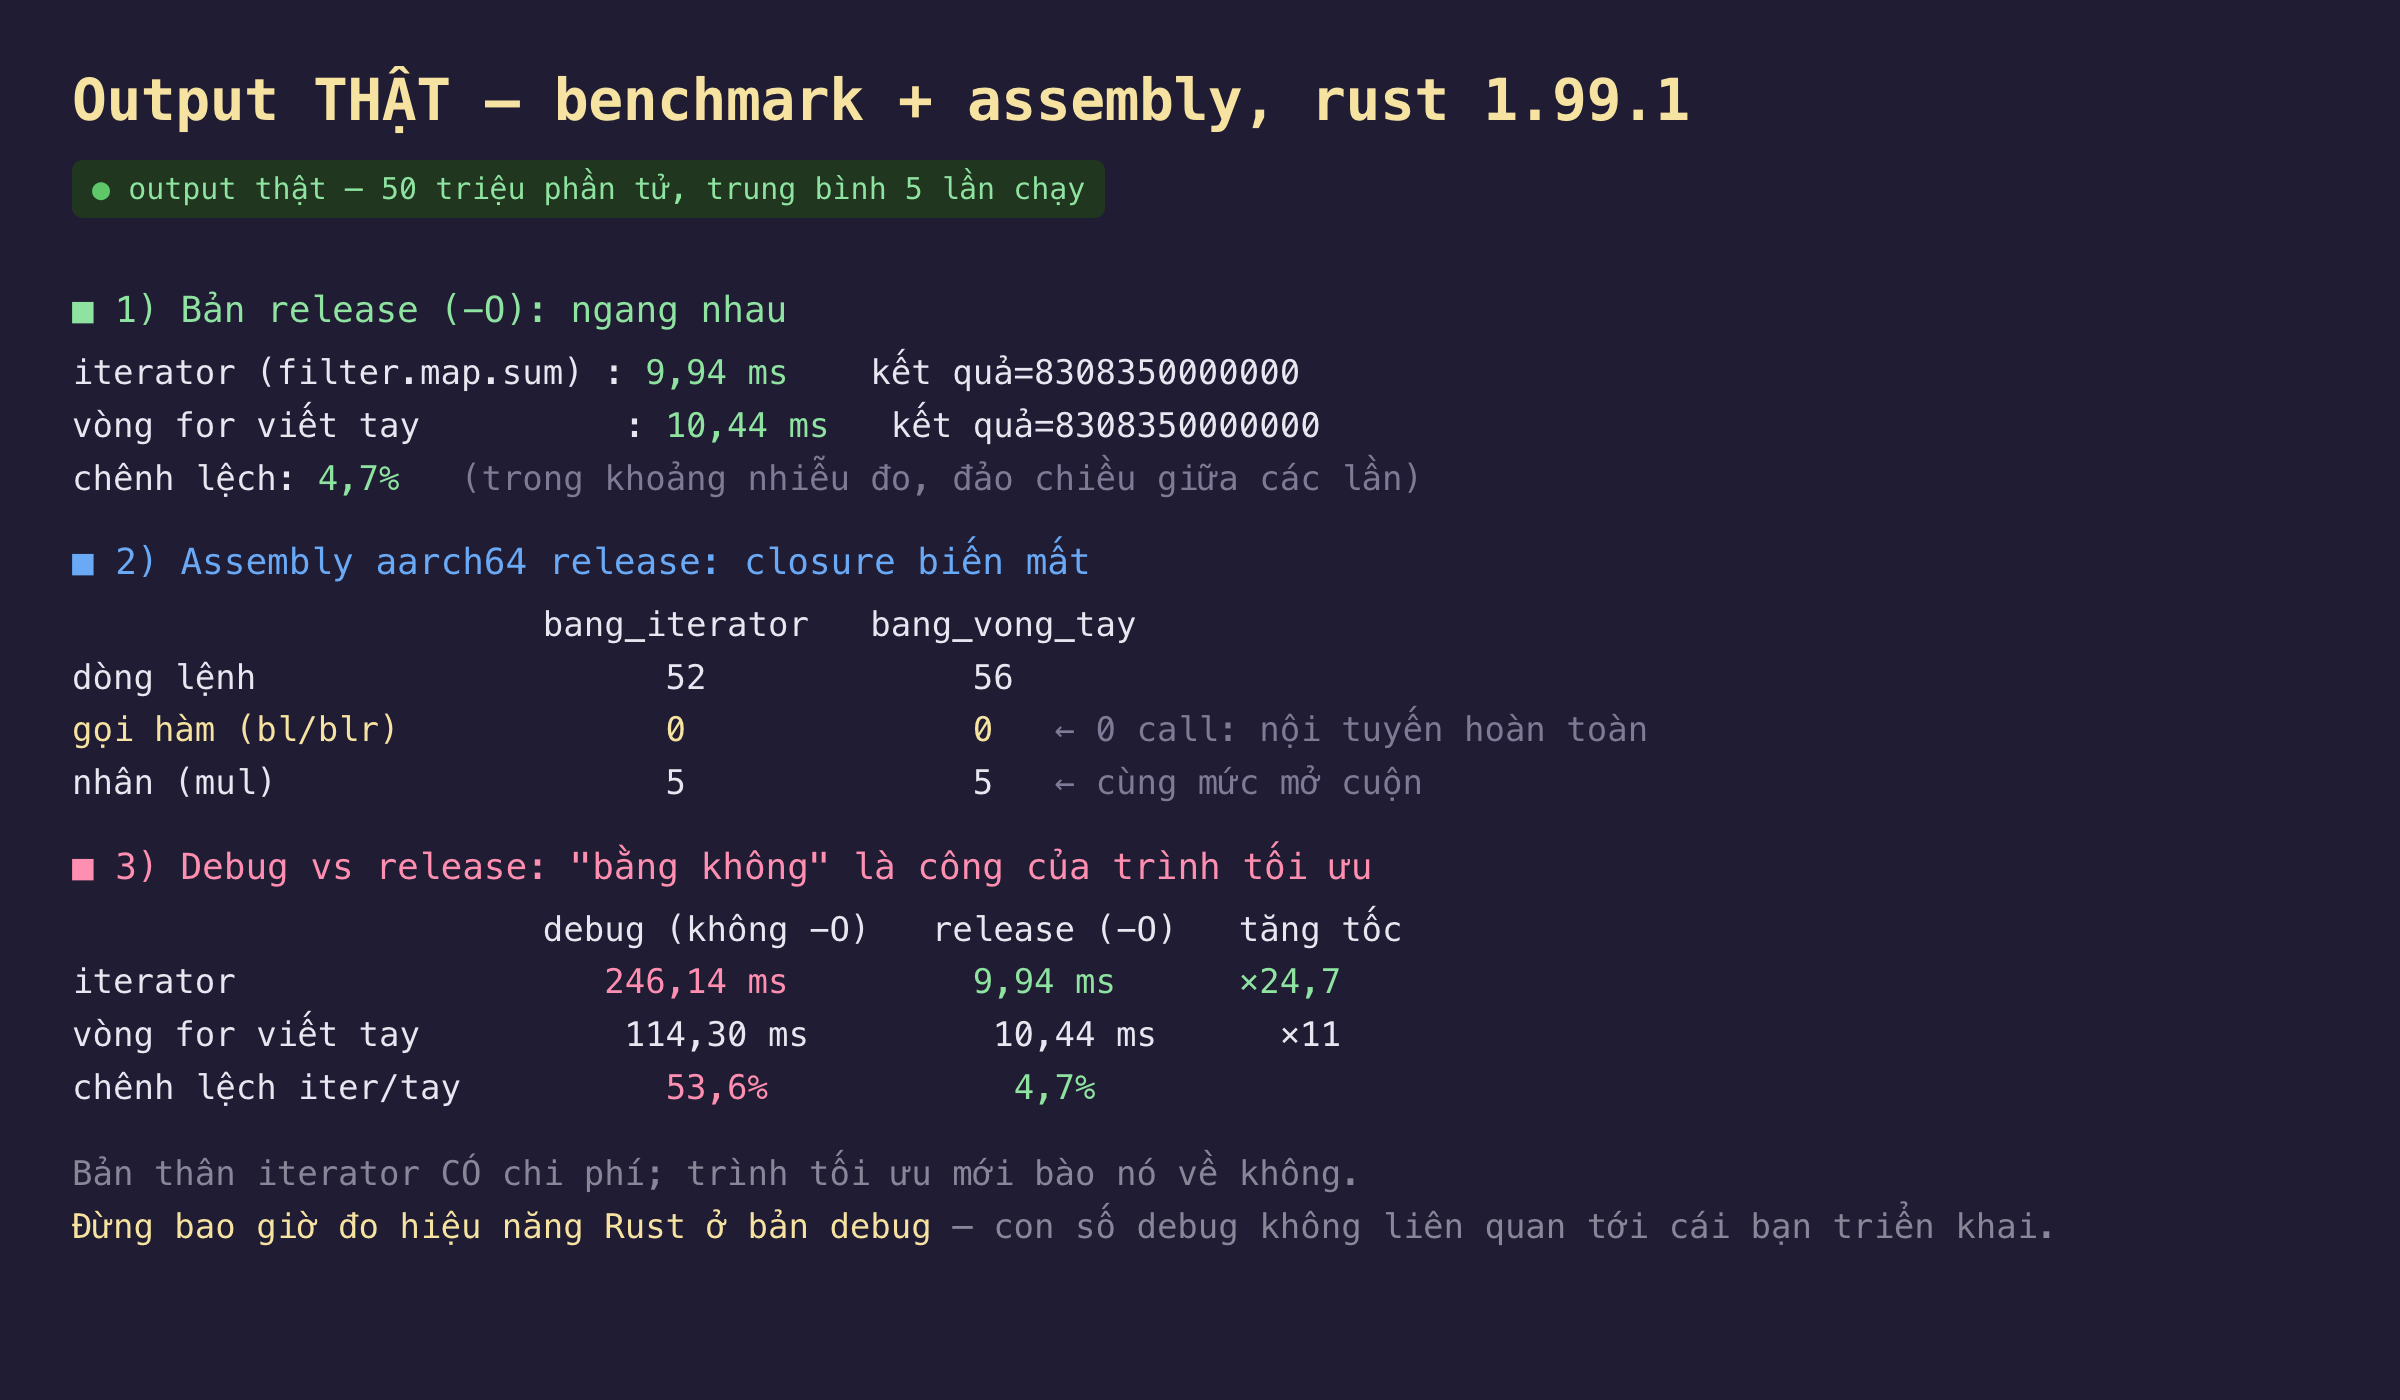
Hình 2: Ba bảng đo thật — release ngang nhau, assembly trùng khớp (0 gọi hàm), và debug vs release cho thấy "bằng không" là công của trình tối ưu.
Gói lại
"Trừu tượng chi phí bằng không" không phải khẩu hiệu tiếp thị mà là một khẳng định đo được, và nó đứng vững: ở bản release, iter().filter().map().sum() chạy ngang vòng for viết tay (9,94 so với 10,44 ms) và biên dịch ra assembly gần như trùng khớp — 0 lệnh gọi hàm, cùng cách mở cuộn. Bạn được viết mã gọn, an toàn, dễ đọc mà không trả giá tốc độ. Điều kiện duy nhất, và cũng là cảnh báo quan trọng nhất của bài: chỉ sau khi tối ưu — bản debug của iterator chậm gấp đôi, nên mọi phép đo hiệu năng phải chạy ở --release. Bài sau bước sang chi phí không bằng không: các con trỏ thông minh Box, Rc, Arc, và cái giá thật của việc đếm tham chiếu.
