Mở Twitter/X, dòng thời gian hiện ra tức thì — dù bạn theo dõi hàng nghìn tài khoản đăng liên tục. Câu hỏi kiến trúc: timeline đó dựng lúc nào? Có hai cực, mỗi cực một điểm chết, và Twitter phải lai chúng vì một nhân vật đặc biệt: người nổi tiếng. Bài này dựng thật feed trên Redis (đúng công cụ Twitter dùng cho timeline cache), đo trực tiếp chi phí, và định lượng bài toán người nổi tiếng bằng số thật.
Hai cực: fanout khi ghi (push) vs fanout khi đọc (pull)
Push (fanout-on-write): khi ai đó đăng tweet, ta đẩy ngay ID tweet vào timeline dựng-sẵn của mọi follower. Trên Redis, timeline mỗi người là một list, đẩy bằng LPUSH:
# người nổi tiếng 50.000 follower -> 50.000 lệnh LPUSH cho MỘT tweet
for f in followers(author):
    redis-cli LPUSH "timeline:$f" "tweet:celeb:1"
# Đọc feed sau đó là O(1): timeline đã dựng sẵn
redis-cli LRANGE "timeline:u7" 0 20      # lấy 21 tweet mới nhất
Đọc O(1) — tuyệt vời, cho tới khi một người nổi tiếng đăng. Pull (fanout-on-read): ghi rẻ (chỉ LPUSH vào author timeline của chính tác giả), nhưng đọc feed phải gộp từ mọi người bạn theo dõi:
redis-cli LPUSH "author:celeb" "tweet:celeb:1"   # chỉ ghi 1 nơi
for a in following(user):
    redis-cli LRANGE "author:$a" 0 20            # đọc ĐẮT: gộp mọi followee
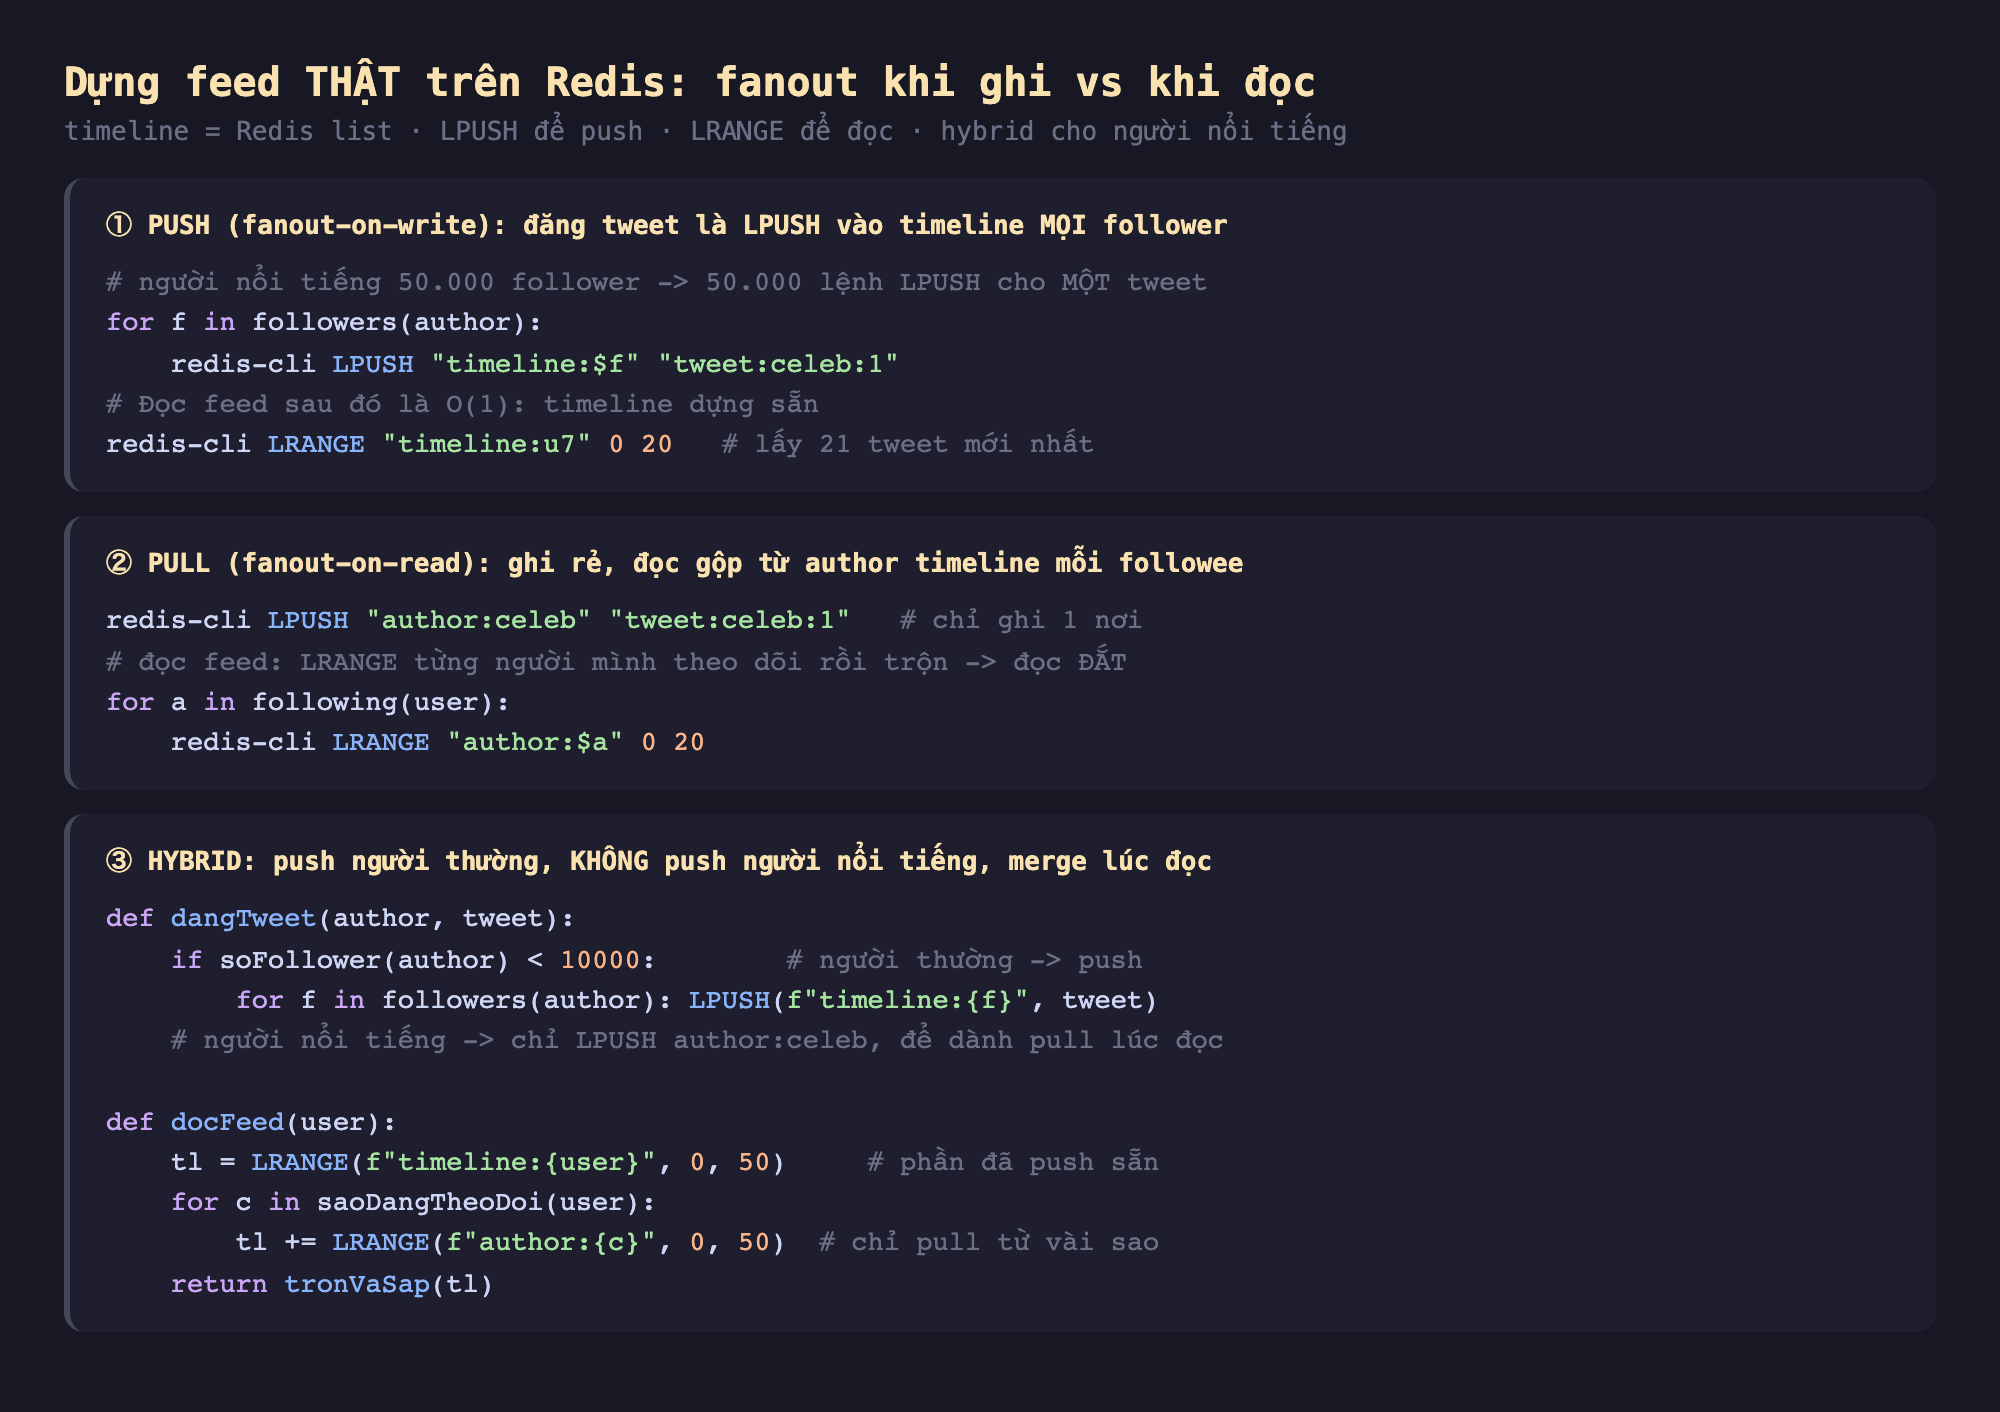
Hình 1: Dựng feed thật trên Redis — push bằng LPUSH vào timeline mỗi follower (đọc LRANGE O(1) nhưng bão ghi ở người nổi tiếng); pull bằng LRANGE author timeline lúc đọc (ghi rẻ, đọc đắt); hybrid quyết theo ngưỡng follower.
Đo THẬT: bài toán người nổi tiếng bằng con số
Ta dựng thật trên container Redis 7.4.11 và đo trực tiếp.
A — Chi phí fanout khi ghi:
1 tweet của NGƯỜI NỔI TIẾNG 50.000 follower = 50.000 lệnh LPUSH -> 76 ms
Người thường 200 follower = 200 LPUSH -> 36 ms
Một tweet của người 50.000 follower thực sự tạo 50.000 lần ghi. Nhưng con số đáng sợ hiện ra khi ngoại suy từ throughput đo được:
B — Định lượng bài toán người nổi tiếng:
redis-benchmark LPUSH: 362.976 lệnh/giây (p50 0,079 ms)
=> 1 tweet của siêu sao 50 TRIỆU follower = 50.000.000 LPUSH
   = ~138 giây fanout thuần cho MỘT tweet, trên một Redis
Đây chính là bài toán người nổi tiếng bằng số thật: một tweet duy nhất của tài khoản 50 triệu follower cần ~138 giây chỉ để đẩy vào timeline mọi người — trên một Redis. Push tier không thể theo kịp; tweet trễ tính bằng phút, worker dồn ứ, và có thể sập dây chuyền.
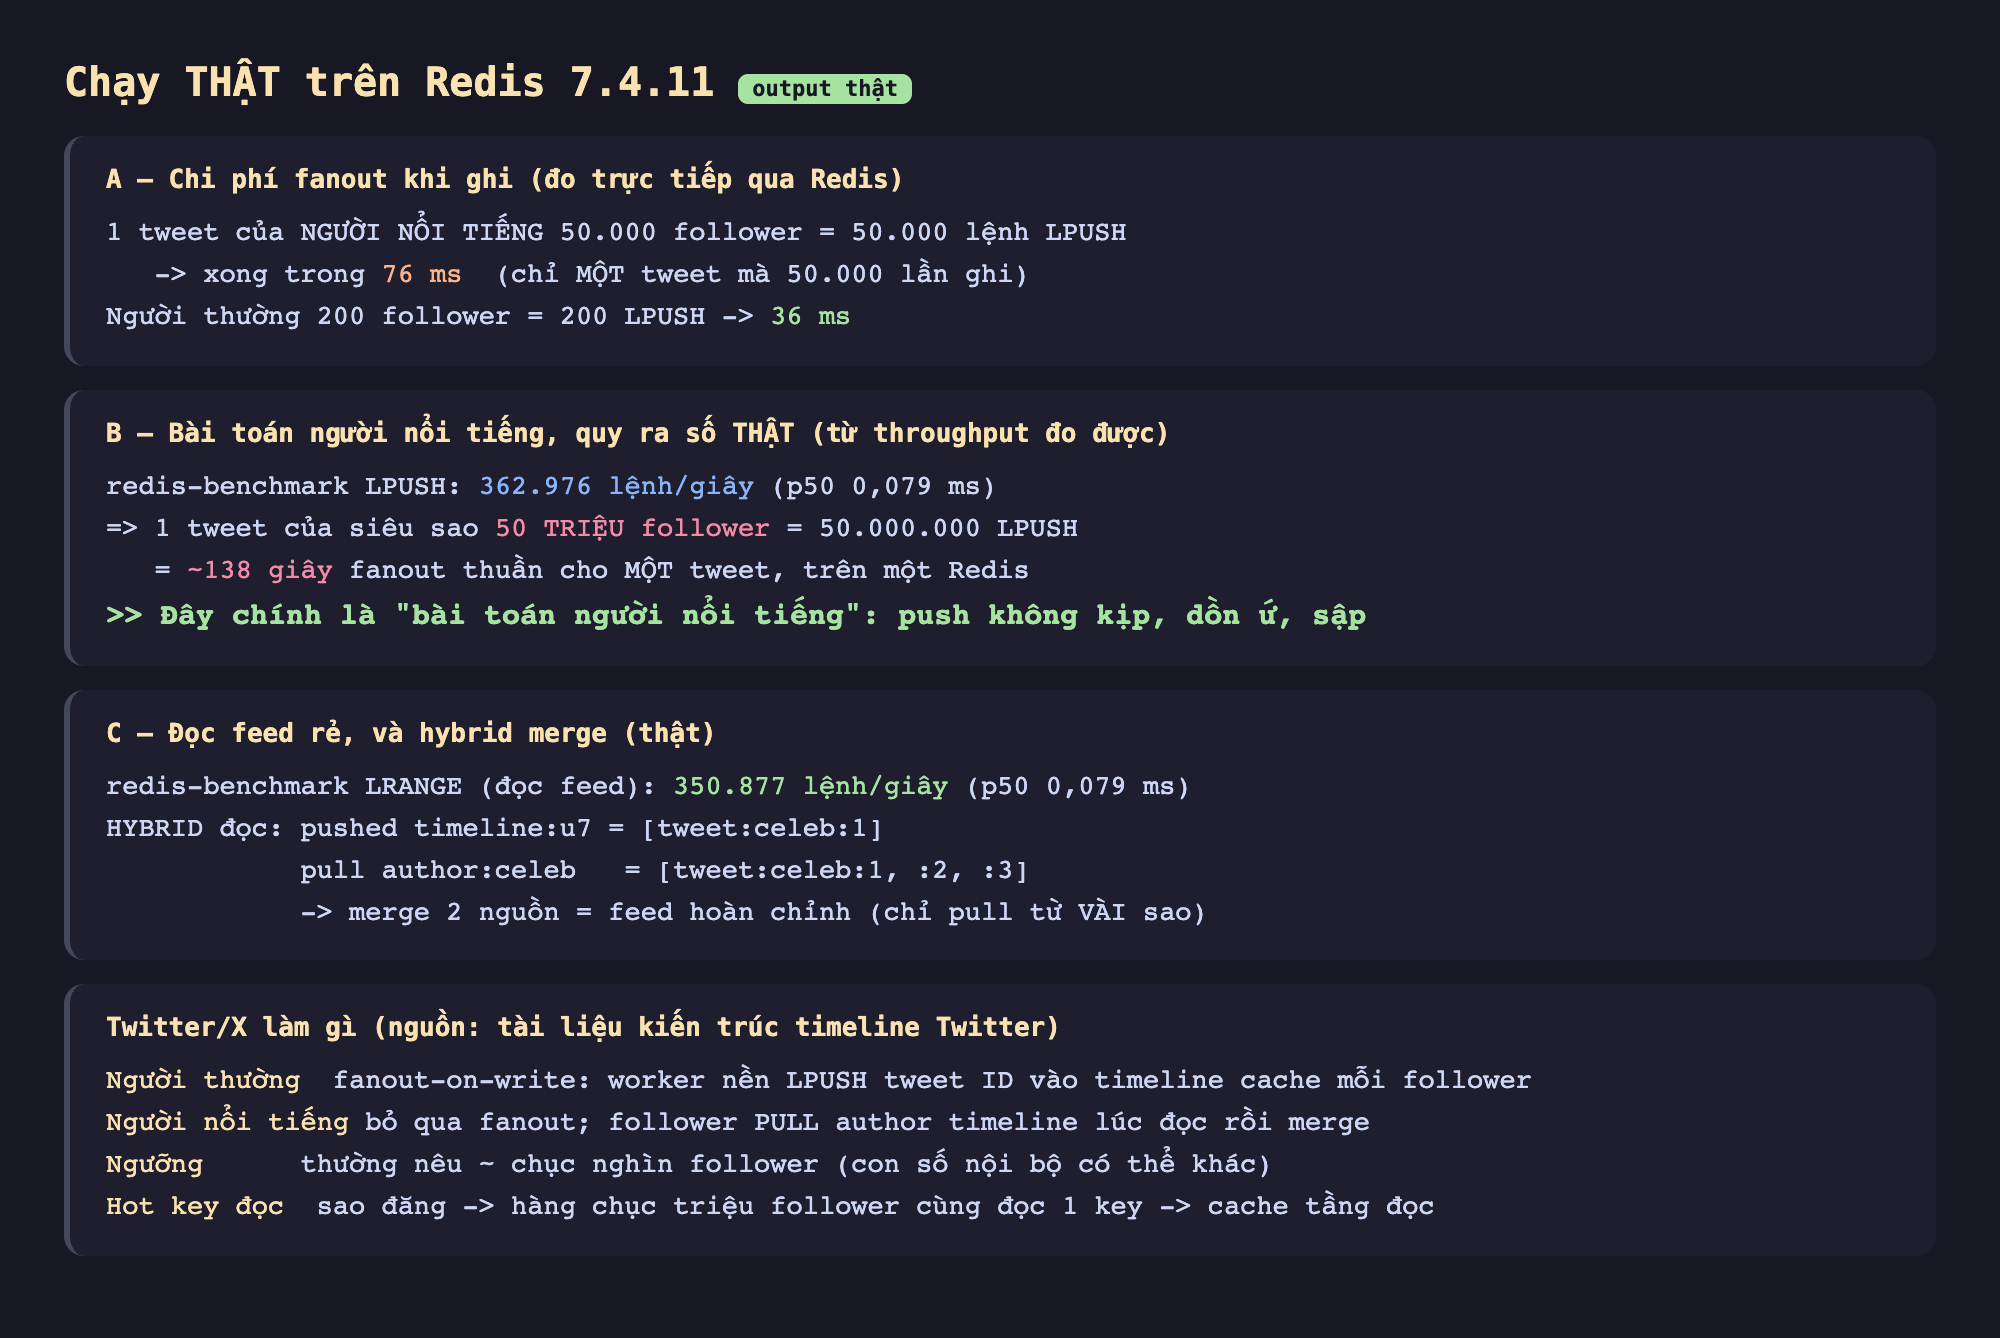
Hình 2: Chạy thật trên Redis — 1 tweet người nổi tiếng = 50.000 LPUSH (76ms); ngoại suy từ 362.976 LPUSH/giây thì tweet 50 triệu follower = ~138 giây fanout; đọc feed LRANGE 350.877/giây; và hybrid merge timeline đã push + pull author của sao.
Cách giải: hybrid push-người-thường / pull-người-nổi-tiếng
Twitter dùng hybrid: push cho người thường, pull cho người nổi tiếng, rồi merge lúc đọc. Khi đăng, nếu tác giả dưới ngưỡng follower (tài liệu thường nêu ~chục nghìn) thì LPUSH fanout như thường; nếu là người nổi tiếng thì không push. Khi đọc, lấy phần đã push sẵn cộng pull từ các sao mình theo dõi:
HYBRID đọc: pushed timeline:u7 = [tweet:celeb:1]
            pull author:celeb   = [tweet:celeb:1, :2, :3]
            -> merge 2 nguồn = feed hoàn chỉnh (chỉ pull từ VÀI sao)
Đọc rất rẻ trên Redis: redis-benchmark cho LRANGE đạt 350.877 lệnh/giây (p50 0,079ms). Một tweet siêu sao giờ tốn 0 lần push (thay vì 50 triệu) — chi phí dời sang lúc đọc, nơi có thể cache mạnh và chỉ gộp thêm từ vài sao mà mỗi người theo dõi.
Những bẫy hybrid không tự giải
- Hot key phía đọc. Khi sao đăng, hàng chục triệu follower cùng lúc pull cùng author timeline của sao — một key Redis hứng hàng trăm nghìn đọc/giây. Phải thêm cache tầng đọc (như request coalescing ở bài Discord) cho chính key nóng đó.
- Cold start. User lâu không vào có timeline cache rỗng (push tier không ghi cho key không ai đọc, hoặc cache đã bị đuổi) — lần mở lại phải dựng feed lúc đọc.
- Ranking. Feed hiện đại xếp theo mức độ liên quan, không thuần thời gian — thêm một tầng xếp hạng trên dữ liệu đã gộp, tốn thêm tính toán lúc đọc.
Đánh đổi cần cân nhắc
Ngưỡng nổi tiếng là knob quan trọng nhất. Đặt quá cao thì tầng "khá nổi" vẫn bị push (fanout vẫn đắt); đặt hợp lý (~chục nghìn) thì cắt phần lớn bão ghi. Con số đúng phụ thuộc phân bố follower thật — phải đo, không đoán.
Redis list không phải là tất cả. Timeline thật cần cắt độ dài (LTRIM), TTL, và thường lưu ID tweet chứ không lưu nội dung (hydrate lúc đọc). Ở quy mô Twitter, timeline cache còn shard theo user và có tầng lưu bền phía sau — Redis chỉ là lớp cache nóng.
Không có lời giải chỉ-ghi hay chỉ-đọc. Bài học tổng quát: khi tải lệch (một số tài khoản nóng hơn hẳn), giải pháp đồng nhất (xử mọi tweet như nhau) sẽ vỡ ở đuôi phân bố. Phải phân loại và xử khác nhau — đúng như hybrid phân biệt người thường và người nổi tiếng.
Ba ý mang về
- Push (fanout khi ghi) cho đọc O(1) nhưng vỡ ở người nổi tiếng: đo thật một tweet 50.000 follower = 50.000 LPUSH (76ms), và ngoại suy từ 362.976 LPUSH/giây thì tweet 50 triệu follower = ~138 giây fanout cho MỘT tweet — bài toán người nổi tiếng bằng số thật.
- Pull (fanout khi đọc) cho ghi rẻ nhưng đọc đắt: mỗi lượt đọc gộp từ mọi followee; hybrid lấy cái tốt của cả hai — push người thường, pull người nổi tiếng, merge lúc đọc (đọc
LRANGE350.877/giây trên Redis). - Phân loại theo ngưỡng là lời giải, nhưng vẫn phải xử hot key đọc + cold start: hybrid không tự giải chuyện hàng chục triệu người cùng đọc một author key khi sao đăng — cần thêm cache tầng đọc, LTRIM/TTL, và ranking.
Nguồn
- Raffi Krikorian (Twitter) — Timelines at Scale (QCon): https://www.infoq.com/presentations/Twitter-Timeline-Scalability/
- Redis Docs — Lists (LPUSH/LRANGE/LTRIM): https://redis.io/docs/latest/develop/data-types/lists/
Phần sau ta xét cách Cloudflare giới hạn tần suất ở biên — cũng dựng thật trên Redis bằng script Lua: sliding window counter chính xác mà chỉ tốn ~24 byte mỗi danh tính.
