Câu hỏi kinh doanh nào cũng dạng "tổng/trung bình/số lượng theo nhóm": doanh thu theo tháng, số đơn theo trạng thái, khách theo thành phố. Nếu bạn search hết bản ghi rồi tự cộng trong Python, vừa chậm vừa tốn RAM. Odoo có phương thức làm việc đó ngay tại cơ sở dữ liệu: read_group — chính là GROUP BY của SQL, gói trong ORM. Đây là nền tảng của mọi báo cáo, biểu đồ, pivot trong Odoo.
Cú pháp: domain + fields + groupby
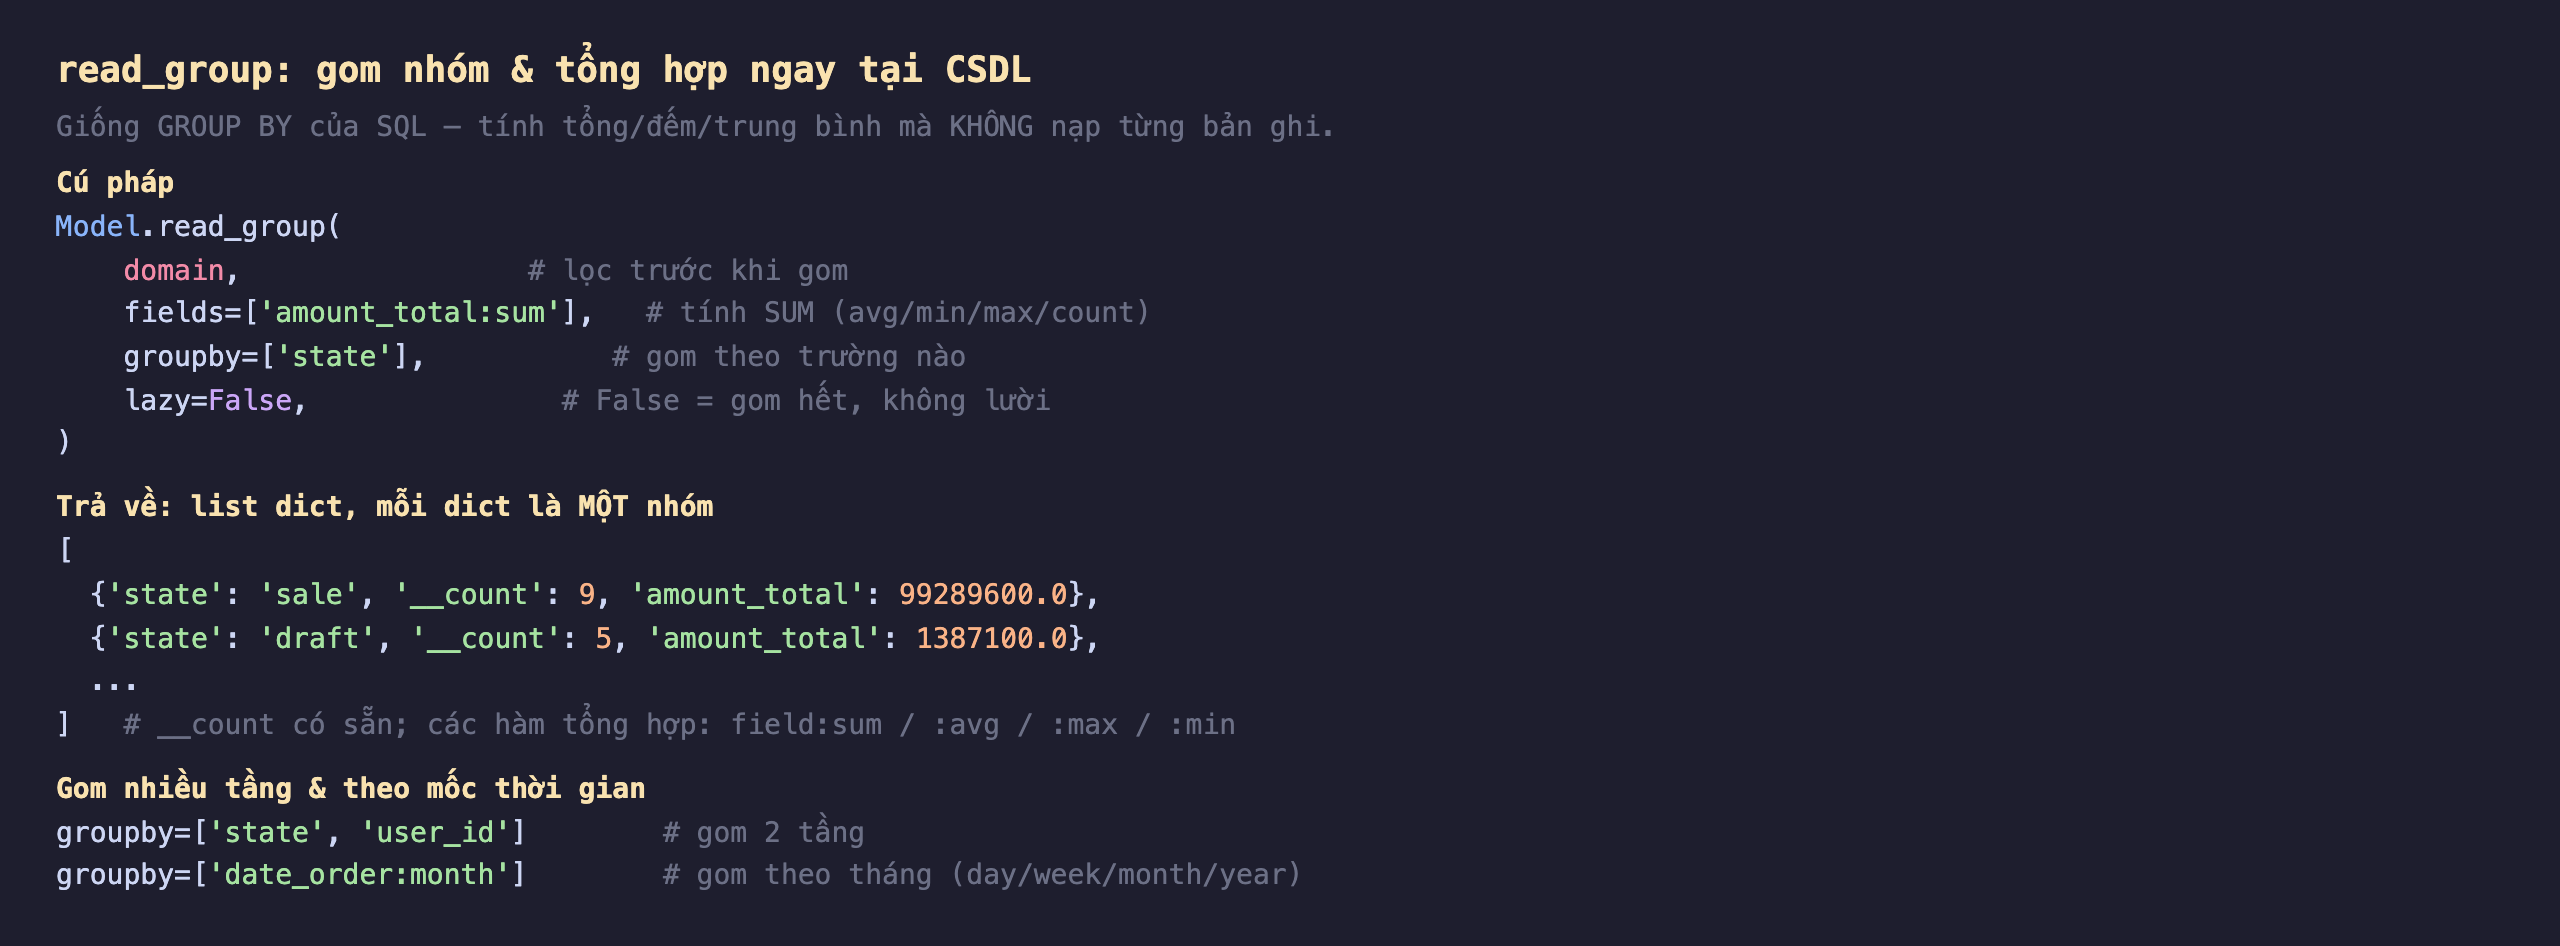
Hình 1: read_group(domain, fields, groupby, lazy). domain lọc trước khi gom (như đã học). fields khai hàm tổng hợp dạng 'trường:sum' (hoặc :avg, :max, :min). groupby là trường để gom. Trả về list dict, mỗi dict là một nhóm, luôn có __count (số bản ghi trong nhóm).
Chạy thật — thấy sức mạnh
Đây là output thật trên db blog19:
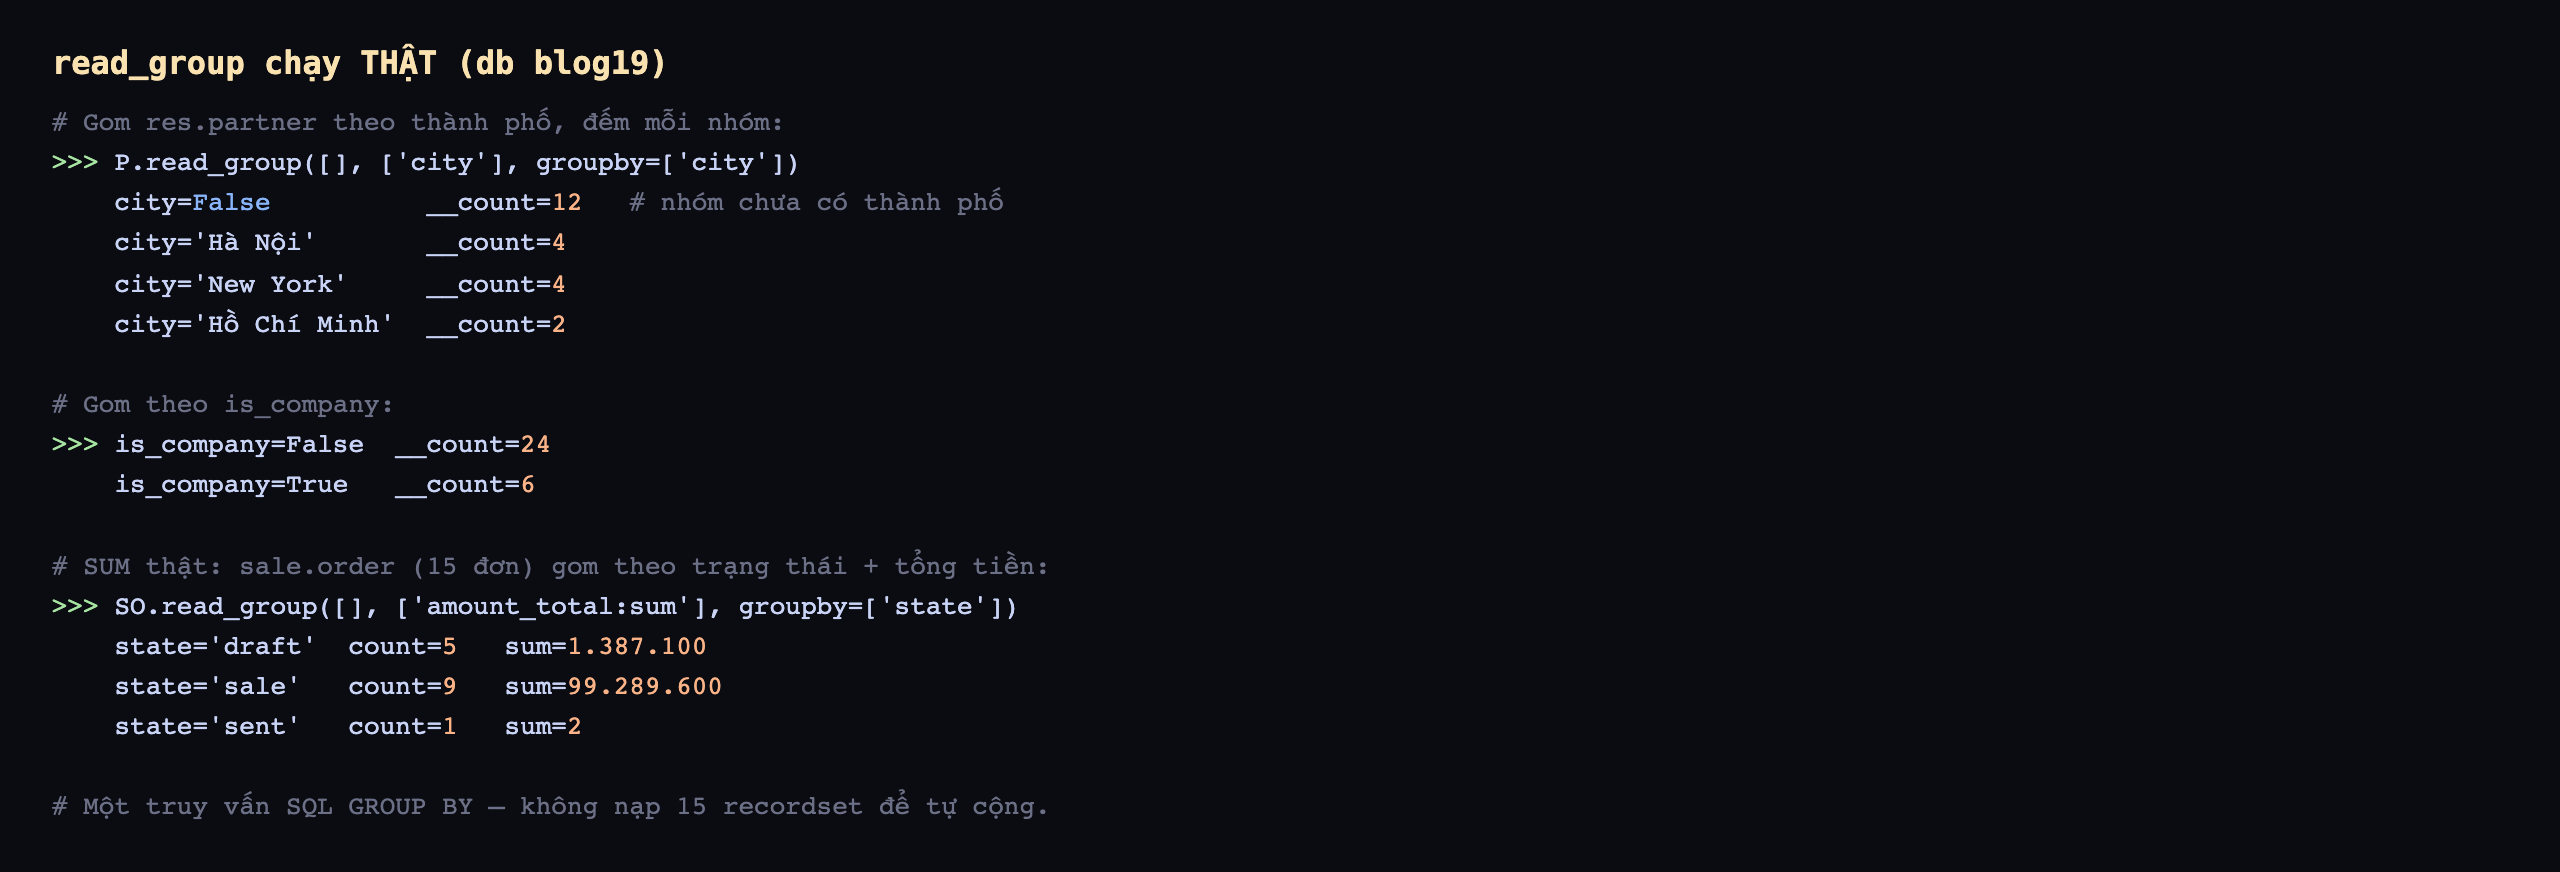
Hình 2: Output thật. Gom res.partner theo city cho số lượng từng thành phố (chú ý nhóm city=False = 12 gộp các bản ghi chưa có thành phố). Gom theo is_company: 24 cá nhân, 6 công ty. Và phần mạnh nhất: gom 15 đơn sale.order theo state kèm SUM amount_total — sale: 9 đơn, tổng 99.289.600; draft: 5 đơn, 1.387.100. Tất cả bằng một truy vấn GROUP BY, không nạp 15 recordset về cộng tay.
Các hàm tổng hợp
Khai trong fields với hậu tố sau dấu hai chấm:
:sum— tổng (doanh thu, số lượng).:avg— trung bình (giá trị đơn trung bình).:max/:min— lớn nhất / nhỏ nhất.__count— số bản ghi mỗi nhóm (tự có, không cần khai).
env['sale.order'].read_group(
    [('state', '=', 'sale')],           # chỉ đơn đã xác nhận
    fields=['amount_total:sum', 'amount_total:avg'],
    groupby=['user_id'],                # theo nhân viên bán
)
Gom nhiều tầng và theo thời gian
groupby nhận list nhiều trường để gom lồng, và hỗ trợ mốc thời gian trên trường ngày:
# Doanh thu theo tháng
groupby=['date_order:month']            # cũng có :day, :week, :quarter, :year

# Gom hai tầng: theo trạng thái, rồi theo nhân viên
groupby=['state', 'user_id']
Gom theo :month chính là cách Odoo dựng biểu đồ doanh thu theo thời gian mà bạn thấy trên dashboard.
lazy=True vs lazy=False
Mặc định lazy=True: Odoo chỉ gom theo trường đầu tiên trong groupby, các tầng sau để "lười" tính khi cần (phục vụ giao diện gấp/mở nhóm). Khi bạn cần kết quả gom đầy đủ ngay (báo cáo, xử lý dữ liệu), truyền lazy=False để gom hết mọi tầng một lần — như các ví dụ ở Hình 2.
Vì sao đừng tự gom trong Python
# ✗ Cách chậm: nạp hết rồi tự cộng
tong = sum(o.amount_total for o in env['sale.order'].search([]))

# ✓ Cách đúng: CSDL cộng, chỉ trả về con số
res = env['sale.order'].read_group([], ['amount_total:sum'], [])
tong = res[0]['amount_total']
Cách đầu nạp mọi đơn thành recordset (đắt, tốn RAM); cách sau để PostgreSQL cộng và chỉ trả một con số. Với bảng lớn, khác biệt là một trời một vực — chính là bài học hiệu năng xuyên suốt create, write, search: để CSDL làm việc của CSDL.
Nhớ ba ý
read_grouplàGROUP BYcủa Odoo: gom nhóm + tính sum/avg/max/min/count ngay tại CSDL, trả về list dict mỗi nhóm (luôn có__count).- Khai hàm tổng hợp dạng
'trường:sum';groupbynhận nhiều tầng và mốc thời gian (date_order:month) — nền của báo cáo, biểu đồ, pivot. - Đừng
searchhết rồi tự cộng trong Python — dùngread_group(vớilazy=Falsekhi cần kết quả đầy đủ) để CSDL làm việc nặng.
Xong bộ CRUD đọc–tạo–sửa–tổng hợp, còn thao tác cuối: xóa. Phần sau đi vào unlink() và ràng buộc khóa ngoại — vì sao xóa một bản ghi đôi khi bị chặn, và cách xử lý đúng.
