Goroutine rẻ đến mức dễ lạm dụng: thấy 1000 job, viết for i { go lamViec(i) } — 1000 goroutine, xong. Nhưng ở quy mô thật, mẫu này là công thức sập: một triệu job tạo một triệu goroutine (mỗi cái ít nhất 2KB stack = 2GB), và không có gì kiểm soát tải khi producer nhanh hơn hệ thống chịu được. Giải pháp là worker pool có giới hạn với backpressure. Bài này xây và đo thật hai thuộc tính giúp hệ thống chậm lại thay vì sập.
Vấn đề: 1 goroutine mỗi job
for i := 0; i < 1000000; i++ {
	go lamViec(i)   // 1 TRIỆU goroutine cùng lúc!
}
Hai vấn đề: (1) một triệu goroutine × 2KB stack = 2GB bộ nhớ chỉ cho stack, có thể OOM; (2) không kiểm soát tải — nếu lamViec gọi DB, một triệu goroutine đè lên DB cùng lúc. Số goroutine bùng nổ theo số job, không có trần.
Worker pool: số worker cố định
jobs := make(chan int, QUEUE)   // channel đệm = hàng đợi GIỚI HẠN

// đúng WORKERS goroutine, mỗi cái xử lý job từ channel
for w := 0; w < WORKERS; w++ {
	go func() {
		for job := range jobs { lamViec(job) }
	}()
}
Thay vì một goroutine mỗi job, ta có đúng WORKERS goroutine, mỗi cái lặp lấy job từ channel. Số goroutine cố định bất kể có bao nhiêu job — 100 hay một triệu job đều chỉ WORKERS goroutine.
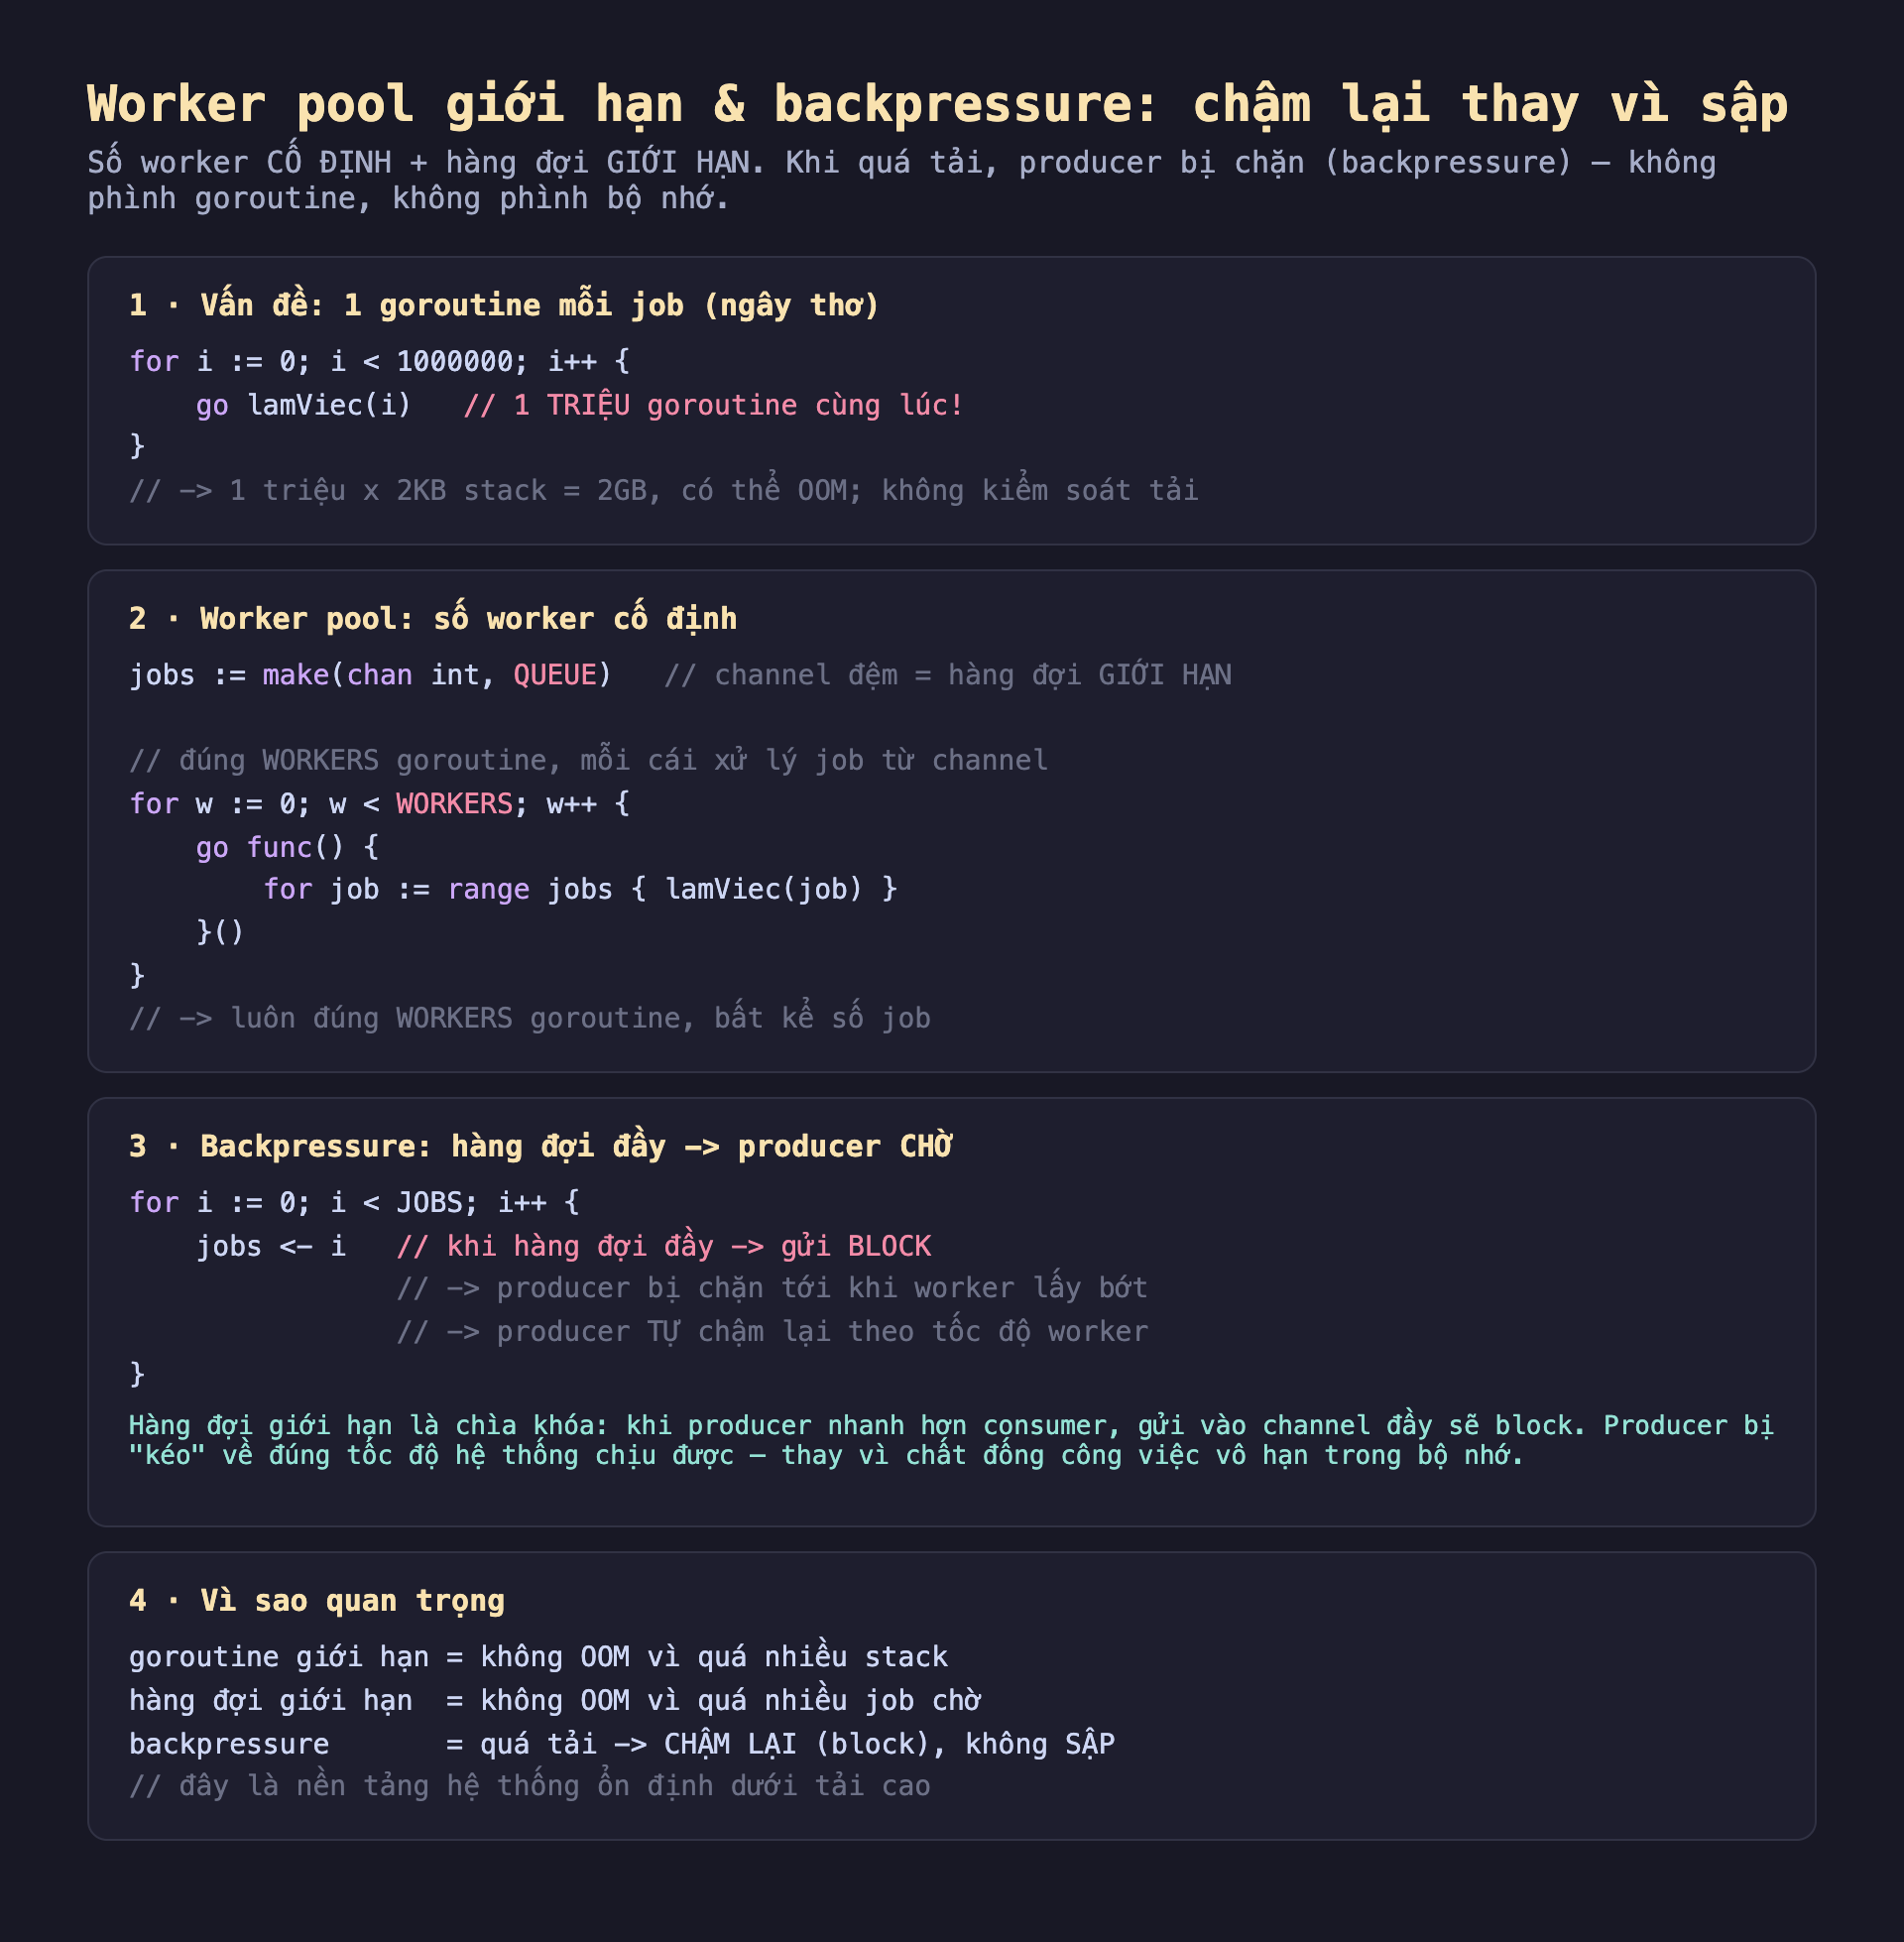
Hình 1: Worker pool giới hạn. Cách ngây thơ (1 goroutine/job) vs pool (WORKERS cố định); backpressure khi hàng đợi giới hạn đầy chặn producer; hai thuộc tính bảo vệ hệ thống.
Backpressure: hàng đợi đầy chặn producer
Đây là phần tinh tế và quan trọng nhất. Channel jobs có đệm giới hạn (QUEUE). Khi producer đẩy job nhanh hơn worker xử lý, hàng đợi đầy — và jobs <- i sẽ block:
for i := 0; i < JOBS; i++ {
	jobs <- i   // khi hàng đợi đầy → gửi BLOCK
	            // → producer bị chặn tới khi worker lấy bớt
	            // → producer TỰ chậm lại theo tốc độ worker
}
Backpressure là cơ chế này: khi hệ thống quá tải, producer bị kéo về đúng tốc độ hệ thống chịu được, thay vì chất đống công việc vô hạn trong bộ nhớ. Đây là điểm khác biệt giữa hàng đợi giới hạn (an toàn) và hàng đợi vô hạn (nguy hiểm — đầy bộ nhớ rồi sập).
Đo thật: goroutine không bùng nổ, backpressure hoạt động
Chạy 100 job (mỗi job 5ms) qua pool (4 worker, hàng đợi 8) và so với cách ngây thơ:
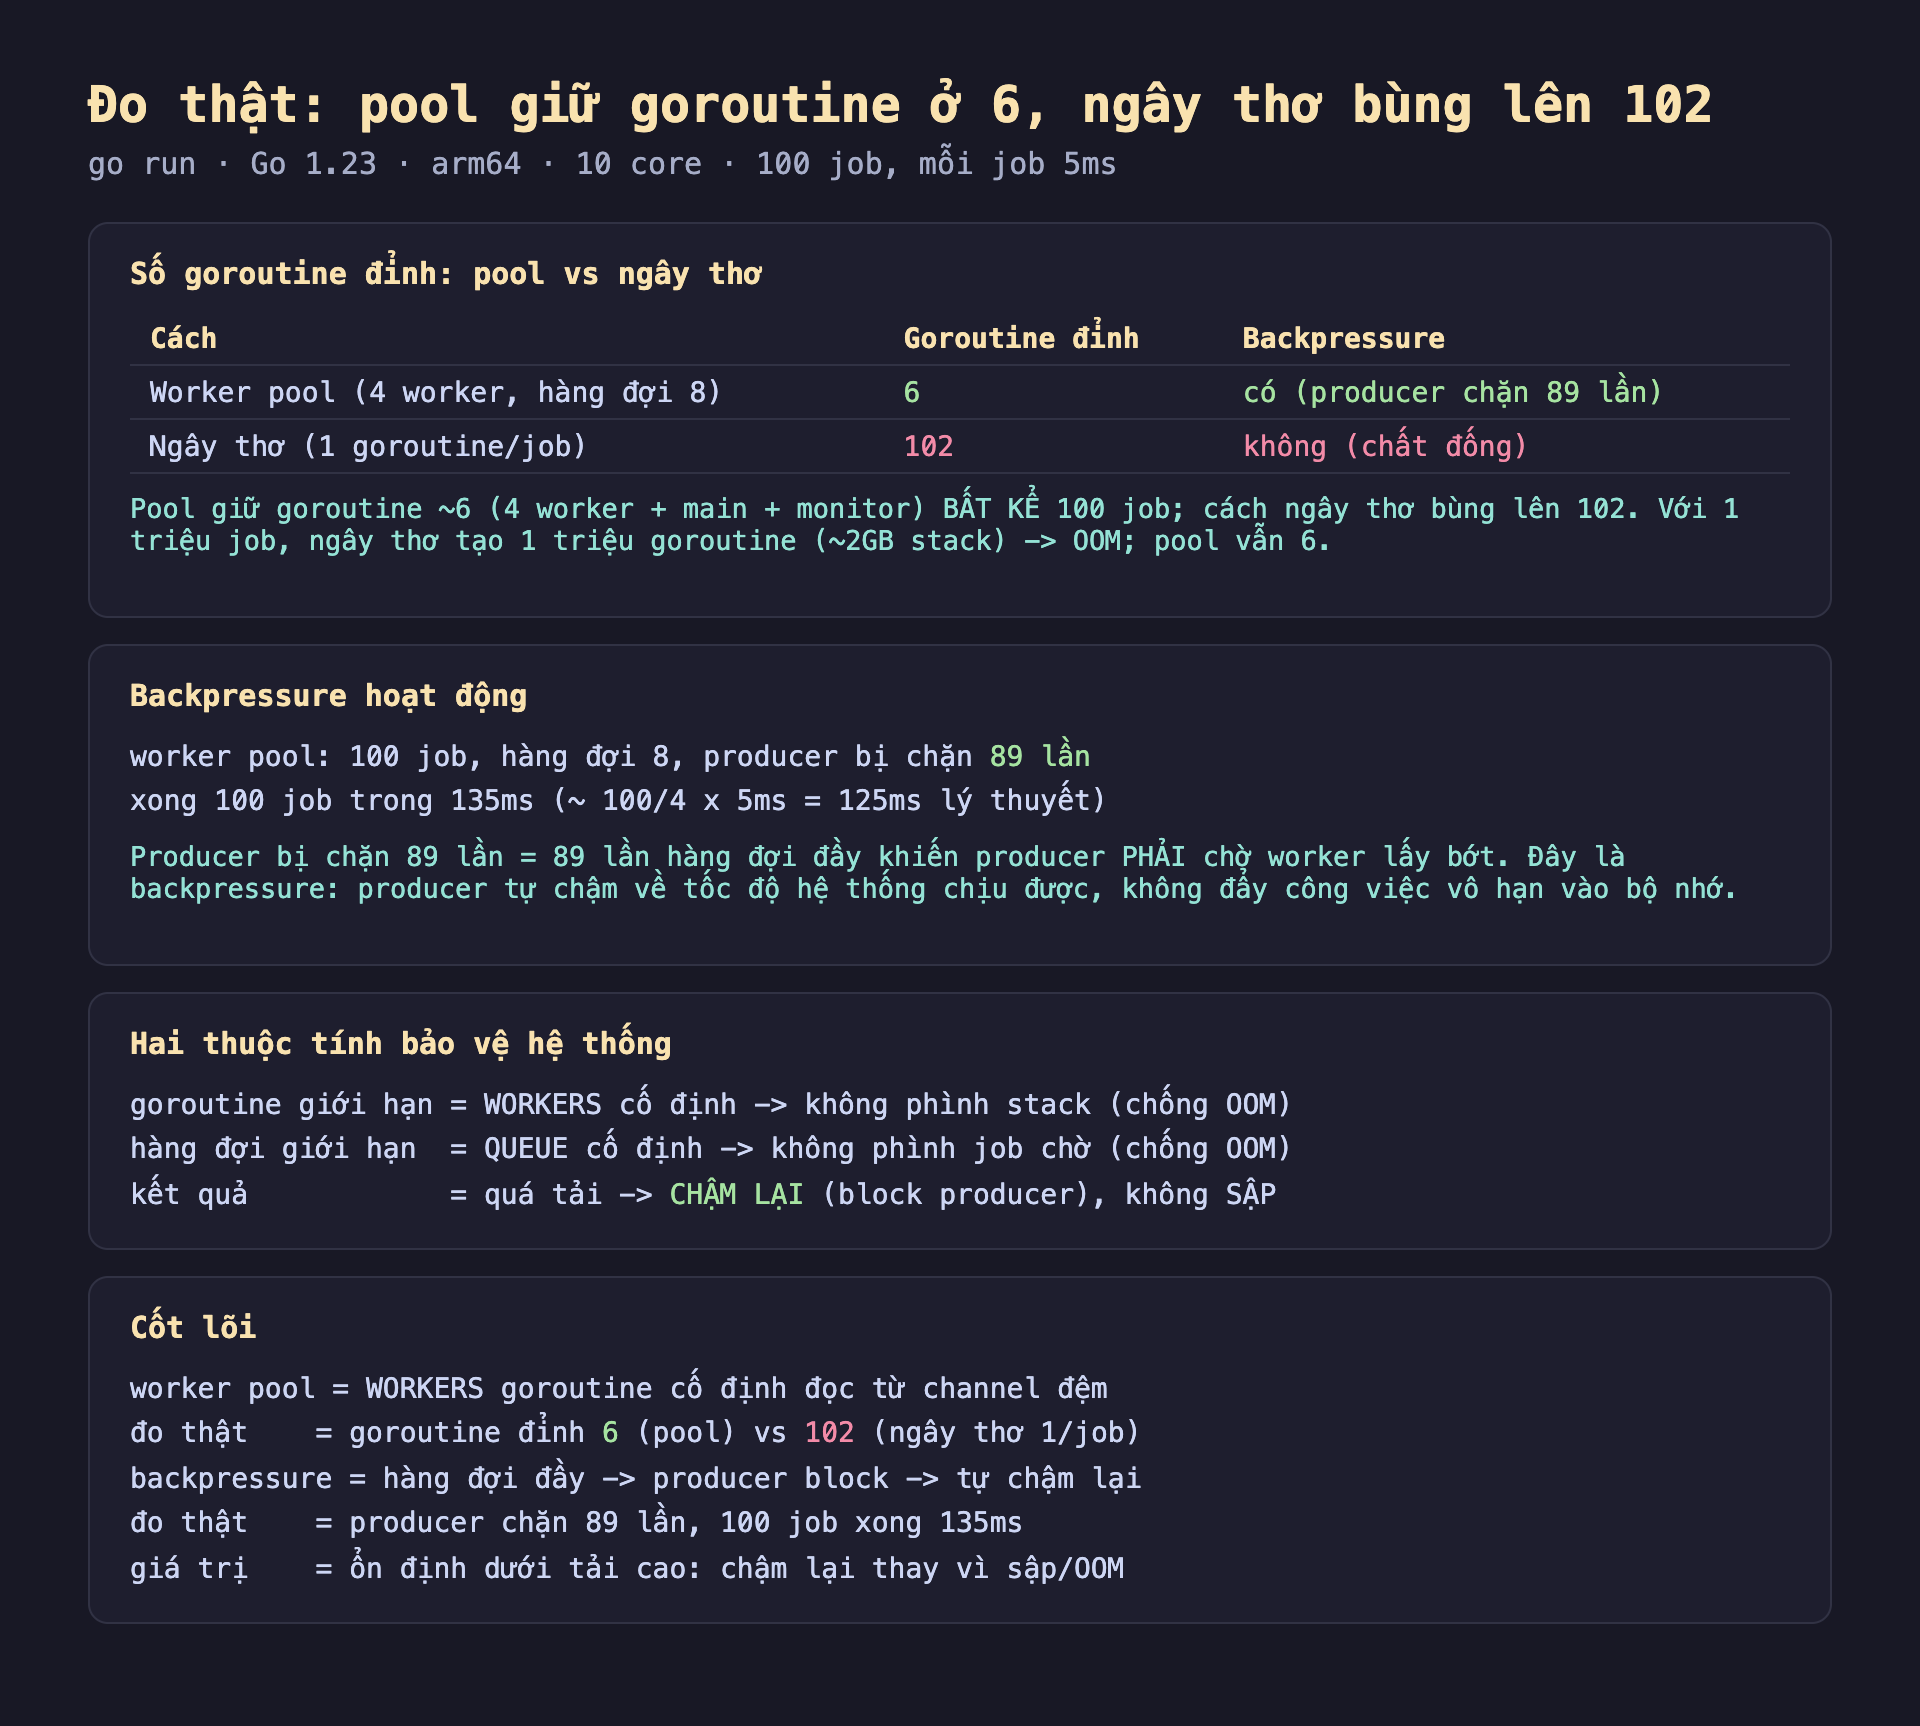
Hình 2: Goroutine đỉnh — pool 6 vs ngây thơ 102. Backpressure — producer bị chặn 89 lần, 100 job xong 135ms (≈ 100/4×5ms). Hai thuộc tính bảo vệ hệ thống.
- Worker pool (4 worker, hàng đợi 8): goroutine đỉnh 6 (4 worker + main + monitor), producer bị chặn 89 lần.
- Ngây thơ (1 goroutine/job): goroutine đỉnh 102 — bùng nổ theo số job.
Pool giữ goroutine ~6 bất kể 100 job; cách ngây thơ bùng lên 102. Với một triệu job, ngây thơ tạo một triệu goroutine (~2GB stack) → OOM; pool vẫn 6. Và producer bị chặn 89 lần = 89 lần hàng đợi đầy khiến nó phải chờ — chính là backpressure hoạt động, giữ tải trong tầm kiểm soát. 100 job xong trong 135ms (≈ 100/4 × 5ms = 125ms lý thuyết cho song song có giới hạn).
Ứng dụng thực tế
Xử lý hàng loạt / ETL. Đọc một triệu dòng từ file/DB và xử lý mỗi dòng — đừng go mỗi dòng. Dùng pool worker để giới hạn song song, và channel giới hạn để producer (reader) tự chậm theo tốc độ processor. Bộ nhớ ổn định bất kể kích thước input.
Server nhận request bùng nổ. Nếu mỗi request khởi một goroutine gọi DB, một đợt traffic tạo hàng nghìn goroutine đè DB. Đặt một pool (hoặc semaphore từ bài trước) trước phần nặng để giới hạn song song, và trả 503 khi hàng đợi đầy (thay vì block) nếu cần bảo vệ độ trễ.
Số worker theo tài nguyên, không theo job. Chọn WORKERS theo cái hạn chế thực sự: CPU cores cho việc CPU-bound, giới hạn kết nối DB cho việc DB-bound, không theo số job. Đây là điều chỉnh hiệu năng chính của pool.
Đánh đổi cần cân nhắc
Block producer là đúng, nhưng đôi khi cần drop hoặc trả lỗi. Backpressure bằng block phù hợp khi producer có thể chờ (ETL, batch). Nhưng với request người dùng, block quá lâu là trải nghiệm tệ — khi đó dùng select với default để drop job hoặc trả 503 ngay ("fail fast"). Chọn block hay drop tùy job có chờ được không.
Chọn kích thước hàng đợi cẩn thận. Hàng đợi lớn hấp thụ đợt dồn tốt hơn (ít block) nhưng tăng độ trễ (job chờ lâu trong hàng đợi) và dùng nhiều bộ nhớ hơn. Hàng đợi nhỏ cho backpressure sớm và độ trễ thấp nhưng block producer nhiều hơn. Không có số đúng tuyệt đối — cân theo đợt dồn dự kiến và độ trễ chấp nhận được.
Đừng tự viết pool khi thư viện chuẩn đủ. Với các trường hợp phổ biến, golang.org/x/sync/errgroup (có SetLimit, bài sau) hoặc một semaphore đơn giản đã đủ và ít lỗi hơn tự viết pool. Chỉ tự dựng khi cần kiểm soát chi tiết (hàng đợi ưu tiên, worker động). Mẫu pool ở bài này là để hiểu cơ chế.
Ba ý mang về
- Worker pool giới hạn goroutine bằng số worker cố định: đo thật pool giữ goroutine ở 6 trong khi cách ngây thơ 1-goroutine-mỗi-job bùng lên 102 — với một triệu job, ngây thơ tạo một triệu goroutine (~2GB stack) OOM, còn pool vẫn cố định; số goroutine không bùng nổ theo số job.
- Backpressure giữ tải trong tầm kiểm soát bằng hàng đợi giới hạn: đo thật producer bị chặn 89 lần khi hàng đợi đầy — nó tự chậm lại về tốc độ hệ thống chịu được thay vì chất đống công việc vô hạn vào bộ nhớ; đây là khác biệt giữa hàng đợi giới hạn (an toàn) và vô hạn (sập).
- Kết quả là hệ thống chậm lại thay vì sập dưới tải cao: hai thuộc tính (goroutine giới hạn + hàng đợi giới hạn) chống OOM; chọn
WORKERStheo tài nguyên hạn chế thực sự, và cân nhắc block vs drop/503 tùy job có chờ được không — dùngerrgroup.SetLimithoặc semaphore cho trường hợp phổ biến.
Bài tập làm thử
Bài 1 (đọc hiểu — vấn đề). Giải thích hai vấn đề cụ thể của mẫu code sau khi chạy với một triệu job, được nêu trong bài viết.
for i := 0; i < 1000000; i++ {
	go lamViec(i)
}
Đáp án
Hai vấn đề: (1) Bùng nổ bộ nhớ stack: mỗi goroutine tốn tối thiểu ~2KB stack, một triệu goroutine cùng lúc tốn khoảng 2GB chỉ riêng cho stack, có thể dẫn tới hết bộ nhớ (OOM). (2) Không kiểm soát tải: nếu lamViec gọi tới một tài nguyên hạn chế như DB, toàn bộ một triệu goroutine sẽ đè lên DB gần như cùng lúc, không có cơ chế nào giới hạn số lượng thao tác đồng thời tới tài nguyên đó. Nói chung, số goroutine bùng nổ tuyến tính theo số job, không có trần giới hạn nào.
Bài 2 (đọc hiểu — sửa bằng worker pool). Giải thích tại sao đoạn code sau giữ số goroutine cố định bất kể có bao nhiêu job, khác hẳn với mẫu ở Bài 1.
jobs := make(chan int, QUEUE)
for w := 0; w < WORKERS; w++ {
	go func() {
		for job := range jobs { lamViec(job) }
	}()
}
Đáp án
Ở đây chỉ có đúng WORKERS goroutine được tạo ra (vòng lặp for w := 0; w < WORKERS; w++ chạy đúng WORKERS lần), mỗi goroutine chạy một vòng lặp for job := range jobs để liên tục lấy job từ channel jobs và xử lý tuần tự. Số lượng job (dù là 100 hay một triệu) chỉ ảnh hưởng tới số lần channel jobs được gửi/nhận, không tạo thêm goroutine nào — vì job không còn được gán trực tiếp cho một goroutine mới, mà được đẩy vào một hàng đợi (channel) để các worker cố định tự lấy ra xử lý dần.
Bài 3 (đọc hiểu cốt lõi — backpressure). Giải thích cơ chế backpressure trong đoạn code sau, và tại sao nó là "khác biệt giữa hàng đợi giới hạn (an toàn) và hàng đợi vô hạn (nguy hiểm)".
jobs := make(chan int, QUEUE) // QUEUE là số nguyên hữu hạn
for i := 0; i < JOBS; i++ {
	jobs <- i
}
Đáp án
Vì channel jobs có bộ đệm hữu hạn (QUEUE), khi producer (vòng lặp gửi) đẩy job nhanh hơn tốc độ các worker tiêu thụ, hàng đợi sẽ đầy — và lệnh jobs <- i tiếp theo sẽ block cho tới khi có worker lấy bớt job ra, tạo chỗ trống. Cơ chế này khiến producer bị "kéo về" đúng tốc độ mà hệ thống (worker) có thể xử lý — đây chính là backpressure. Nếu dùng một channel không giới hạn (hoặc một slice tăng trưởng vô hạn) làm hàng đợi, producer sẽ không bao giờ bị chặn, có thể tiếp tục nhồi job vào bộ nhớ nhanh hơn tốc độ xử lý, khiến hàng đợi phình to vô hạn cho tới khi hết bộ nhớ và sập — hàng đợi giới hạn biến vấn đề "sập vì quá tải bộ nhớ" thành "chậm lại có kiểm soát".
Bài 4 (đọc hiểu số liệu). Bài đo với 100 job (mỗi job 5ms), pool có 4 worker và hàng đợi 8: goroutine đỉnh là 6, producer bị chặn 89 lần, tổng thời gian hoàn thành ~135ms (gần khớp công thức lý thuyết 100/4 × 5ms = 125ms). Giải thích ý nghĩa của con số "goroutine đỉnh = 6" (tại sao không phải đúng 4), và ý nghĩa của "producer bị chặn 89 lần".
Đáp án
"Goroutine đỉnh = 6" không phải chỉ tính 4 worker, mà còn tính thêm goroutine main (chạy vòng lặp producer đẩy job) và một goroutine monitor (dùng để quan sát/đo số goroutine trong bài đo) — tổng 4 worker + main + monitor = 6, và con số này giữ cố định bất kể có bao nhiêu job (100 hay nhiều hơn), khác hẳn cách ngây thơ bùng lên 102. "Producer bị chặn 89 lần" nghĩa là trong số 100 lần gửi job vào channel, có 89 lần hàng đợi (dung lượng 8) đã đầy tại thời điểm gửi, khiến câu lệnh jobs <- i phải chờ tới khi một worker lấy bớt job ra mới gửi được — đây chính là bằng chứng đo thật cho thấy backpressure đang hoạt động, producer bị "ghìm" lại theo đúng tốc độ 4 worker có thể xử lý.
Bài 5 (bẫy/đánh đổi — vận dụng). Một service xử lý request trực tiếp từ người dùng (không phải batch job) gọi một pool worker để xử lý phần nặng, và hàng đợi luôn đầy vào giờ cao điểm khiến mọi request bị block rất lâu chờ tới lượt. Dựa trên khuyến nghị của bài, nêu một giải pháp thay thế phù hợp hơn cho tình huống này, và giải thích khi nào block là lựa chọn đúng.
Đáp án
Với request người dùng (nơi độ trễ cảm nhận được là quan trọng), block quá lâu là trải nghiệm tệ; giải pháp phù hợp hơn là dùng select với default để phát hiện hàng đợi đầy ngay lập tức và drop job hoặc trả lỗi 503 cho client thay vì bắt họ chờ vô thời hạn ("fail fast") — cho người dùng biết ngay hệ thống đang quá tải thay vì để họ chờ mòn mỏi rồi mới timeout. Block là lựa chọn đúng khi producer có thể chờ được mà không ảnh hưởng trải nghiệm — ví dụ các tác vụ xử lý hàng loạt/ETL/batch chạy nền, nơi việc chậm lại một chút không gây hại, và mục tiêu chính là giữ hệ thống ổn định về bộ nhớ chứ không phải phản hồi tức thì.
Phần sau ta xem chính công cụ thư viện chuẩn vừa nhắc để giới hạn goroutine gọn gàng: Phần sau mổ xẻ errgroup với SetLimit — cách chạy nhóm goroutine có giới hạn số đồng thời, gom lỗi và hủy sớm, gọn hơn tự dựng pool.
