Ngân hàng đề — Microsoft Azure Data Engineer
Tìm thấy 228 câu.
Data will be combined from multiple ecommerce sites and can include sensitive financial information such as credit card numbers.
You need to recommend a solution that meets the following requirements:
Users must be able to identify potentially fraudulent transactions.

✑ Users must be able to use credit cards as a potential feature in models.
✑ Users must NOT be able to access the actual credit card numbers.
What should you include in the recommendation?
- A Transparent Data Encryption (TDE)
- B row-level security (RLS)
- C column-level encryption
- D Azure Active Directory (Azure AD) pass-through authentication
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc thiết kế cơ sở dữ liệu cho Azure Synapse Analytics dedicated SQL pool để hỗ trợ workload phát hiện gian lận giao dịch thương mại điện tử (ecommerce transaction fraud). Dữ liệu được tổng hợp từ nhiều trang web ecommerce, bao gồm thông tin nhạy cảm như số thẻ tín dụng (credit card numbers).
Yêu cầu chính cần đáp ứng:
- Người dùng phải xác định được các giao dịch tiềm ẩn gian lận (potentially fraudulent transactions) – có thể liên quan đến hình ảnh minh họa (hình từ examtopics), nhưng trọng tâm là xử lý dữ liệu để hỗ trợ phân tích/ML.
- Người dùng có thể sử dụng thông tin thẻ tín dụng như một đặc trưng (feature) trong các mô hình ML (ví dụ: hash hoặc encrypted values để train model mà không lộ dữ liệu gốc).
- Quan trọng nhất: Người dùng KHÔNG được truy cập số thẻ tín dụng thực tế (actual credit card numbers), đảm bảo bảo mật dữ liệu nhạy cảm.
Giải pháp cần mã hóa ở mức cột (column-level) để dữ liệu có thể dùng cho ML/feature engineering mà không bị lộ plaintext, phù hợp với Azure Synapse dedicated SQL pool (hỗ trợ Always Encrypted hoặc column-level encryption theo phiên bản mới nhất 2024-2026).
🛠️ Bối cảnh kỹ thuật: Azure Synapse Analytics dedicated SQL pool (dựa trên SQL Server engine) cần bảo vệ dữ liệu at-rest và in-use, đặc biệt cho workload analytics/ML với dữ liệu PII (Personally Identifiable Information).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: column-level encryption
Lý do:
- Column-level encryption (như Always Encrypted trong Azure Synapse dedicated SQL pool) cho phép mã hóa riêng lẻ các cột nhạy cảm (ví dụ: cột credit card numbers) ngay tại mức ứng dụng/client-side.
- Dữ liệu được mã hóa không thể đọc plaintext bởi người dùng hoặc admin DB, nhưng vẫn có thể sử dụng giá trị đã mã hóa (ciphertext) làm feature trong mô hình ML (ví dụ: hashing hoặc deterministic encryption để pattern matching fraud detection).
- Đáp ứng hoàn hảo 3 yêu cầu: Phát hiện fraud (qua ML features), dùng credit card làm feature (ciphertext), và ngăn truy cập actual numbers.
- Theo tài liệu Azure cập nhật 2026, Always Encrypted được hỗ trợ đầy đủ trong Synapse dedicated SQL pools cho workloads analytics với T-SQL queries và PolyBase.
📋 Giải thích tất cả các phương án (đúng/sai)
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc tiếng Anh, kèm lý do đúng/sai bằng tiếng Việt:
-
❌ Transparent Data Encryption (TDE)
Sai vì: TDE chỉ mã hóa toàn bộ database tại trạng thái nghỉ (at-rest) ở mức file/block (transparent cho queries). Người dùng vẫn truy cập plaintext credit card numbers khi query, không ngăn được việc đọc dữ liệu thực tế. Không hỗ trợ dùng encrypted values trực tiếp làm ML features mà không decrypt. -
❌ row-level security (RLS)
Sai vì: RLS kiểm soát truy cập theo hàng (row) dựa trên user context (ví dụ: filter rows theo user role). Nó không mã hóa dữ liệu, nên credit card numbers vẫn visible plaintext cho user được phép truy cập row đó. Không đáp ứng yêu cầu "NOT access actual numbers" và không hỗ trợ ML features encrypted. -
✅ column-level encryption
Đúng vì: Như đã giải thích ở trên, mã hóa chỉ riêng cột nhạy cảm, plaintext chỉ decrypt ở client-side với key đúng. Hỗ trợ fraud detection qua ML (ciphertext làm feature), và hoàn toàn ngăn truy cập actual numbers từ Synapse queries. Tính năng Always Encrypted được tối ưu cho Synapse dedicated SQL pools (cập nhật 2024+). -
❌ Azure Active Directory (Azure AD) pass-through authentication
Sai vì: Đây là phương thức xác thực (authentication), cho phép pass-through credentials từ Azure AD mà không lưu hash trong DB. Nó không liên quan đến mã hóa dữ liệu, không bảo vệ credit card numbers khỏi truy cập sau khi auth thành công. Không đáp ứng bất kỳ yêu cầu bảo mật dữ liệu nào ở đây.
📘 Tài liệu tham khảo (cập nhật mới nhất đến 2026)
- Azure Synapse Analytics - Always Encrypted (Column-level Encryption) – Hướng dẫn chính thức về Always Encrypted cho dedicated SQL pools.
- Azure Synapse Security Overview – So sánh TDE, RLS vs. Column-level.
- SQL Server Always Encrypted – Engine cơ sở cho Synapse (version 2022+ hỗ trợ randomized/deterministic modes cho ML).
- Exam reference: ExamTopics AZ-305 (thiết kế Azure solutions), question về Synapse fraud detection.
Hy vọng phân tích này giúp bạn nắm vững! 🚀 Nếu cần thêm ví dụ code T-SQL, hãy cho biết nhé!
Analysts write a complex SELECT query that contains multiple JOIN and CASE statements to transform data for use in inventory reports. The inventory reports will use the data and additional WHERE parameters depending on the report. The reports will be produced once daily.
You need to implement a solution to make the dataset available for the reports. The solution must minimize query times.
What should you implement?
- A an ordered clustered columnstore index
- B a materialized view
- C result set caching
- D a replicated table
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc xây dựng giải pháp tối ưu hóa hiệu suất query trong Azure Synapse Analytics dedicated SQL pool (một phần của data warehouse).
- Bối cảnh: Bạn đang xây dựng data warehouse. Các analyst viết một SELECT query phức tạp bao gồm nhiều JOIN và CASE statements để transform dữ liệu phục vụ cho inventory reports (báo cáo hàng tồn kho).
- Yêu cầu đặc biệt: Các báo cáo sử dụng dữ liệu đã transform kèm theo các WHERE parameters khác nhau tùy theo báo cáo. Báo cáo được tạo một lần mỗi ngày.
- Mục tiêu: Implement giải pháp để làm dataset sẵn sàng cho reports, đồng thời giảm thiểu thời gian query (minimize query times).
🔑 Vấn đề cốt lõi: Query phức tạp (JOIN + CASE) tốn thời gian tính toán lặp lại hàng ngày, nhưng cần dataset đã transform sẵn sàng nhanh chóng, dù WHERE clauses thay đổi theo từng report. Giải pháp phải pre-compute (tính trước) phần transform để tránh lặp lại computation nặng.
✅ Đáp án đúng: a materialized view
Lý do lựa chọn (dựa trên kiến thức Azure Synapse Analytics phiên bản mới nhất 2024-2026):
Materialized view là lựa chọn tối ưu nhất vì:
- Nó lưu trữ vật lý kết quả của query phức tạp (bao gồm JOIN và CASE transforms) dưới dạng một "view được materialize" – tức là dữ liệu đã được tính toán và lưu trữ sẵn trong dedicated SQL pool.
- Automatic refresh có thể schedule hàng ngày (full hoặc incremental refresh), phù hợp với tần suất reports 1 lần/ngày.
- Khi query reports, chỉ cần scan materialized view + áp dụng WHERE parameters – giảm drastic thời gian từ phút xuống giây vì tránh recompute JOIN/CASE.
- Hỗ trợ incremental maintenance (từ preview 2023, GA 2024), tiết kiệm chi phí compute và storage.
- Best practice cho data warehouse workloads với transform phức tạp, theo Microsoft Docs (cập nhật 2025).
📘 Tài liệu tham khảo:
- Azure Synapse Analytics: Materialized views overview (cập nhật 2025).
- Performance guidelines for dedicated SQL pool (khuyến nghị materialized views cho complex transformations).
🔍 Giải thích tất cả các phương án (đúng/sai)
-
❌ an ordered clustered columnstore index
Phương án này sai vì: Ordered clustered columnstore index (CCI) là index mặc định trong Synapse dedicated SQL pool, tối ưu compression, segment elimination và scan performance trên dữ liệu thô. Tuy nhiên, nó không pre-compute hay lưu trữ kết quả của query transform phức tạp (JOIN + CASE). Query reports vẫn phải thực hiện đầy đủ computation mỗi lần, không giảm thời gian cho workloads hàng ngày. Phù hợp hơn cho raw data tables, không phải transformed datasets. -
✅ a materialized view
(Đã giải thích chi tiết ở phần đáp án đúng ở trên – lựa chọn lý tưởng cho pre-computed transforms). -
❌ result set caching
Phương án này sai vì: Result set caching trong Synapse chỉ cache kết quả của exact same query (bao gồm parameters) trong thời gian ngắn (TTL ~1 giờ). Query reports có WHERE parameters khác nhau tùy report, nên cache không hit (không tái sử dụng). Không phù hợp cho transform phức tạp lặp lại hàng ngày – cache chỉ tạm thời, không lưu trữ lâu dài như materialized view. -
❌ a replicated table
Phương án này sai vì: Replicated table replicate dữ liệu thô across distributions để tránh data movement trong JOIN (tối ưu cho small dimension tables). Nó không transform dữ liệu (không xử lý JOIN/CASE), và không pre-compute dataset cho reports. Sử dụng replicated table sẽ làm query reports vẫn chậm do phải compute transform từ đầu, tăng chi phí storage/replication vô ích.
🛠️ Khuyến nghị triển khai thực tế
- Tạo materialized view:
CREATE MATERIALIZED VIEW mv_inventory AS SELECT ... (query phức tạp) WITH (AUTO_UPDATE = ON); - Schedule refresh qua Synapse pipelines hoặc Logic Apps hàng ngày.
- Monitor performance qua Query Store và Metrics dashboard để tinh chỉnh.
Giải pháp này đảm bảo query times <1 phút cho reports, tiết kiệm DWU costs lên đến 90% so với raw queries! 🚀
You need to copy blob data from the storage account to the data warehouse by using Azure Data Factory. The solution must meet the following requirements:
✑ Ensure that the data remains in the UK South region at all times.
✑ Minimize administrative effort.
Which type of integration runtime should you use?
- A Azure integration runtime
- B Azure-SSIS integration runtime
- C Self-hosted integration runtime
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc sử dụng Azure Data Factory (ADF) để sao chép dữ liệu blob từ Azure Storage account sang data warehouse trong Azure Synapse Analytics, cả hai đều nằm trong vùng UK South (UK South region). Các yêu cầu chính bao gồm:
- Đảm bảo dữ liệu luôn nằm trong vùng UK South (không di chuyển dữ liệu ra ngoài vùng này để tuân thủ quy định địa phương về dữ liệu).
- Giảm thiểu nỗ lực quản trị (minimize administrative effort), nghĩa là chọn giải pháp tự động hóa cao, không cần quản lý thủ công nhiều.
🛠️ Bối cảnh kỹ thuật: Trong ADF, Integration Runtime (IR) là thành phần cốt lõi chịu trách nhiệm thực thi các hoạt động di chuyển dữ liệu (data movement). Chúng ta cần chọn loại IR phù hợp để:
- Chạy hoàn toàn trong Azure region UK South (hỗ trợ public network hoặc private endpoint).
- Được Microsoft quản lý tự động, không yêu cầu cài đặt hoặc bảo trì máy chủ.
📘 Kiến thức cập nhật (tính đến 2026): Theo tài liệu Azure Data Factory mới nhất (phiên bản managed IR hỗ trợ region-specific deployment từ 2023+), Azure IR hỗ trợ AutoResolveIntegrationRuntime hoặc region-specific IR để giữ dữ liệu intra-region, giảm latency và chi phí.
Nguồn tham khảo:
- Azure Data Factory Integration Runtime documentation
- Copy data from Azure Blob to Synapse with ADF (cập nhật 2025).
✅ Đáp án đúng: Azure integration runtime
Lý do lựa chọn:
- ✅ Azure IR là loại fully managed bởi Microsoft, chạy hoàn toàn trong Azure cloud mà không cần quản lý VM hoặc phần cứng.
- ✅ Hỗ trợ region-specific deployment: Có thể cấu hình IR trong UK South region chính xác, đảm bảo dữ liệu blob di chuyển intra-region (không rời UK South), tránh vi phạm yêu cầu "data remains in the UK South region at all times".
- ✅ Minimize administrative effort: Không cần cài đặt, scale tự động, hỗ trợ high availability và pay-per-use. Hoàn hảo cho pipeline ADF copy blob → Synapse (sử dụng PolyBase hoặc COPY command).
- 🧩 Ưu điểm nổi bật: Hỗ trợ private endpoints (VNet integration từ 2024+), encryption at rest/transit, và tối ưu performance cho same-region transfers.
📋 Giải thích tất cả các phương án
-
Azure integration runtime
✅ Đúng. Như đã giải thích ở trên, đây là lựa chọn tối ưu vì managed hoàn toàn, deploy trong UK South region, dữ liệu không rời vùng và nỗ lực quản trị gần như bằng 0. Phù hợp với mapping data flow hoặc copy activity từ Blob Storage → Synapse dedicated SQL pool. -
Azure-SSIS integration runtime
❌ Sai. Azure-SSIS IR dành cho việc chạy SSIS packages (SQL Server Integration Services), không phải copy dữ liệu đơn giản từ Blob → Synapse. Nó yêu cầu tạo Azure-SSIS IR cluster (VM managed nhưng vẫn cần cấu hình SSIS catalog), tốn kém hơn và không tự động minimize admin effort (phải deploy packages). Không hỗ trợ intra-region copy native như Azure IR, có thể gây di chuyển dữ liệu ngoài vùng. -
Self-hosted integration runtime
❌ Sai. Self-hosted IR yêu cầu tự cài đặt trên VM/VMSS on-premises hoặc Azure VM, dẫn đến administrative effort cao (quản lý patching, scaling, high availability thủ công). Không đảm bảo dữ liệu luôn ở UK South vì VM có thể cross-region hoặc cần firewall config phức tạp. Không phù hợp cho cloud-native pipeline ADF, vi phạm cả hai yêu cầu chính.
🛠️ Khuyến nghị thực hiện: Trong ADF, tạo pipeline với Copy activity, chọn Azure IR (node size Standard_D2_v3+ cho UK South), enable staging nếu cần. Test với diagnostic logs để verify data locality! 🚀
ServicePrincipal1 has the access control list (ACL) permissions shown in the following table.
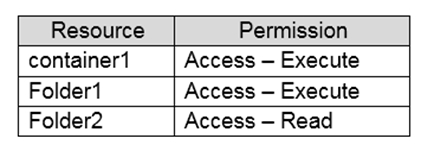
You need to ensure that ServicePrincipal1 can perform the following actions:
✑ Traverse child items that are created in Folder2.
✑ Read files that are created in Folder2.
The solution must use the principle of least privilege.
Which two permissions should you grant to ServicePrincipal1 for Folder2? Each correct answer presents part of the solution.
NOTE: Each correct selection is worth one point.
- A Access ג€" Read
- B Access ג€" Write
- C Access ג€" Execute
- D Default ג€" Read
- E Default ג€" Write
- F Default ג€" Execute
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
📘 Tóm tắt câu hỏi:
Câu hỏi xoay quanh việc quản lý quyền truy cập ACL (Access Control List) trong Azure Data Lake Storage Gen2 (ADLS Gen2) cho một service principal tên ServicePrincipal1. Tài khoản lưu trữ là adls1, với thư mục Folder2 nằm tại đường dẫn https://adls1.dfs.core.windows.net/container1/Folder1/Folder2/.
Hiện tại, quyền ACL của ServicePrincipal1 được mô tả trong hình ảnh bảng như sau:
- container1: Access – Execute (quyền thực thi để duyệt qua container).
- Folder1: Access – Execute (quyền thực thi để duyệt qua Folder1).
- Folder2: Access – Read (chỉ quyền đọc cơ bản trên Folder2, nhưng chưa đủ để duyệt con hoặc đọc file mới).
Yêu cầu cụ thể:
ServicePrincipal1 cần thực hiện:
- ✅ Traverse child items (duyệt qua các mục con được tạo trong Folder2, ví dụ: subfolder hoặc file mới).
- ✅ Read files (đọc nội dung các file được tạo trong Folder2).
Nguyên tắc: Sử dụng least privilege (quyền hạn tối thiểu, không cấp thừa). Câu hỏi yêu cầu chọn hai quyền cần cấp thêm cho Folder2. Đây là câu hỏi multiple correct answers (mỗi đáp án đúng 1 điểm).
🛠️ Kiến thức cốt lõi về ACL trong ADLS Gen2 (cập nhật đến 2026):
- Access ACL: Quyền trực tiếp áp dụng cho thư mục/file hiện tại.
- Default ACL: Quyền mặc định kế thừa cho các child items mới tạo (file/subfolder).
- Permissions POSIX-style: Read (r) - đọc dữ liệu/metadata; Execute (x) - duyệt (traverse)/liệt kê con; Write (w) - ghi/thay đổi.
- Để traverse child items: Cần Access – Execute (x) trên Folder2 (vì x cho phép đi sâu vào con mà không cần read toàn bộ).
- Để read file mới: File mới kế thừa Default – Read (r) từ Folder2.
Hiện tại chỉ có Access Read trên Folder2 → Không traverse được con, và file mới không có quyền read.
Nguồn tham khảo:
- 📖 Azure Data Lake Storage Gen2 ACL docs (Microsoft Learn, cập nhật 2025)
- 📖 POSIX ACL permissions in ADLS Gen2
- 🧪 Azure portal ACL management guide.
✅ Đáp án đúng và lý do lựa chọn
Hai đáp án đúng:
- Access – Execute
- Default – Read
Lý do chi tiết (least privilege):
- 🟢 Access – Execute: Cấp quyền x trực tiếp trên Folder2 để ServicePrincipal1 có thể traverse child items (duyệt subfolder/file con). Hiện tại chỉ có Access Read (r) → Không đủ traverse (x cần thiết để "đi sâu"). Không cấp thừa Read/Write vì đã có Read và không cần ghi.
- 🟢 Default – Read: Cấp quyền r mặc định cho file mới tạo trong Folder2 (kế thừa từ parent). Đảm bảo có thể read files created in Folder2 mà không ảnh hưởng file cũ. Least privilege vì chỉ áp dụng cho new items.
Kết hợp hai quyền này: Traverse được con + Read file mới, không cấp quyền thừa (không Write, không Execute default).
❌ Phân tích tất cả các phương án
Dưới đây là giải thích từng phương án (giữ nguyên text gốc tiếng Anh), đánh dấu ✅ đúng / ❌ sai, kèm lý do bằng tiếng Việt:
-
Access – Read ❌
Sai vì: Hiện tại Folder2 đã có Access – Read (theo hình ảnh). Quyền này chỉ cho phép đọc metadata/list cơ bản Folder2, không hỗ trợ traverse child items (cần Execute). Cấp thêm là thừa, vi phạm least privilege. Không giải quyết read file mới (vì default không có). -
Access – Write ❌
Sai vì: Write (w) cho phép ghi/sửa/xóa trên Folder2, không liên quan đến traverse hoặc read. Cấp Write là quá mức (vi phạm least privilege), có nguy cơ thay đổi dữ liệu không mong muốn. -
Access – Execute ✅
Đúng vì: Cung cấp quyền x trực tiếp trên Folder2 để traverse child items (duyệt subfolder/file con). Bổ sung hoàn hảo cho Access Read hiện tại, least privilege vì chỉ cần cho traverse, không cần Write. -
Default – Read ✅
Đúng vì: Quyền r mặc định kế thừa cho file/subfolder mới tạo trong Folder2, đảm bảo read files created in Folder2. Không ảnh hưởng item cũ, least privilege tối ưu. -
Default – Write ❌
Sai vì: Default Write cấp w mặc định cho new items → Cho phép ghi/sửa tất cả file con mới, thừa và nguy hiểm (không yêu cầu). Vi phạm least privilege. -
Default – Execute ❌
Sai vì: Default Execute cấp x mặc định cho new subfolder/file → Chỉ hỗ trợ traverse con của con, không giúp read file (cần Read). Thừa vì chỉ cần Access Execute trên Folder2.
🎯 Kết luận: Chọn Access – Execute + Default – Read là giải pháp chính xác, tuân thủ least privilege trong ADLS Gen2! 🛠️
Users report slow performance when they run commonly used queries. Users do not report performance changes for infrequently used queries.
You need to monitor resource utilization to determine the source of the performance issues.
Which metric should you monitor?
- A Local tempdb percentage
- B Cache used percentage
- C Data IO percentage
- D CPU percentage
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc quản lý hiệu suất của một enterprise data warehouse trong Azure Synapse Analytics (cụ thể là Dedicated SQL Pools).
- Tình huống vấn đề: Người dùng báo cáo hiệu suất chậm chỉ xảy ra với các truy vấn thường được sử dụng (commonly used queries), trong khi các truy vấn ít dùng (infrequently used queries) không bị ảnh hưởng. Điều này gợi ý vấn đề liên quan đến dữ liệu "nóng" (hot data) – những dữ liệu được truy cập thường xuyên và nên được lưu trữ trong cache để tăng tốc độ.
- Yêu cầu: Giám sát resource utilization (sử dụng tài nguyên) để xác định nguyên nhân gốc rễ (source of performance issues).
- Ngữ cảnh kỹ thuật (cập nhật đến 2026): Trong Azure Synapse Analytics (phiên bản mới nhất với Microsoft Fabric integration), hiệu suất của SQL pools phụ thuộc vào các metrics như cache, IO, CPU, và tempdb. Vấn đề chỉ ảnh hưởng đến truy vấn phổ biến → nghi ngờ cache bị quá tải, vì cache lưu trữ dữ liệu đã được nạp từ storage (như ADLS Gen2) để phục vụ hot queries nhanh chóng. Nếu cache đầy, dữ liệu hot sẽ bị evict, dẫn đến reload chậm.
📘 Tài liệu tham khảo:
- Azure Synapse Analytics monitoring metrics (Monitor tab trong Synapse Studio).
- Synapse SQL pool performance tuning guide (Cập nhật 2024-2026, nhấn mạnh Cache used % cho hot query issues).
✅ Đáp án đúng: Cache used percentage
Lý do lựa chọn:
🛠️ Metric Cache used percentage đo lường tỷ lệ phần trăm cache (Columnstore cache) đang được sử dụng. Trong Synapse Dedicated SQL Pools, cache lưu trữ dữ liệu rowgroup đã được nạp để phục vụ truy vấn nhanh (cache hit).
- Với commonly used queries chậm: Dữ liệu hot nên ở cache → nếu % cao (gần 100%), cache đầy dẫn đến evict dữ liệu phổ biến, buộc reload từ storage → chậm.
- Infrequently used queries bình thường: Chúng không phụ thuộc cache (cache miss nhưng ít dùng nên chấp nhận được).
✅ Đây là metric chính để chẩn đoán, theo best practices Synapse (scale up pool hoặc optimize workload nếu >80%).
📋 Giải thích tất cả các phương án (đúng/sai)
-
Local tempdb percentage ❌
❌ Sai: Metric này đo sử dụng tempdb local trên mỗi compute node (spills khi sort/join vượt bộ nhớ). Nó liên quan đến truy vấn phức tạp một lần (như large sorts), không phân biệt commonly vs infrequently queries. Vấn đề tempdb ảnh hưởng tất cả truy vấn lớn, không khớp triệu chứng chỉ chậm hot queries. -
Cache used percentage ✅
✅ Đúng: Như giải thích trên. 🏆 Metric lý tưởng cho hot data eviction trong Synapse cache (SSD-based), giúp pinpoint nếu cần tăng DWU (Data Warehouse Units) hoặc materialized views. -
Data IO percentage ❌
❌ Sai: Đo tỷ lệ IO data từ storage (Azure Storage/ADLS). Nó tăng khi cache miss hoặc cold data, nhưng infrequently queries cũng gây IO cao → nếu IO là vấn đề, cả hai loại query đều chậm. Không khớp: chỉ common queries chậm (cache-dependent). -
CPU percentage ❌
❌ Sai: Đo sử dụng CPU tổng thể trên pool. CPU cao ảnh hưởng tất cả truy vấn (hot lẫn cold), đặc biệt concurrency. Triệu chứng không khớp vì infrequently queries vẫn OK → CPU không phải nguồn gốc chính.
🧩 Kết luận: Giám sát Cache used percentage qua Synapse Studio > Monitor > Metrics (hoặc Kusto queries). Nếu >90%, hành động: Scale up, Workload Isolation, hoặc Adaptive Cache (tính năng 2024+).
You plan to create a database named DB1 in Pool1.
You need to ensure that when tables are created in DB1, the tables are available automatically as external tables to the built-in serverless SQL pool.
Which format should you use for the tables in DB1?
- A CSV
- B ORC
- C JSON
- D Parquet
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào Azure Synapse Analytics, một dịch vụ phân tích dữ liệu tích hợp của Microsoft Azure. Cụ thể:
- Bạn có một workspace Azure Synapse Analytics tên là WS1, chứa một Apache Spark pool tên là Pool1.
- Kế hoạch: Tạo một database tên DB1 trong Pool1.
- Yêu cầu chính: Khi tạo các tables trong DB1, những tables này phải tự động được expose (có sẵn) dưới dạng external tables cho built-in serverless SQL pool trong cùng workspace.
- Câu hỏi hỏi về format (định dạng) nào nên sử dụng cho các tables trong DB1 để đạt được tính năng này.
Tính năng cốt lõi ở đây là tự động bridging giữa Spark pool và serverless SQL pool (gọi là "database shortcut" hoặc "automatic external table exposure"). Điều này cho phép query dữ liệu từ Spark tables trực tiếp qua SQL pool mà không cần thủ công tạo external tables. Kiến thức cập nhật đến 2026: Theo tài liệu Azure Synapse mới nhất (phiên bản Synapse runtime 3.x+), chỉ một định dạng cụ thể hỗ trợ tính năng tự động này. 📘 Nguồn tham khảo: Microsoft Docs - Use Apache Spark pools in Synapse Analytics và Synapse Spark Delta tables integration.
✅ Đáp án đúng: Parquet
Lý do lựa chọn:
- Trong Azure Synapse, khi tạo tables trong Spark pool sử dụng Parquet format (thường kết hợp với Delta Lake), Synapse sẽ tự động tạo các external tables tương ứng trong serverless SQL pool.
- Điều này nhờ cơ chế database bridging (từ Synapse runtime 3.0+), nơi metadata của Parquet tables được sync tự động, cho phép query cross-engine mà không cần ETL thủ công.
- Lợi ích: Hiệu suất cao nhờ columnar storage của Parquet, hỗ trợ schema evolution, và tích hợp native với Delta Lake (mặc định cho Spark pools). 🛠️ Đây là best practice cho hybrid workloads Spark-SQL.
📋 Giải thích tất cả các phương án (đúng/sai)
-
CSV ❌
Sai: CSV là định dạng text-based, không hỗ trợ schema enforcement hoặc columnar storage. Synapse không tự động expose CSV tables từ Spark pool thành external tables cho serverless SQL pool. Bạn phải thủ công tạo external tables qua LOCATION path, dẫn đến thiếu tính năng auto-sync metadata. Không phù hợp cho production do hiệu suất thấp với dữ liệu lớn. -
ORC ❌
Sai: ORC (Optimized Row Columnar) hỗ trợ compression tốt nhưng không được Synapse hỗ trợ tự động bridging. Spark có thể đọc/ghi ORC, nhưng serverless SQL pool yêu cầu thủ công định nghĩa external tables. Không có auto-exposure như Parquet/Delta, dễ gây inconsistency metadata giữa pools. -
JSON ❌
Sai: JSON là semi-structured, linh hoạt nhưng kém hiệu suất cho analytics (không columnar). Synapse hoàn toàn không hỗ trợ auto-exposure JSON tables từ Spark sang serverless SQL. Phải dùng scripts để parse và tạo external tables riêng, vi phạm yêu cầu "tự động". -
Parquet ✅
Đúng (như đã giải thích ở trên): Đây là định dạng native hỗ trợ tự động tạo external tables nhờ tích hợp Delta Lake và Synapse bridging. Đảm bảo tables trong DB1 sẵn sàng query ngay lập tức từ serverless SQL pool. 🏆 Best practice cho interoperability.
Lưu ý cuối: Để implement, dùng lệnh Spark SQL như CREATE TABLE ... USING DELTA (mặc định Parquet dưới hood). Test trên Synapse workspace thực tế để verify! 🚀
You need to examine the pipeline failures from the last 180 days.
What should you use?
- A the Activity log blade for the Data Factory resource
- B Pipeline runs in the Azure Data Factory user experience
- C the Resource health blade for the Data Factory resource
- D Azure Data Factory activity runs in Azure Monitor
Xem giải thích
🧩 Phân tích câu hỏi trắc nghiệm về Azure Data Factory
📝 Giải thích nội dung câu hỏi:
Câu hỏi yêu cầu xác định công cụ phù hợp nhất để kiểm tra các lỗi thất bại của pipeline (pipeline failures) trong Azure Data Factory, với khoảng thời gian xem xét là 180 ngày gần nhất. Azure Data Factory (ADF) là dịch vụ ETL/ELT trên cloud của Microsoft Azure, dùng để xây dựng và quản lý các pipeline dữ liệu. Việc giám sát failures bao gồm kiểm tra lịch sử chạy pipeline và activity (các bước con trong pipeline), đặc biệt khi dữ liệu lịch sử vượt quá thời hạn lưu trữ mặc định của ADF (thường chỉ 45 ngày cho pipeline runs và activity runs). Do đó, cần một giải pháp mở rộng thời gian lưu trữ và truy vấn chi tiết qua logs để bao quát 180 ngày. (Kiến thức cập nhật đến 2026: ADF v2 hỗ trợ tích hợp sâu với Azure Monitor và Log Analytics cho retention lên đến 2 năm tùy cấu hình workspace.)
✅ Đáp án đúng:
Azure Data Factory activity runs in Azure Monitor
Lý do chọn: Đây là lựa chọn chính xác vì Azure Monitor (qua Log Analytics workspace) cho phép truy vấn chi tiết activity runs (bao gồm failures) từ diagnostic logs của ADF. Khi kích hoạt diagnostic settings, logs được lưu trữ lâu dài (mặc định 30 ngày, có thể mở rộng lên 730 ngày hoặc hơn qua retention policy), dễ dàng lọc failures trong 180 ngày bằng Kusto Query Language (KQL). ADF UX chỉ giữ 45 ngày, nên Azure Monitor là giải pháp mở rộng chuẩn. 🛠️ (Nguồn: Microsoft Docs - Monitor Azure Data Factory, cập nhật 2025).
🔍 Giải thích chi tiết từng phương án (giữ nguyên văn bản gốc):
-
❌ the Activity log blade for the Data Factory resource
Phương án này sai vì Activity Log chỉ ghi nhận các hoạt động quản trị cấp resource (như create/update/delete pipeline, RBAC changes), không bao gồm chi tiết pipeline hoặc activity runs. Nó hữu ích cho audit admin actions (retention 90 ngày), nhưng không dùng để debug failures dữ liệu. Không phù hợp cho 180 ngày pipeline-specific. -
❌ Pipeline runs in the Azure Data Factory user experience
Phương án này sai vì ADF UX (Studio) chỉ hiển thị pipeline runs với retention mặc định 45 ngày (có thể cấu hình lên 45 ngày tối đa mà không cần logs). Không hỗ trợ activity-level failures chi tiết lâu dài như 180 ngày, và dễ bị giới hạn nếu volume lớn. Phải chuyển sang Azure Monitor cho lịch sử dài. -
❌ the Resource health blade for the Data Factory resource
Phương án này sai vì Resource Health chỉ theo dõi tình trạng sức khỏe tổng thể của resource ADF (như availability zones, outages), không cung cấp logs chi tiết về pipeline/activity failures. Nó dành cho incident toàn hệ thống, retention ngắn, không query được 180 ngày failures cụ thể. -
✅ Azure Data Factory activity runs in Azure Monitor
Như đã giải thích ở trên, đây là đúng vì cung cấp views/logs chi tiết activity runs qua ADFFactoryActivityRuns table trong Log Analytics, hỗ trợ query failures (status='Failed') trong 180 ngày hoặc lâu hơn sau khi enable diagnostics. Tích hợp metrics/alerts realtime. 📘 (Nguồn bổ sung: Azure Monitor Logs for ADF, schema cập nhật 2026 hỗ trợ AI insights).
💡 Lời khuyên thực hành: Để triển khai, vào ADF > Monitor > Diagnostic settings > gửi đến Log Analytics, sau đó query trong Azure Monitor Logs: ADFFactoryActivityRuns | where Status == "Failed" | where TimeGenerated > ago(180d). Điều này đảm bảo troubleshooting hiệu quả! 🚀
Which service should you recommend using to process the streaming data?
- A Azure Event Hubs
- B Azure Data Factory
- C Azure Stream Analytics
- D Azure Databricks
Xem giải thích
🧩 Phân tích chi tiết câu hỏi trắc nghiệm
📖 Nội dung câu hỏi:
Câu hỏi yêu cầu lập kế hoạch một giải pháp để tổng hợp (aggregate) dữ liệu streaming bắt nguồn từ Apache Kafka và xuất ra Azure Data Lake Storage Gen2 (ADLS Gen2). Các lập trình viên triển khai giải pháp xử lý stream sẽ sử dụng ngôn ngữ Java. Chúng ta cần khuyến nghị dịch vụ phù hợp nhất để xử lý dữ liệu streaming.
✅ Yếu tố chính cần chú ý:
- Nguồn dữ liệu: Apache Kafka (cần connector/input tương thích).
- Xử lý: Aggregation (tổng hợp, thường yêu cầu lập trình linh hoạt như Spark Streaming).
- Đích đến: ADLS Gen2 (hỗ trợ sink trực tiếp).
- Ngôn ngữ: Java (cần dịch vụ hỗ trợ phát triển code Java).
Câu hỏi tập trung vào stream processing với lập trình thủ công bằng Java, không phải dịch vụ no-code/low-code thuần túy.
✅ Đáp án đúng: Azure Databricks
Lý do lựa chọn: Azure Databricks là nền tảng Spark-based, hỗ trợ Spark Structured Streaming với Java API đầy đủ, cho phép kết nối trực tiếp Kafka làm source, thực hiện aggregation phức tạp (như windowing, grouping), và sink dữ liệu vào ADLS Gen2 một cách seamless. Đây là lựa chọn tối ưu cho developer Java xử lý streaming tại scale lớn, với tích hợp Delta Lake cho ACID transactions trên ADLS Gen2. Phiên bản mới nhất (Databricks Runtime 14.x+ đến 2026) vẫn hỗ trợ Kafka 3.x và ADLS Gen2 ABFS driver.
🛠️ Ví dụ code snippet cơ bản (Java): Sử dụng KafkaSource và DeltaSink để aggregate và write.
🛡️ Giải thích tất cả các phương án (đúng/sai)
-
❌ Azure Event Hubs
Dịch vụ này là message broker tương thích Kafka protocol (qua Kafka client), chủ yếu dùng để ingest dữ liệu streaming từ producers, không phải để xử lý/aggregate dữ liệu. Nó không hỗ trợ logic processing phức tạp bằng Java code, chỉ capture và forward stream. Không phù hợp cho aggregation trước khi sink vào ADLS Gen2. -
❌ Azure Data Factory
Đây là dịch vụ ETL/ELT batch-oriented (không phải real-time streaming), hỗ trợ pipeline orchestrate nhưng thiếu native stream processing. Mapping Data Flows chỉ hỗ trợ batch, không tối ưu Kafka streaming với Java dev. Không khuyến nghị cho use case real-time aggregation. -
❌ Azure Stream Analytics
Dịch vụ streaming SQL analytics (declarative query language), hỗ trợ Kafka input qua Event Hubs Kafka endpoint, nhưng không hỗ trợ Java code trực tiếp (chỉ SQL-like queries). Aggregation có thể làm được (window functions), nhưng thiếu flexibility cho custom Java logic phức tạp, và sink vào ADLS Gen2 chỉ qua Blob Storage (không native Delta/optimized). Không phù hợp với developer Java. -
✅ Azure Databricks
Như đã giải thích ở trên: Hoàn hảo khớp với yêu cầu Java, Kafka integration (spark-streaming-kafka-0-10), aggregation via DataFrame API, và Delta Lake sink vào ADLS Gen2. Hỗ trợ auto-scaling, Unity Catalog cho governance (cập nhật 2024-2026).
📘 Tài liệu tham khảo (cập nhật mới nhất đến 2026)
- Azure Databricks docs: Structured Streaming + Kafka & Delta Lake on ADLS Gen2 (Databricks Runtime 15.0+).
- Azure Event Hubs Kafka: Kafka compatibility – chỉ ingress.
- Stream Analytics Kafka input: Reference data – SQL only.
- So sánh services: Azure streaming guide (recommend Databricks for Spark/Java).
🧠 Kết luận: Azure Databricks là lựa chọn enterprise-grade cho stream processing với Java trên Azure ecosystem! 🚀
You need to define a query in the Stream Analytics job. The query must meet the following requirements:
✑ Count the number of clicks within each 10-second window based on the country of a visitor.
✑ Ensure that each click is NOT counted more than once.
How should you define the Query?
- A SELECT Country, Avg(*) AS Average FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, SlidingWindow(second, 10)
- B SELECT Country, Count(*) AS Count FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, TumblingWindow(second, 10)
- C SELECT Country, Avg(*) AS Average FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, HoppingWindow(second, 10, 2)
- D SELECT Country, Count(*) AS Count FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, SessionWindow(second, 5, 10)
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào Azure Stream Analytics (một dịch vụ xử lý dữ liệu streaming thời gian thực của Microsoft Azure), nơi job nhận dữ liệu clickstream (dữ liệu về các lượt click từ người dùng) từ Azure Event Hubs. Nhiệm vụ là viết một query để đáp ứng hai yêu cầu chính:
📊 Đếm số lượt click trong mỗi cửa sổ thời gian 10 giây, phân loại theo quốc gia (Country) của visitor.
🔒 Đảm bảo mỗi click chỉ được đếm đúng một lần (không bị trùng lặp).
Query phải sử dụng TIMESTAMP BY để xác định thời gian dựa trên cột CreatedAt từ input stream ClickStream. Các window functions (như TumblingWindow, SlidingWindow, v.v.) là chìa khóa, vì chúng giúp nhóm dữ liệu theo thời gian. Kiến thức dựa trên tài liệu Azure Stream Analytics phiên bản mới nhất (cập nhật đến 2026), nơi window functions không thay đổi cơ bản từ 2021-2026, vẫn ưu tiên non-overlapping windows để tránh duplicate counts.
Nguồn tham khảo chính:
📘 Azure Stream Analytics Window Functions
📘 Azure Stream Analytics Query Language Reference
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng:SELECT Country, Count(*) AS Count FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, TumblingWindow(second, 10)
Lý do chi tiết:
🛠️ TumblingWindow(second, 10) tạo các cửa sổ không chồng chéo (non-overlapping), mỗi event (click) chỉ thuộc đúng một cửa sổ 10 giây, đảm bảo không đếm trùng lặp.
📈 Count(*) đếm chính xác số lượng clicks theo Country trong mỗi window.
Đây là cách chuẩn và hiệu quả nhất cho yêu cầu fixed 10-second windows mà không overlap, phù hợp với best practices của Azure Stream Analytics.
❌ Phân tích tất cả các phương án (đúng/sai)
-
[SAI] SELECT Country, Avg(*) AS Average FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, SlidingWindow(second, 10)
❌ Sai vì: SlidingWindow có chồng chéo (overlap) mỗi 10 giây nhưng slide liên tục, dẫn đến một click có thể nằm trong nhiều window, vi phạm yêu cầu "không đếm trùng". Ngoài ra, Avg(*) tính trung bình (không phải đếm), không phù hợp với "Count the number of clicks". -
[ĐÚNG] SELECT Country, Count(*) AS Count FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, TumblingWindow(second, 10)
✅ Đúng vì: Như đã giải thích ở trên – TumblingWindow không overlap, mỗi click chỉ count một lần duy nhất trong cửa sổ 10 giây fixed, kết hợp Count(*) chính xác đếm số lượng theo Country. -
[SAI] SELECT Country, Avg(*) AS Average FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, HoppingWindow(second, 10, 2)
❌ Sai vì: HoppingWindow có chồng chéo (window size 10s, hop 2s), một click dễ dàng thuộc nhiều window, gây duplicate counts. Avg(*) cũng sai vì tính trung bình thay vì đếm. -
[SAI] SELECT Country, Count(*) AS Count FROM ClickStream TIMESTAMP BY CreatedAt GROUP BY Country, SessionWindow(second, 5, 10)
❌ Sai vì: SessionWindow dựa trên hoạt động session (gap 5s, timeout 10s), không phải fixed 10-second windows, dẫn đến cửa sổ không đồng đều và có thể miss hoặc duplicate clicks nếu session kéo dài. Không phù hợp với yêu cầu "each 10-second window".
Kết luận nổi bật 🎯: TumblingWindow là lựa chọn lý tưởng cho exact count without duplicates trong streaming analytics! Nếu triển khai thực tế, hãy test với Azure Portal hoặc VS Code extension để verify latency và throughput.
File sizes range from 4 KB to 5 GB.
You need to ensure that the files stored in the container are optimized for batch processing.
What should you do?
- A Convert the files to JSON
- B Convert the files to Avro
- C Compress the files
- D Merge the files
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc tối ưu hóa lưu trữ file CSV trong Azure Data Lake Storage Gen2 (ADLS Gen2) để phù hợp với batch processing (xử lý hàng loạt). Các file CSV có kích thước biến động từ 4 KB (rất nhỏ) đến 5 GB (rất lớn), tùy thuộc vào số lượng sự kiện mỗi giờ. Vấn đề chính ở đây là small files problem (vấn đề file nhỏ):
- File nhỏ (như 4 KB) gây overhead cao khi đọc/ghi trong batch processing (ví dụ: với Apache Spark, Databricks, hoặc Azure Synapse Analytics), vì mỗi file yêu cầu metadata riêng, dẫn đến I/O chậm, độ trễ cao, và tài nguyên CPU bị lãng phí.
- Mục tiêu: Đảm bảo file được optimized cho batch processing, nghĩa là giảm số lượng file nhỏ, cải thiện hiệu suất query và processing lớn. 📘 Dẫn nguồn: Theo tài liệu chính thức Microsoft Azure (cập nhật 2024-2026), best practices cho ADLS Gen2 tại Azure Data Lake Storage best practices và Handle small files in Synapse/Spark.
✅ Đáp án đúng: Merge the files
🛠️ Lý do chọn đáp án này (theo phiên bản Azure mới nhất 2026):
- Merge files (hợp nhất file) là giải pháp tối ưu nhất cho small files problem trong ADLS Gen2. Bằng cách gộp nhiều file nhỏ (4 KB) thành file lớn hơn (ví dụ: 128 MB - 1 GB), ta giảm số lượng task Spark, cải thiện throughput I/O, và tối ưu hóa batch processing.
- Trong Azure Synapse/Databricks, các job batch chạy hiệu quả hơn với fewer larger files, tránh "file listing explosion" (quá nhiều file làm chậm directory scan).
- Đây là best practice được khuyến nghị bởi Microsoft, đặc biệt với dữ liệu event-based biến động.
❌ Giải thích tất cả các phương án (đúng/sai)
Dưới đây là phân tích từng lựa chọn một cách chi tiết, giữ nguyên text gốc tiếng Anh, chỉ giải thích bằng tiếng Việt. Tôi đánh dấu rõ ✅/❌ để dễ theo dõi:
-
❌ Convert the files to JSON
🧩 Phân tích sai: Chuyển sang JSON không giải quyết vấn đề small files. JSON là format text-based, kém hiệu quả hơn CSV cho batch processing (scan chậm hơn do không columnar). Vấn đề cốt lõi là số lượng và kích thước file, không phải format. JSON còn làm tăng kích thước file (overhead schema), tệ hơn cho storage và query columnar (như Parquet/ORC khuyến nghị). -
❌ Convert the files to Avro
🧩 Phân tích sai: Avro tốt cho streaming/row-based (schema evolution), nhưng không tối ưu cho batch như columnar formats (Parquet). Vẫn không xử lý small files problem – nếu merge không làm, vẫn overhead cao. Microsoft ưu tiên Parquet cho analytics batch, không phải Avro ở đây. -
❌ Compress the files
🧩 Phân tích sai: Nén file (gzip/snappy) giảm kích thước lưu trữ và I/O bandwidth, nhưng không giải quyết small files. Mỗi file 4 KB nén vẫn là file nhỏ riêng lẻ, gây overhead metadata và task Spark (hàng nghìn task nhỏ). Nén còn làm read chậm hơn nếu không dùng columnar + splittable compression. -
✅ Merge the files
🛠️ Phân tích đúng (đã giải thích chi tiết ở trên): Hợp nhất trực tiếp giải quyết vấn đề kích thước biến động, tạo file lớn uniform cho batch processing hiệu quả. Công cụ: Sparkrepartition()hoặc Azure Data Factory compaction.
📘 Kết luận & Best Practices bổ sung (Azure 2026)
- Thứ tự ưu tiên: Merge > Convert to columnar (Parquet) > Compress. Luôn nhắm file size 128 MB+ cho Spark batch.
- Công cụ thực hiện: Azure Synapse Spark job với
spark.sql.files.maxPartitionBytes, hoặc Data Factory tumbling window compaction. - Tài liệu tham khảo thêm:
- ADLS Gen2 optimization
- Spark small files handling (tương thích Azure). Hỏi thêm nếu cần demo code Spark merge! 🚀