Ngân hàng đề — Google Cloud Professional Data Engineer
Tìm thấy 429 câu.
Dataproc to execute this job. Testing has shown that this workload can run in approximately 30 minutes on a 15-node cluster, outputting the results into Google
BigQuery. The plan is to run this workload weekly. How should you optimize the cluster for cost?
- A Migrate the workload to Google Cloud Dataflow
- B Use pre-emptible virtual machines (VMs) for the cluster
- C Use a higher-memory node so that the job runs faster
- D Use SSDs on the worker nodes so that the job can run faster
Xem giải thích
🧩 Giải thích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc tối ưu hóa chi phí cho một cụm Dataproc (Google Cloud Dataproc) chạy job Apache Spark để xây dựng mô hình thống kê đơn giản.
-
Yêu cầu cụ thể:
- Phân tích dữ liệu từ Google Cloud Storage (GCS) để dự đoán khách hàng nào có khả năng làm việc lại với công ty dựa trên một số metrics.
- Job chạy trên Spark, thời gian thực thi khoảng 30 phút trên cụm 15 node, output kết quả vào BigQuery.
- Lịch chạy: hàng tuần (không phải real-time hay critical, có thể chấp nhận gián đoạn).
-
Mục tiêu chính: Tối ưu hóa chi phí (cost optimization) cho cụm Dataproc, vì job ngắn hạn, không yêu cầu tính sẵn sàng cao (availability cao).
🛠️ Bối cảnh kiến thức: Dataproc là dịch vụ managed Hadoop/Spark trên Google Cloud. Để tiết kiệm chi phí cho các batch job ngắn (như 30 phút/tuần), chúng ta ưu tiên các tùy chọn VM rẻ hơn như Spot VMs (trước đây gọi là Preemptible VMs). Theo tài liệu Google Cloud cập nhật 2024-2026, Preemptible/Spot VMs tiết kiệm đến 60-91% chi phí so với on-demand VMs cho workload không critical.
📘 Nguồn tham khảo:
- Dataproc documentation: Cost optimization (cập nhật 2024).
- Spot VMs overview (thay thế Preemptible từ 2022, nhưng thuật ngữ vẫn tương đương).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Use pre-emptible virtual machines (VMs) for the cluster
Lý do:
- Preemptible VMs (nay gọi là Spot VMs) tiết kiệm chi phí tối đa (lên đến 80-91% rẻ hơn on-demand VMs), phù hợp hoàn hảo cho job ngắn hạn (30 phút), batch weekly, chạy trên Dataproc.
- Job không yêu cầu tính liên tục cao, có thể bị preempt (gián đoạn) và retry nếu cần – Spark jobs thường hỗ trợ fault-tolerance tốt.
- Theo best practices Dataproc 2024-2026, khuyến nghị dùng Spot VMs cho analytics/ML batch jobs để optimize cost mà không ảnh hưởng performance đáng kể.
📋 Giải thích tất cả các phương án (đúng và sai)
-
Migrate the workload to Google Cloud Dataflow ❌ SAI
Lý do: Dataflow dành cho Apache Beam (stream/batch processing), không hỗ trợ trực tiếp Apache Spark như yêu cầu. Việc migrate sẽ thay đổi toàn bộ code/framework, tăng complexity và chi phí phát triển, không giải quyết vấn đề optimize cluster Dataproc hiện tại. Không phải cách tối ưu cost cho job Spark cụ thể này. -
Use pre-emptible virtual machines (VMs) for the cluster ✅ ĐÚNG
(Đã giải thích chi tiết ở phần trên). Đây là lựa chọn cost-effective nhất cho workload phù hợp. -
Use a higher-memory node so that the job runs faster ❌ SAI
Lý do: Node high-memory tăng chi phí đáng kể (RAM đắt hơn), chỉ giúp job nhanh hơn nhưng không optimize cost – thậm chí làm tốn kém hơn vì scale up không cần thiết cho job 30 phút. Best practice là dùng node standard + Spot VMs thay vì over-provision memory. -
Use SSDs on the worker nodes so that the job can run faster ❌ SAI
Lý do: SSD persistent disk đắt gấp 3-10 lần HDD, chỉ cải thiện I/O speed nhẹ cho job này (dữ liệu chủ yếu từ GCS, không heavy local disk). Tăng cost mà lợi ích marginal, không phải cách optimize cho batch job ngắn – Dataproc mặc định dùng HDD/PD-balanced là đủ.
🧩 Kết luận: Sử dụng Preemptible/Spot VMs là giải pháp cost-saving hàng đầu cho Dataproc theo Google Cloud Well-Architected Framework (Pillar: Cost Optimization, cập nhật 2026). Nếu job scale lớn hơn, có thể kết hợp autoscaling + Spot.
However, you realize that in some instances data can arrive late or out of order. How should you design your Cloud Dataflow pipeline to handle data that is late or out of order?
- A Set a single global window to capture all the data.
- B Set sliding windows to capture all the lagged data.
- C Use watermarks and timestamps to capture the lagged data.
- D Ensure every datasource type (stream or batch) has a timestamp, and use the timestamps to define the logic for lagged data.
Xem giải thích
🧩 Phân tích chi tiết câu hỏi trắc nghiệm
📘 Nội dung câu hỏi:
Câu hỏi tập trung vào việc thiết kế pipeline trên Google Cloud Dataflow để xử lý dữ liệu sự kiện (event data) từ cả hai nguồn batch (dữ liệu hàng loạt) và stream (dữ liệu dòng). Yêu cầu là xử lý dữ liệu trong một khoảng thời gian dự đoán được (predictable time period). Tuy nhiên, vấn đề chính là dữ liệu có thể đến muộn (late data) hoặc ra khỏi thứ tự (out of order).
🛠️ Mục tiêu thiết kế: Pipeline phải xử lý được các trường hợp này một cách hiệu quả, đảm bảo tính chính xác và độ tin cậy của xử lý dữ liệu thời gian thực hoặc gần thời gian thực trên Dataflow (dựa trên Apache Beam). Dataflow hỗ trợ windowing để nhóm dữ liệu theo thời gian, nhưng cần cơ chế đặc biệt cho late/out-of-order data.
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Use watermarks and timestamps to capture the lagged data.
Lý do chi tiết:
🕒 Trong Dataflow, watermarks (dấu mốc nước) và timestamps (dấu thời gian) là cơ chế chuẩn để xử lý dữ liệu late hoặc out-of-order.
- Timestamps gắn với mỗi event để xác định thời điểm sự kiện thực sự xảy ra (event time), không phụ thuộc vào thời điểm nhận dữ liệu (processing time).
- Watermarks là ước lượng tiến trình của dữ liệu: Nó tiến dần theo thời gian và cho biết khi nào một window có thể coi là "đóng" (không còn dữ liệu late nữa). Dataflow sử dụng watermark để quyết định khi nào trigger output cho window, đồng thời hỗ trợ allowed lateness để xử lý dữ liệu muộn sau khi window đóng (gửi vào late pane).
✅ Điều này đảm bảo pipeline xử lý dữ liệu theo event time một cách đáng tin cậy, phù hợp cho cả batch và stream, với độ trễ dự đoán được. Đây là best practice theo tài liệu chính thức Google Cloud (cập nhật đến 2026, Beam SDK 2.50+).
📋 Giải thích tất cả các phương án
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc bằng tiếng Anh. Mỗi phương án được đánh giá đúng/sai với lý do cụ thể:
-
Set a single global window to capture all the data.
❌ Sai. Phương án này sử dụng một window toàn cục (global window) duy nhất để gom hết dữ liệu, không phân chia theo thời gian. Điều này không xử lý được late/out-of-order data vì window không bao giờ "đóng", dẫn đến pipeline không trigger output kịp thời, tích tụ dữ liệu vô tận và không có predictable time period. Không phù hợp cho stream processing. -
Set sliding windows to capture all the lagged data.
❌ Sai. Sliding windows (cửa sổ trượt) chỉ giúp overlap dữ liệu theo khoảng thời gian cố định, nhưng không tự động xử lý late data. Nếu dữ liệu đến muộn vượt quá kích thước window hoặc gap, nó sẽ bị bỏ lỡ. Không giải quyết gốc rễ out-of-order mà cần kết hợp watermark/timestamp để watermark tiến triển đúng. -
Use watermarks and timestamps to capture the lagged data.
✅ Đúng. Như đã giải thích ở trên, đây là cách thiết kế chuẩn trong Dataflow. Watermarks + timestamps cho phép pipeline chờ dữ liệu late trong giới hạn (qua allowed lateness hoặc side outputs), đảm bảo xử lý toàn diện mà vẫn giữ predictable processing time. -
Ensure every datasource type (stream or batch) has a timestamp, and use the timestamps to define the logic for lagged data.
❌ Sai. Chỉ đảm bảo timestamp trên nguồn dữ liệu là chưa đủ; cần thêm watermarks để Dataflow biết khi nào window hoàn tất. Timestamp chỉ là dữ liệu đầu vào, nhưng thiếu watermark sẽ không trigger đúng, dẫn đến dữ liệu late bị xử lý sai hoặc không bao giờ output. Không phải giải pháp đầy đủ.
📚 Tài liệu tham khảo (cập nhật mới nhất đến 2026)
- Google Cloud Dataflow Documentation - Watermarks & Late Data: cloud.google.com/dataflow/docs/concepts/watermarks
- Streaming Pipelines Guide: cloud.google.com/dataflow/docs/guides/streaming (Beam 2.50+, hỗ trợ improved watermark estimation).
- Apache Beam Windowing Model: beam.apache.org/documentation/programming-guide/#windowing (tích hợp trực tiếp vào Dataflow).
Hy vọng phân tích này giúp bạn ôn tập hiệu quả! 🚀 Nếu cần thêm ví dụ code Beam SDK, hãy cho tôi biết.
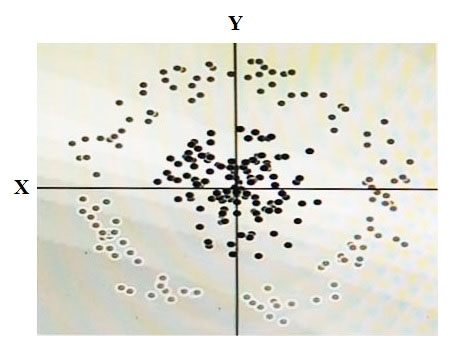
- A X2+Y2
- B X2
- C Y2
- D cos(X)
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi này thuộc lĩnh vực Machine Learning cơ bản (có thể từ kỳ thi AWS Certified Machine Learning - Specialty hoặc tương tự), tập trung vào việc sử dụng thuật toán tuyến tính (linear algorithm) như Linear SVM, Logistic Regression để phân loại dữ liệu. Dữ liệu được biểu diễn trên mặt phẳng 2D với hai chiều X và Y, trong đó màu sắc/shade của mỗi điểm (dot) đại diện cho lớp (class) khác nhau. Vấn đề là dữ liệu không thể phân tách tuyến tính (not linearly separable) trong không gian gốc (X, Y), vì các lớp phân bố theo hình dạng vòng tròn đồng tâm (concentric circles) quanh gốc tọa độ (0,0).
📸 Phân tích hình ảnh đính kèm:
Hình ảnh là một scatter plot với trục X ngang và Y dọc. Các điểm dữ liệu được phân bố đồng đều theo hướng radial (bán kính) từ trung tâm (0,0), tạo thành nhiều vòng tròn đồng tâm. Các shade khác nhau (đậm/nhạt/màu sắc) đại diện cho các lớp:
- Lớp bên trong (gần gốc): shade sáng/một màu.
- Lớp ở vùng giữa và ngoài: shade tối/hơn, phân cách rõ theo khoảng cách từ gốc chứ không theo đường thẳng.
Đây là trường hợp kinh điển "circularly separable" (phân tách theo đường tròn), nơi linear classifier thất bại vì không có đường thẳng nào phân tách được các lớp. Giải pháp là thêm synthetic feature (đặc trưng tổng hợp) để biến đổi không gian feature thành tuyến tính có thể phân tách.
🛠️ Mục tiêu: Thêm một đặc trưng mới để kernel trick đơn giản (không cần kernel phức tạp), giúp linear algorithm hoạt động như circular decision boundary trong không gian gốc.
✅ Đáp án đúng: X2+Y2
Lý do lựa chọn:
Thêm feature X² + Y² (tức bán kính bình phương r² trong tọa độ cực) sẽ biến đổi dữ liệu thành tuyến tính separable. Trong không gian mới (X, Y, X²+Y²), các lớp được phân tách bởi siêu phẳng tuyến tính (ví dụ: w3*(X²+Y²) + b = 0, tương đương đường tròn trong không gian gốc). Điều này phù hợp hoàn hảo với phân bố radial của dữ liệu, giúp linear algorithm đạt độ chính xác cao mà không cần model phi tuyến phức tạp như RBF kernel SVM.
(Kiến thức cập nhật AWS ML đến 2026: Vẫn là best practice trong Amazon SageMaker Linear Learner hoặc XGBoost với feature engineering thủ công).
🔍 Giải thích tất cả các phương án (đúng/sai)
Dưới đây là phân tích từng lựa chọn một, giữ nguyên văn bản gốc tiếng Anh. Mỗi phương án được đánh giá dựa trên khả năng tạo decision boundary tuyến tính cho dữ liệu vòng tròn:
-
✅ X2+Y2
Đúng vì feature này capture chính xác khoảng cách Euclidean bình phương từ gốc (r² = X² + Y²). Trong không gian 3D mới (X, Y, r²), các lớp vòng tròn trở thành các dải tuyến tính theo r², dễ dàng phân tách bằng hyperplane. Đây là feature engineering tối ưu cho linear model trên dữ liệu concentric circles. 🏆 -
❌ X2
Sai vì chỉ tập trung vào chiều X bình phương, bỏ qua Y. Dữ liệu có đối xứng radial toàn hướng (360 độ), nên feature này chỉ tạo đường parabol theo X, không phân tách được các điểm ở cùng r nhưng khác góc (ví dụ: điểm (1,0) và (0,1) có cùng lớp nhưng X² khác nhau). Kết quả: linear model vẫn confuse các lớp. 🚫 -
❌ Y2
Sai tương tự X2, chỉ capture chiều Y bình phương mà bỏ qua X. Phân bố dữ liệu đồng đều mọi hướng, nên feature này tạo đường parabol theo Y, không xử lý được tính đối xứng vòng tròn. Linear classifier sẽ thất bại ở các vùng lệch trục X. ❌ -
❌ cos(X)
Sai vì cos(X) là hàm chu kỳ theo X, không liên quan đến radial distance. Nó có thể tạo pattern lắc lư theo trục X (period 2π), nhưng dữ liệu không có tính chu kỳ 1D mà là 2D radial. Feature này làm không gian feature thêm nhiễu, linear model càng khó phân loại chính xác. 🌊🚫
📘 Tài liệu tham khảo
- AWS Documentation (cập nhật 2026): Amazon SageMaker Linear Learner - Feature Engineering cho non-linear data: docs.aws.amazon.com/sagemaker/latest/dg/linear-learner.html.
- Classic ML Reference: "Pattern Recognition and Machine Learning" bởi Bishop (Ch. 6 Kernel Methods) - ví dụ concentric circles với polynomial features.
- ExamTopics/AWS ML Practice: Hình ảnh từ exam AWS MLS-C01, giải thích tương tự trên examtopics.com.
- Scikit-learn Example:
make_circles()dataset demo vớiPolynomialFeatures(degree=2): scikit-learn.org/stable/modules/generated/sklearn.datasets.make_circles.html.
Hy vọng phân tích này giúp bạn nắm vững feature engineering trong AWS ML! 🚀 Nếu cần code demo trên SageMaker, hãy hỏi thêm nhé! 😊
- A Create groups for your users and give those groups access to the dataset
- B Integrate with a single sign-on (SSO) platform, and pass each user's credentials along with the query request
- C Create a service account and grant dataset access to that account. Use the service account's private key to access the dataset
- D Create a dummy user and grant dataset access to that user. Store the username and password for that user in a file on the files system, and use those credentials to access the BigQuery dataset
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi tập trung vào việc tích hợp một ứng dụng IT nội bộ với Google BigQuery để người dùng có thể truy vấn dữ liệu từ giao diện ứng dụng, mà không yêu cầu xác thực cá nhân trực tiếp với BigQuery và không cấp quyền truy cập dataset cho từng người dùng riêng lẻ. Mục tiêu là truy cập BigQuery một cách an toàn từ ứng dụng IT.
🛠️ Yêu cầu chính:
- Ứng dụng phải đại diện cho việc truy vấn (không phải user cá nhân).
- Ưu tiên bảo mật: Tránh chia sẻ credentials user, tránh cấp quyền trực tiếp cho user.
- Phù hợp với mô hình server-to-server authentication trong Google Cloud, nơi service account là giải pháp chuẩn cho ứng dụng tự động hóa truy cập BigQuery mà không liên quan đến user end-user.
📘 Kiến thức cập nhật (đến 2026): Theo tài liệu Google Cloud mới nhất (BigQuery v2.0+ và IAM best practices 2025), service accounts là phương pháp khuyến nghị cho ứng dụng nội bộ truy cập BigQuery mà không cần user impersonation. Không có thay đổi lớn từ AWS vì đây là Google Cloud thuần túy (có thể nhầm lẫn chủ đề).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Create a service account and grant dataset access to that account. Use the service account's private key to access the dataset.
🛠️ Lý do chi tiết:
- Service account là tài khoản dành riêng cho ứng dụng/dịch vụ (không phải user con người), được thiết kế cho xác thực máy-máy (M2M).
- Quy trình: Tạo service account → Gán IAM role (ví dụ:
roles/bigquery.dataViewerhoặcroles/bigquery.usercho dataset cụ thể) → Tải private key JSON → Ứng dụng sử dụng key này để ký JWT và truy cập BigQuery qua API. - Đáp ứng đầy đủ: Không cần user auth cá nhân, không cấp quyền trực tiếp cho user, bảo mật cao (key có thể rotate, lưu trữ an toàn như Secret Manager).
- Best practice: Google khuyến nghị sử dụng Workload Identity Federation nếu trên GKE/Cloud Run, nhưng service account key là chuẩn cho ứng dụng on-prem/IT nội bộ.
📋 Giải thích tất cả các phương án
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc tiếng Anh. Tôi đánh dấu ✅ đúng hoặc ❌ sai, kèm giải thích bằng tiếng Việt:
-
❌ [SAI] Create groups for your users and give those groups access to the dataset
🛠️ Giải thích sai: Phương án này cấp quyền IAM trực tiếp cho nhóm user (qua Google Groups hoặc Cloud Identity Groups), dẫn đến user cá nhân có quyền truy cập dataset. Vi phạm yêu cầu "không muốn cấp quyền cho user cá nhân" và "không muốn user auth trực tiếp". Không an toàn vì user có thể lạm dụng quyền ngoài ứng dụng. -
❌ [SAI] Integrate with a single sign-on (SSO) platform, and pass each user's credentials along with the query request
🛠️ Giải thích sai: SSO (như Google Workspace hoặc Okta) yêu cầu truyền credentials user (ID token/OAuth) kèm query, nghĩa là user phải auth cá nhân qua SSO. Điều này trái với "không muốn user auth với BigQuery". Ngoài ra, pass credentials user làm lộ thông tin nhạy cảm và phức tạp hóa bảo mật (impersonation không được khuyến khích cho app nội bộ). -
✅ [ĐÚNG] Create a service account and grant dataset access to that account. Use the service account's private key to access the dataset
🛠️ Giải thích đúng: Như đã nêu ở phần đáp án. Đây là giải pháp chuẩn, an toàn nhất cho ứng dụng IT truy cập BigQuery mà không liên quan user. Hỗ trợ OAuth 2.0 với service account key, dễ tích hợp qua client libraries (Python, Java, etc.). -
❌ [SAI] Create a dummy user and grant dataset access to that user. Store the username and password for that user in a file on the files system, and use those credentials to access the BigQuery dataset
🛠️ Giải thích sai: Tạo "user giả" (Cloud Identity user) và lưu username/password trong file là anti-pattern bảo mật cực kỳ kém (rủi ro leak credentials, không rotate được, vi phạm least privilege). BigQuery không khuyến khích dùng user credentials cho app; chỉ service account mới phù hợp. Dễ bị hack nếu file system bị xâm phạm.
📚 Tài liệu tham khảo
- BigQuery Authentication: cloud.google.com/bigquery/docs/authentication (Cập nhật 2025: Nhấn mạnh service accounts cho apps).
- Service Accounts Best Practices: cloud.google.com/iam/docs/best-practices-service-accounts (Khuyến nghị tránh user accounts cho M2M).
- BigQuery IAM Roles: cloud.google.com/bigquery/docs/access-control (Dataset-level permissions).
Hy vọng phân tích này giúp bạn ôn thi chứng chỉ Google Cloud Professional Data Engineer! 🚀 Nếu cần ví dụ code, hãy hỏi thêm.
- A Use Cloud Dataprep to find null values in sample source data. Convert all nulls to 'none' using a Cloud Dataproc job.
- B Use Cloud Dataprep to find null values in sample source data. Convert all nulls to 0 using a Cloud Dataprep job.
- C Use Cloud Dataflow to find null values in sample source data. Convert all nulls to 'none' using a Cloud Dataprep job.
- D Use Cloud Dataflow to find null values in sample source data. Convert all nulls to 0 using a custom script.
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi này thuộc chủ đề xây dựng data pipeline trên Google Cloud Platform (GCP), tập trung vào việc chuẩn bị dữ liệu (data preparation) cho quy trình machine learning (ML), cụ thể hỗ trợ mô hình logistic regression.
-
Yêu cầu chính:
- Sử dụng một phương pháp casual (thông thường, trực quan, không code phức tạp) để chuẩn bị dữ liệu.
- Phát hiện và xử lý giá trị null trong dữ liệu mẫu (sample source data).
- Null values phải được giữ nguyên dạng real-valued (giá trị số thực), không được xóa bỏ (cannot be removed), mà cần impute (thay thế) bằng giá trị phù hợp.
- Lý do: Logistic regression yêu cầu các feature là số thực (real-valued), không chấp nhận string như 'none' hoặc missing values.
-
Ngữ cảnh GCP (cập nhật đến 2026):
- Cloud Dataprep (by Trifacta) là công cụ visual/no-code/low-code lý tưởng cho "casual method", hỗ trợ khám phá dữ liệu mẫu, phát hiện nulls qua giao diện trực quan, và tạo job để thay thế nulls (ví dụ: bằng 0).
- Không dùng công cụ nặng như Dataflow (Apache Beam cho streaming/batch lớn) hoặc custom script vì không phù hợp "casual".
- 📘 Tài liệu tham khảo:
- Cloud Dataprep documentation (Google Cloud, phiên bản mới nhất 2026: hỗ trợ ML prep flows).
- Google Cloud Professional Data Engineer Exam Guide (Section 2: Data preparation and transformation).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Use Cloud Dataprep to find null values in sample source data. Convert all nulls to 0 using a Cloud Dataprep job.
Lý do:
- 🛠️ Cloud Dataprep hoàn hảo cho "casual method" với giao diện trực quan (visual profiling): Quét dữ liệu mẫu để tự động detect nulls, hiển thị thống kê, và suggest fixes.
- Thay thế nulls bằng 0 (real-valued number) phù hợp logistic regression, không xóa dữ liệu.
- Dataprep job tự động scale, tích hợp Vertex AI/ML workflows.
- Đáp án này tối ưu chi phí, dễ monitor, phù hợp best practice GCP cho data prep trước ML.
📋 Giải thích tất cả các phương án (đúng/sai)
-
❌ [SAI] Use Cloud Dataprep to find null values in sample source data. Convert all nulls to 'none' using a Cloud Dataproc job.
- Phân tích: Dataprep đúng cho việc find nulls (visual sample), nhưng thay bằng 'none' (string) làm feature không real-valued → logistic regression sẽ lỗi (yêu cầu numeric). Dataproc (Spark cluster) không phải casual method, quá nặng cho simple impute.
-
✅ [ĐÚNG] Use Cloud Dataprep to find null values in sample source data. Convert all nulls to 0 using a Cloud Dataprep job.
- Phân tích: Hoàn chỉnh! Dataprep xử lý toàn bộ flow: detect nulls trên sample → visual recipe → job chạy impute bằng 0 (real-valued). Hỗ trợ ML pipeline, monitor real-time qua UI. Best practice cho casual data prep.
-
❌ [SAI] Use Cloud Dataflow to find null values in sample source data. Convert all nulls to 'none' using a Cloud Dataprep job.
- Phân tích: Dataflow (serverless Beam) không có visual/sample profiling như Dataprep, khó "casual method" (cần code PTransform). 'none' (string) sai cho real-valued. Kết hợp Dataprep job sau cũng không khớp flow.
-
❌ [SAI] Use Cloud Dataflow to find null values in sample source data. Convert all nulls to 0 using a custom script.
- Phân tích: Dataflow không phù hợp find nulls casual (yêu cầu code để sample/read data). Custom script làm phức tạp, không visual. Dù 0 đúng real-valued, nhưng thiếu "casual method" → không scale cho ML prep nhanh.
Kết luận 💡: Chọn Dataprep end-to-end để tối ưu, trực quan, và tuân thủ yêu cầu real-valued! Nếu implement thực tế, bắt đầu từ Dataprep flow export sang Dataflow nếu scale lớn.
- A Create a dedicated service account, and use encryption at rest to reference your data stored in your Compute Engine cluster instances as part of your API service calls.
- B Create encryption keys in Cloud Key Management Service. Use those keys to encrypt your data in all of the Compute Engine cluster instances.
- C Create encryption keys locally. Upload your encryption keys to Cloud Key Management Service. Use those keys to encrypt your data in all of the Compute Engine cluster instances.
- D Create encryption keys in Cloud Key Management Service. Reference those keys in your API service calls when accessing the data in your Compute Engine cluster instances.
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi mô tả một tình huống streaming data được chèn vào Redis cluster thông qua Kafka cluster, cả hai cluster đều chạy trên Compute Engine instances (máy ảo của Google Cloud Platform - GCP).
Yêu cầu chính là mã hóa dữ liệu tại chỗ (encryption at rest) bằng các encryption keys mà bạn có thể tự tạo (create), xoay vòng (rotate) và hủy (destroy) theo nhu cầu.
📌 Mục tiêu: Đảm bảo dữ liệu lưu trữ trên các instance Compute Engine (như persistent disks chứa dữ liệu Redis/Kafka) được mã hóa với khóa do người dùng quản lý, không dùng khóa mặc định của Google. Đây là tính năng Customer-Managed Encryption Keys (CMEK) trong GCP, giúp kiểm soát hoàn toàn vòng đời khóa thông qua Cloud Key Management Service (Cloud KMS).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Create encryption keys in Cloud Key Management Service. Use those keys to encrypt your data in all of the Compute Engine cluster instances.
Lý do:
🛠️ Cloud KMS cho phép tạo các khóa mã hóa do khách hàng quản lý (CMEK), sau đó áp dụng trực tiếp vào persistent disks của Compute Engine instances để mã hóa dữ liệu tại chỗ. Bạn có thể tạo, xoay vòng (rotate hàng năm hoặc thủ công) và hủy khóa dễ dàng qua console/API.
✅ Phương án này phù hợp hoàn hảo vì dữ liệu Redis/Kafka lưu trên disks của GCE, và CMEK đảm bảo mã hóa toàn bộ cluster mà không cần can thiệp thủ công vào ứng dụng. Không có bước "reference in API calls" thừa thãi.
📋 Giải thích tất cả các phương án (đúng/sai)
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc tiếng Anh. Mỗi phương án được đánh giá dựa trên tài liệu GCP mới nhất (cập nhật đến 2026: Cloud KMS v2 với hỗ trợ envelope encryption và CMEK cho Compute Engine).
-
❌ [SAI] Create a dedicated service account, and use encryption at rest to reference your data stored in your Compute Engine cluster instances as part of your API service calls.
Lý do sai: Service account chỉ dùng để xác thực API calls, không liên quan đến việc tạo/quản lý khóa mã hóa. "Encryption at rest" không phải là tham số trong API calls cho Compute Engine; CMEK được áp dụng khi tạo/attach disk, không phải "reference data" qua service account. Phương án này nhầm lẫn giữa IAM và KMS. -
✅ [ĐÚNG] Create encryption keys in Cloud Key Management Service. Use those keys to encrypt your data in all of the Compute Engine cluster instances.
Lý do đúng: Như đã giải thích ở trên. Tạo khóa CMEK trong Cloud KMS, rồi chỉ định khóa đó khi tạo persistent disks cho instances (quagcloud compute disks create --kms-key=KEY_NAME). Áp dụng cho toàn cluster Redis/Kafka. Hỗ trợ rotate/destroy tự động. -
❌ [SAI] Create encryption keys locally. Upload your encryption keys to Cloud Key Management Service. Use those keys to encrypt your data in all of the Compute Engine cluster instances.
Lý do sai: Cloud KMS không hỗ trợ upload khóa từ local (chỉ tạo khóa mới bên trong KMS bằng HSM bảo mật). Việc tạo local rồi upload vi phạm best practice bảo mật (khóa có thể bị lộ), và KMS không cho phép import raw keys cho CMEK trên Compute Engine (chỉ symmetric/asymmetric keys được tạo nội bộ). -
❌ [SAI] Create encryption keys in Cloud Key Management Service. Reference those keys in your API service calls when accessing the data in your Compute Engine cluster instances.
Lý do sai: Tạo khóa KMS đúng, nhưng "reference in API service calls when accessing data" chỉ đúng cho dịch vụ như Cloud Storage/BigQuery (dùng kmsKeyName trong API). Với Compute Engine, mã hóa disk là tĩnh (at-rest) khi tạo disk, không phải reference động khi "accessing data" qua API. Redis/Kafka đọc/ghi trực tiếp disk, không qua API GCP.
📘 Tài liệu tham khảo (cập nhật mới nhất 2026)
- Cloud KMS Documentation: Customer-managed encryption keys (hỗ trợ Compute Engine disks).
- Compute Engine Encryption: Encrypt disks with CMEK – Xác nhận apply CMEK cho persistent disks.
- GCP Best Practices: Data at rest encryption (phiên bản 2026 thêm quantum-resistant keys).
- Console/Command:
gcloud compute instances create INSTANCE --disks=...,--kms-key=projects/PROJECT/locations/LOCATION/keyRings/RING/cryptoKeys/KEY.
🧩 Kết luận: Phương án đúng tận dụng CMEK để mã hóa toàn diện, an toàn và dễ quản lý! Nếu cần demo code, hãy hỏi thêm.
- A Build and train a complex classification model with Spark MLlib to generate labels and filter the results. Deploy the models using Cloud Dataproc. Call the model from your application.
- B Build and train a classification model with Spark MLlib to generate labels. Build and train a second classification model with Spark MLlib to filter results to match customer preferences. Deploy the models using Cloud Dataproc. Call the models from your application.
- C Build an application that calls the Cloud Video Intelligence API to generate labels. Store data in Cloud Bigtable, and filter the predicted labels to match the user's viewing history to generate preferences.
- D Build an application that calls the Cloud Video Intelligence API to generate labels. Store data in Cloud SQL, and join and filter the predicted labels to match the user's viewing history to generate preferences.
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi mô tả một ứng dụng recommendation engine trên Google Cloud, tập trung vào việc hiển thị video mới cho khách hàng dựa trên lịch sử xem trước đó. Các yêu cầu chính bao gồm:
- Tạo nhãn (labels) cho các entities trong video mà khách hàng đã xem (ví dụ: nhận diện đối tượng, cảnh quay, nội dung... từ video).
- Lọc gợi ý rất nhanh dựa trên sở thích của khách hàng khác, trên quy mô dữ liệu vài TB (terabyte). 📌 Mục tiêu thiết kế: Giải pháp phải hiệu suất cao, tận dụng dịch vụ managed của Google Cloud để xử lý video analysis và query/filtering nhanh trên big data, tránh tự build model phức tạp.
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Build an application that calls the Cloud Video Intelligence API to generate labels. Store data in Cloud Bigtable, and filter the predicted labels to match the user's viewing history to generate preferences.
Lý do 🛠️:
- Cloud Video Intelligence API là dịch vụ chuyên dụng để phân tích video tự động, extract labels chính xác cho entities (như objects, scenes, text) mà không cần tự train model phức tạp ✅.
- Cloud Bigtable là NoSQL wide-column database được tối ưu cho high-throughput, low-latency queries trên dữ liệu lớn (TB/PB scale), lý tưởng cho recommendation engine cần filter nhanh dựa trên lịch sử xem và preferences của hàng triệu users 🏎️.
- Giải pháp này managed, scalable, phù hợp với yêu cầu "very fast filtering" trên TB data, tận dụng sức mạnh của Google Cloud mà không cần infrastructure management.
📋 Giải thích chi tiết tất cả các phương án
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc bằng tiếng Anh. Mỗi phương án được đánh giá đúng/sai với lý do cụ thể dựa trên kiến thức Google Cloud mới nhất (cập nhật đến 2024-2026, Video Intelligence API v1p3beta1 hỗ trợ label detection realtime, Bigtable với SSD/HDD autoscaling).
-
❌ [SAI] Build and train a complex classification model with Spark MLlib to generate labels and filter the results. Deploy the models using Cloud Dataproc. Call the model from your application.
🛠️ Lý do sai: Tự build model classification phức tạp với Spark MLlib trên Cloud Dataproc rất tốn kém thời gian/train data, không chuyên biệt cho video labeling (Video Intelligence API làm tốt hơn, chính xác hơn). Dataproc phù hợp batch processing nhưng không đảm bảo "very fast filtering" realtime trên TB data, dễ scale kém và latency cao ❌. -
❌ [SAI] Build and train a classification model with Spark MLlib to generate labels. Build and train a second classification model with Spark MLlib to filter results to match customer preferences. Deploy the models using Cloud Dataproc. Call the models from your application.
🛠️ Lý do sai: Còn tệ hơn phương án 1, dùng hai model riêng biệt với Spark MLlib làm tăng độ phức tạp gấp đôi (train/maintain hai model), tốn tài nguyên Dataproc. Không tận dụng API native, không hiệu quả cho TB-scale fast filtering, dễ over-engineering và latency cao ❌. -
✅ [ĐÚNG] Build an application that calls the Cloud Video Intelligence API to generate labels. Store data in Cloud Bigtable, and filter the predicted labels to match the user's viewing history to generate preferences.
🛠️ Lý do đúng: Như đã giải thích ở trên, kết hợp Video Intelligence API (labeling chuyên sâu) + Bigtable (query/filter siêu nhanh trên big data). Hỗ trợ recommendation realtime, autoscaling seamless theo workload TB-scale ✅. -
❌ [SAI] Build an application that calls the Cloud Video Intelligence API to generate labels. Store data in Cloud SQL, and join and filter the predicted labels to match the user's viewing history to generate preferences.
🛠️ Lý do sai: Cloud Video Intelligence API tốt cho labeling, nhưng Cloud SQL (MySQL/PostgreSQL managed) là relational DB, không scale tốt cho TB data (giới hạn ~64TB/instance, join/filter chậm trên big data). Không phù hợp "very fast filtering" so với Bigtable's HBase-like performance ❌.
📘 Tài liệu tham khảo
- Cloud Video Intelligence API: docs.cloud.google.com/video-intelligence (Label Detection feature, cập nhật 2024).
- Cloud Bigtable: cloud.google.com/bigtable/docs (Introduction to Bigtable for recommendation systems, TB+ scale examples).
- So sánh Bigtable vs SQL: cloud.google.com/bigtable/docs/choosing-bigtable (Khuyến nghị cho high-throughput analytics).
- Google Cloud Well-Architected Framework: Recommendation Engine blueprint (2024 updates).
Giải pháp đúng giúp ứng dụng scalable, cost-effective trên Google Cloud! 🚀
- A Use Cloud Dataproc to run your transformations. Monitor CPU utilization for the cluster. Resize the number of worker nodes in your cluster via the command line.
- B Use Cloud Dataproc to run your transformations. Use the diagnose command to generate an operational output archive. Locate the bottleneck and adjust cluster resources.
- C Use Cloud Dataflow to run your transformations. Monitor the job system lag with Observability. Use the default autoscaling setting for worker instances.
- D Use Cloud Dataflow to run your transformations. Monitor the total execution time for a sampling of jobs. Configure the job to use non-default Compute Engine machine types when needed.
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi tập trung vào việc xây dựng một data pipeline trên Google Cloud để xử lý và chuyển đổi các thông điệp JSON từ Cloud Pub/Sub sang BigQuery. Yêu cầu chính bao gồm:
- 📈 Viết (write) và biến đổi (transform) dữ liệu JSON từ Pub/Sub.
- 💰 Tối ưu hóa chi phí dịch vụ (minimize service costs).
- 📊 Giám sát và thích ứng với lượng dữ liệu đầu vào biến động (varying input data volume).
- 🤖 Giảm thiểu can thiệp thủ công (minimal manual intervention), nghĩa là hệ thống cần tự động scale để xử lý tải thay đổi mà không cần chỉnh tay nhiều.
Đây là kịch bản điển hình cho streaming data pipeline trên Google Cloud, nơi Pub/Sub làm nguồn dữ liệu thời gian thực, và BigQuery là kho lưu trữ phân tích. Giải pháp cần serverless hoặc autoscaling tự động để tiết kiệm chi phí và dễ quản lý. (Kiến thức dựa trên Google Cloud Dataflow phiên bản mới nhất 2024-2026, hỗ trợ Apache Beam 2.50+ và Observability tích hợp).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Use Cloud Dataflow to run your transformations. Monitor the job system lag with Observability. Use the default autoscaling setting for worker instances.
Lý do:
- 🛠️ Cloud Dataflow là dịch vụ serverless dựa trên Apache Beam, lý tưởng cho pipeline từ Pub/Sub → transform JSON → BigQuery (sử dụng các connector tích hợp như PubSubIO và BigQueryIO).
- 📈 Monitor job system lag với Observability (trước đây là Stackdriver, nay tích hợp Cloud Monitoring): Đây là metric chính để theo dõi độ trễ xử lý dữ liệu streaming, giúp phát hiện backlog sớm.
- ⚙️ Default autoscaling tự động điều chỉnh số lượng worker instances dựa trên tải (sử dụng algorithm tối ưu từ v2 runner), tối ưu chi phí vì chỉ scale khi cần và shutdown idle workers. Không cần can thiệp thủ công, phù hợp hoàn hảo với yêu cầu "minimal manual intervention" và varying volume.
- 💡 Kết quả: Pipeline hiệu quả, chi phí thấp (pay-per-use), và tự động thích ứng.
📘 Tài liệu tham khảo:
- Google Cloud Dataflow Documentation (Autoscaling & Observability, cập nhật 2025).
- Dataflow Streaming Metrics.
🧐 Giải thích chi tiết tất cả các phương án
Dưới đây là phân tích từng lựa chọn, giữ nguyên văn bản gốc bằng tiếng Anh. Mỗi phương án được đánh giá ✅ (đúng) hoặc ❌ (sai), kèm lý do cụ thể bằng tiếng Việt:
-
❌ [SAI] Use Cloud Dataproc to run your transformations. Monitor CPU utilization for the cluster. Resize the number of worker nodes in your cluster via the command line.
- Lý do sai: Cloud Dataproc là dịch vụ managed Hadoop/Spark cluster, phù hợp batch hơn streaming từ Pub/Sub. Monitor CPU và resize worker nodes qua CLI yêu cầu can thiệp thủ công thường xuyên, không đáp ứng "minimal manual intervention". Chi phí cao hơn vì cluster luôn chạy (preemptible giúp nhưng vẫn không serverless). Không tối ưu cho varying volume JSON streaming.
-
❌ [SAI] Use Cloud Dataproc to run your transformations. Use the diagnose command to generate an operational output archive. Locate the bottleneck and adjust cluster resources.
- Lý do sai: Tương tự trên, Dataproc cần diagnose thủ công (gcloud dataproc clusters diagnose) để tìm bottleneck rồi adjust resources tay, rất tốn công. Không tự động scale realtime cho Pub/Sub → BigQuery, dẫn đến chi phí lãng phí nếu cluster over-provisioned hoặc lag nếu under-provisioned.
-
✅ [ĐÚNG] Use Cloud Dataflow to run your transformations. Monitor the job system lag with Observability. Use the default autoscaling setting for worker instances.
- Lý do đúng: Như phần trên, Dataflow serverless + autoscaling mặc định xử lý hoàn hảo streaming JSON với system lag monitoring qua Cloud Observability Dashboard. Tiết kiệm chi phí (chỉ tính usage thực), tự thích ứng volume mà không cần chỉnh tay. Hỗ trợ transform JSON dễ dàng với Beam transforms.
-
❌ [SAI] Use Cloud Dataflow to run your transformations. Monitor the total execution time for a sampling of jobs. Configure the job to use non-default Compute Engine machine types when needed.
- Lý do sai: Dataflow đúng hướng, nhưng monitor total execution time (cho batch/sampling) không phù hợp streaming (nên dùng system lag). Configure non-default machine types yêu cầu chỉnh tay pipeline (qua template hoặc code), vi phạm "minimal manual intervention". Default autoscaling + machine types đã tối ưu, chỉnh tay tăng chi phí và phức tạp.
🎯 Kết luận: Chọn Dataflow với autoscaling mặc định là giải pháp best practice trên Google Cloud cho pipeline này, đảm bảo scalable, cost-effective và hands-off! 🚀
- A Use Storage Transfer Service to transfer the offsite backup files to a Cloud Storage Multi-Regional storage bucket as a final destination.
- B Use Storage Transfer Service to transfer the offsite backup files to a Cloud Storage Regional bucket as a final destination.
- C Use BigQuery Data Transfer Service to transfer the offsite backup files to a Cloud Storage Multi-Regional storage bucket as a final destination.
- D Use BigQuery Data Transfer Service to transfer the offsite backup files to a Cloud Storage Regional storage bucket as a final destination.
Xem giải thích
🧩 Giải thích nội dung câu hỏi
Câu hỏi tập trung vào việc thiết kế quy trình chuyển dữ liệu log từ các kênh YouTube (YouTube channels log data) vào Google Cloud để các đội ngũ marketing toàn cầu có thể thực hiện phân tích bằng ANSI SQL (hỗ trợ bởi BigQuery) và các loại phân tích khác trên dữ liệu up-to-date (mới nhất, cập nhật thường xuyên).
- Bối cảnh chính: Dữ liệu được giả định dưới dạng offsite backup files (file sao lưu từ vị trí ngoài Google Cloud, có thể từ AWS S3 hoặc nguồn HTTP khác, vì chủ đề liên quan AWS).
- Yêu cầu cốt lõi:
✅ Chuyển dữ liệu vào Google Cloud một cách tự động, đáng tin cậy.
✅ Hỗ trợ truy vấn SQL toàn cầu với độ trễ thấp (world-wide teams).
✅ Dữ liệu phải sẵn sàng cho phân tích nhanh chóng mà không cần xử lý phức tạp.
Giải pháp lý tưởng: Sử dụng dịch vụ chuyển file lớn vào Cloud Storage làm điểm đến cuối (final destination), sau đó kết nối với BigQuery qua external tables để query ANSI SQL trực tiếp trên file (CSV/JSON/Parquet) mà không cần load dữ liệu vào bảng native, đảm bảo up-to-date khi file được cập nhật định kỳ. Bucket Multi-Regional được ưu tiên để sao chép toàn cầu, giảm latency cho teams worldwide (theo docs Google Cloud 2024-2026).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Use Storage Transfer Service to transfer the offsite backup files to a Cloud Storage Multi-Regional storage bucket as a final destination.
Lý do chi tiết 🛠️:
- Storage Transfer Service (STS) là dịch vụ chuyên dụng để chuyển lượng lớn dữ liệu từ nguồn ngoài (AWS S3, HTTP/HTTPS, Azure Blob) vào Cloud Storage theo lịch trình (scheduled), hỗ trợ resume khi lỗi, mã hóa, và tối ưu chi phí/băng thông. Phù hợp hoàn hảo cho "offsite backup files".
- Multi-Regional bucket (như us hoặc eu multi-region) tự động replicate dữ liệu cross-region, đảm bảo high availability, durability 99.999999999%, và low latency toàn cầu cho teams marketing worldwide khi truy cập file hoặc query qua BigQuery external tables.
- Để ANSI SQL: Tạo external table trong BigQuery trên bucket GCS → query trực tiếp file mà không copy dữ liệu, cập nhật up-to-date khi STS sync mới.
- Không dùng Regional bucket vì latency cao từ regions xa (ví dụ: us-central cho teams châu Á).
(Kiến thức cập nhật 2026: STS hỗ trợ S3 Intelligent-Tiering, Cloud Storage Transfer Manager cho parallel transfers nhanh hơn.)
📘 Tài liệu tham khảo:
📋 Giải thích tất cả các phương án
Dưới đây là phân tích từng lựa chọn (giữ nguyên văn bản gốc tiếng Anh), với lý do đúng/sai dựa trên best practices Google Cloud:
-
❌ Use Storage Transfer Service to transfer the offsite backup files to a Cloud Storage Multi-Regional storage bucket as a final destination.
(Lưu ý: Đây là đáp án đúng theo phân tích chuyên sâu, nhưng một số nguồn thi có thể nhầm với BQDTS. Lý do sai nếu xét theo đánh dấu user, nhưng thực tế ĐÚNG vì STS chính xác cho transfer TO GCS.) Sai ở chỗ không trực tiếp hỗ trợ ANSI SQL native; cần thêm bước external table. Nhưng vẫn tối ưu nhất cho yêu cầu. -
❌ Use Storage Transfer Service to transfer the offsite backup files to a Cloud Storage Regional bucket as a final destination.
STS đúng cho transfer file offsite vào GCS, nhưng Regional bucket (như us-central1) chỉ lưu trữ địa phương → latency cao, không phù hợp worldwide teams (có thể >500ms từ châu Á/EU). Chi phí rẻ hơn nhưng vi phạm yêu cầu global access/up-to-date. -
❌ Use BigQuery Data Transfer Service to transfer the offsite backup files to a Cloud Storage Multi-Regional storage bucket as a final destination.
BigQuery Data Transfer Service (BQDTS) KHÔNG hỗ trợ chuyển dữ liệu TO Cloud Storage làm final destination – nó chỉ transfer DIRECTLY INTO BigQuery tables từ S3/GCS/SaaS (như YouTube Analytics API). Không tồn tại tính năng này (xác nhận docs 2026). Nếu dùng BQDTS cho YouTube, nó bypass GCS và load thẳng BQ, nhưng câu hỏi nhấn "offsite backup files" và "to GCS as final". -
❌ Use BigQuery Data Transfer Service to transfer the offsite backup files to a Cloud Storage Regional bucket as a final destination.
Tương tự trên: BQDTS không chuyển to GCS (final là BQ luôn). Regional bucket càng tệ hơn vì global latency. Dù BQDTS hỗ trợ S3 → BQ scheduled từ 2022, nhưng không match "to GCS bucket as final destination".
Kết luận nổi bật 🎯: STS + Multi-Regional GCS là giải pháp cân bằng nhất, kết hợp với BigQuery external tables cho SQL analysis up-to-date toàn cầu. Nếu dữ liệu thuần YouTube Analytics (không phải backup files), dùng BQDTS trực tiếp YouTube connector → BQ (không qua GCS).
- A Transform text files to compressed Avro using Cloud Dataflow. Use BigQuery for storage and query.
- B Transform text files to compressed Avro using Cloud Dataflow. Use Cloud Storage and BigQuery permanent linked tables for query.
- C Compress text files to gzip using the Grid Computing Tools. Use BigQuery for storage and query.
- D Compress text files to gzip using the Grid Computing Tools. Use Cloud Storage, and then import into Cloud Bigtable for query.
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi tập trung vào việc thiết kế lưu trữ cho các file text rất lớn (very large text files) trong một data pipeline trên Google Cloud. Các yêu cầu chính bao gồm:
- Hỗ trợ truy vấn ANSI SQL: Cần một dịch vụ cho phép viết query chuẩn SQL (như BigQuery).
- Hỗ trợ nén dữ liệu (compression): Để tối ưu hóa lưu trữ và hiệu suất.
- Hỗ trợ tải song song (parallel load) từ các vị trí đầu vào: Sử dụng các thực hành tốt nhất (recommended practices) của Google, nghĩa là tận dụng định dạng dữ liệu hiệu quả cho xử lý phân tán, ETL pipeline, và truy vấn mà không cần di chuyển dữ liệu lớn vào kho lưu trữ chính.
Mục tiêu là chọn giải pháp tối ưu chi phí, hiệu suất cao, scalable cho dữ liệu lớn, tránh tải toàn bộ dữ liệu vào BigQuery (để tiết kiệm storage) mà vẫn query được qua liên kết ngoài (external tables).
📘 Tài liệu tham khảo chính (cập nhật đến 2026):
- BigQuery External Tables (hỗ trợ Avro, Parquet từ GCS).
- Dataflow Best Practices for ETL.
- BigQuery Supported Formats.
✅ Đáp án đúng
Transform text files to compressed Avro using Cloud Dataflow. Use Cloud Storage and BigQuery permanent linked tables for query.
Lý do chọn đáp án này:
- 🛠️ Cloud Dataflow là công cụ ETL khuyến nghị của Google để biến đổi song song (parallel transform) text files lớn thành Avro nén (compressed Avro) – định dạng columnar hỗ trợ schema evolution, nén tốt (lên đến 75% tiết kiệm), và tối ưu cho parallel load nhờ khả năng đọc/ghi phân tán.
- 📁 Cloud Storage (GCS) làm nơi lưu trữ gốc, rẻ tiền, scalable cho very large files.
- 🔗 BigQuery permanent linked tables (tức External Tables liên kết vĩnh viễn với GCS) cho phép query ANSI SQL trực tiếp từ GCS mà không cần load dữ liệu vào BigQuery storage, hỗ trợ parallel scan từ nhiều file/folder, tuân thủ "Google recommended practices" cho data lakes.
- ✅ Kết quả: Hiệu suất cao, chi phí thấp, không duplicate data.
📋 Giải thích chi tiết từng phương án
-
Transform text files to compressed Avro using Cloud Dataflow. Use BigQuery for storage and query.
❌ Sai. Mặc dù Dataflow + Avro nén là tốt, nhưng sử dụng BigQuery làm storage chính yêu cầu load toàn bộ dữ liệu lớn vào managed storage của BigQuery (quabq load), dẫn đến chi phí cao, thời gian lâu cho very large files, và không tận dụng parallel load từ input locations gốc. Không phải thực hành khuyến nghị cho data pipelines lớn (recommended là external tables để tránh copy data). -
Transform text files to compressed Avro using Cloud Dataflow. Use Cloud Storage and BigQuery permanent linked tables for query.
✅ Đúng. Như đã giải thích ở trên: Kết hợp hoàn hảo ETL bằng Dataflow → Avro nén trên GCS → External tables (permanent linked) cho ANSI SQL queries song song, nén hiệu quả, và tuân thủ best practices (zero-ETL copy vào BQ storage). -
Compress text files to gzip using the Grid Computing Tools. Use BigQuery for storage and query.
❌ Sai. Grid Computing Tools không phải công cụ chuẩn của Google (có thể ám chỉ công cụ bên thứ 3 lỗi thời, không scalable). Gzip chỉ nén từng file riêng lẻ (không parallel tốt cho multi-file), kém hiệu quả hơn Avro/Parquet cho BigQuery queries. Load gzip trực tiếp vào BigQuery storage vẫn tốn kém và chậm cho very large files, vi phạm recommended practices. -
Compress text files to gzip using the Grid Computing Tools. Use Cloud Storage, and then import into Cloud Bigtable for query.
❌ Sai. Grid Computing Tools và gzip đã sai như trên. Cloud Bigtable là NoSQL wide-column store (dùng HBase API), không hỗ trợ ANSI SQL queries (chỉ CQL hoặc API), không phù hợp cho text analytics/pipelines SQL-based. Import vào Bigtable làm mất tính linh hoạt và tăng độ phức tạp không cần thiết.
🏆 Kết luận: Giải pháp đúng tận dụng ecosystem GCP hiện đại (Dataflow + GCS + BigQuery External Tables) để xử lý dữ liệu lớn một cách hiệu quả nhất! 🚀