Ngân hàng đề — AWS Certified SysOps Administrator Associate
Tìm thấy 936 câu.
Amazon DynamoDB is experiencing a high level of rejected requests and this outage is directly impacting your applications. Your CTO would like to know all the resources that are affected in your AWS Account and how to mitigate them.
Where should you look first?
-
A
In DynamoDB
-
B
In AWS Personal Health Dashboard
-
C
In AWS Organizations
-
D
In AWS Service Health Dashboard
Xem giải thích
Đáp án
B — Xem AWS Personal Health Dashboard.
Vì sao đúng
Từ khoá quyết định nằm ở yêu cầu của CTO: "những tài nguyên nào TRONG TÀI KHOẢN CỦA CHÚNG TA bị ảnh hưởng".
⚠ Điểm mấu chốt — hai bảng điều khiển sức khoẻ, hai góc nhìn khác hẳn nhau:
Service Health Dashboard (nay là AWS Health Dashboard - Service health)
        ↓
    Tình trạng CHUNG của dịch vụ AWS theo Region
    Giống nhau với MỌI khách hàng
        ↓
    → "DynamoDB ở ap-southeast-1 đang có sự cố"

Personal Health Dashboard (Your account health)
        ↓
    Ảnh hưởng CỤ THỂ tới TÀI KHOẢN CỦA BẠN
        ↓
    → "bảng DynamoDB nào của bạn bị ảnh hưởng"
    → "instance nào của bạn nằm trên phần cứng sắp bảo trì"
    → kèm hướng dẫn giảm thiểu
⚠ Personal Health Dashboard cung cấp đúng ba thứ CTO đang hỏi:
| Thông tin | Nội dung |
|---|---|
| Danh sách tài nguyên bị ảnh hưởng | ARN cụ thể của từng tài nguyên |
| Cách giảm thiểu | AWS ghi rõ nên làm gì trong lúc chờ |
| Dòng thời gian | sự cố bắt đầu khi nào, cập nhật ra sao |
⚠ Và nó có thứ mà Service Health Dashboard không có — API và tự động hoá:
AWS Health API (cần gói Business hoặc Enterprise)
        ↓
    EventBridge nhận sự kiện aws.health
        ↓
    → tự động: chuyển lưu lượng sang Region khác,
      mở ticket nội bộ, báo lên kênh chat của đội
        ↓
    → biết trước cả những việc bảo trì có kế hoạch
      (EC2 retirement, RDS maintenance, chứng chỉ hết hạn)
Vì sao các phương án khác sai
-
D (AWS Service Health Dashboard) — đây là phương án gần nhất và là nơi hầu hết mọi người mở đầu tiên. Nó cho biết dịch vụ có sự cố hay không, nhưng không nói tài nguyên nào của bạn bị ảnh hưởng — mà đó chính xác là câu hỏi của CTO.
-
A (xem trong chính DynamoDB) — chỉ số và log của DynamoDB cho thấy triệu chứng (request bị từ chối, throttle), nhưng không cho biết nguyên nhân là sự cố phía AWS hay là do bảng của bạn bị cấu hình thiếu dung lượng.
-
C (AWS Organizations) — dịch vụ quản lý nhiều tài khoản: cây tổ chức, SCP, thanh toán gộp. Nó không có thông tin sức khoẻ dịch vụ nào.
Ghi nhớ
⚠ Hai bảng điều khiển sức khoẻ — bảng phải thuộc: | | Service Health Dashboard | Personal Health Dashboard | |---|---|---| | Phạm vi | toàn bộ AWS, chung cho mọi người | riêng tài khoản của bạn | | Nêu tài nguyên cụ thể | không | CÓ | | Việc bảo trì có kế hoạch | không | CÓ, báo trước | | Cần đăng nhập | không | có | | API / EventBridge | không | CÓ (gói Business+) |
Từ khoá nhận diện:
"tài nguyên NÀO CỦA TÔI bị ảnh hưởng" → Personal Health Dashboard "dịch vụ AWS có đang sập không" → Service Health Dashboard "tự động phản ứng khi AWS có sự cố" → AWS Health API + EventBridge "instance của tôi sắp bị retire" → Personal Health Dashboard "khuyến nghị tối ưu" → Trusted Advisor
| Các loại sự kiện của AWS Health | Nội dung |
|---|---|
issue |
sự cố đang diễn ra phía AWS |
scheduledChange |
bảo trì có kế hoạch — EC2 retirement, vá RDS |
accountNotification |
thông báo cho riêng tài khoản — hạn mức, chứng chỉ, thanh toán |
| Tự động hoá phản ứng | Cách |
|---|---|
EventBridge rule với source: aws.health |
lọc theo eventTypeCategory |
| Gửi tới SNS | báo cho đội trực |
| Gọi Lambda | tự chuyển lưu lượng, tự thay instance sắp retire |
| Organizational view | xem sức khoẻ toàn bộ tổ chức ở một chỗ |
| Khi nghi ngờ có sự cố phía AWS | Thứ tự kiểm tra |
|---|---|
| 1 | Personal Health Dashboard — có sự kiện nào cho tài khoản mình không |
| 2 | Service Health Dashboard — Region đó có sự cố chung không |
| 3 | CloudWatch — chỉ số của chính ứng dụng, xác nhận triệu chứng |
| 4 | CloudTrail — có ai vừa đổi cấu hình gì không (thường là đây) |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Có sự kiện nào không | describe-events của AWS Health API | | Tài nguyên nào dính | describe-affected-entities | | Đội có biết chưa | quy tắc EventBridge đã gửi tới SNS/chat chưa |
Và một lời khuyên vận hành: hãy dựng sẵn một quy tắc EventBridge đẩy sự kiện AWS Health vào kênh trực của đội — làm việc đó hôm nay, không phải trong lúc sự cố. Giữa một sự cố lớn, việc mất mười phút để tìm ra "đây là lỗi của chúng ta hay lỗi của AWS" là mười phút đắt nhất của cả ngày, và câu trả lời đó luôn nằm sẵn trong Personal Health Dashboard mà không ai nghĩ tới việc mở ra.
You host a forum for law questions and per your country's law, you must store all the archives of conversations (about 1 TB) every week for 7 years. These archives must not be tampered with in any way, and you must prove you have set enough controls around your data protection.
What should you do?
-
A
Store the archives in EBS and use Linux file system protection on the files
-
B
Store the archives in AWS Artifact and enable compliance monitoring
-
C
Store the archives in Glacier and set up a Vault Lock Policy for WORM access
-
D
Store the archives in S3 and set up a bucket policy, enable versioning and MFA-Delete
Xem giải thích
Đáp án
C — Lưu vào Glacier và thiết lập Vault Lock Policy cho chế độ truy cập WORM.
Vì sao đúng
Đề nêu ba yêu cầu, và chỉ Vault Lock thoả mãn cả ba:
| Đề nói | Nghĩa |
|---|---|
| "giữ 7 năm" | lưu trữ dài hạn, cần rẻ |
| "không được sửa đổi bằng bất kỳ cách nào" | WORM — ghi một lần, đọc nhiều lần |
| "phải CHỨNG MINH được đã có đủ kiểm soát" | cần cơ chế kiểm toán viên chấp nhận |
⚠ Điểm mấu chốt — Vault Lock là bất biến THẬT, không phải "khó xoá":
Tạo Vault Lock policy (ví dụ: cấm xoá trước 2555 ngày)
        ↓
    Trạng thái InProgress — có 24 GIỜ để thử nghiệm
        ↓
    Bấm CompleteVaultLock
        ↓
    → chính sách bị KHOÁ VĨNH VIỄN
    → KHÔNG AI sửa hay gỡ được, kể cả root
    → kể cả AWS Support
⚠ Cửa sổ 24 giờ là phần thiết kế quan trọng nhất, phải dùng đúng:
Trong 24 giờ đầu:
    - thử ghi, thử xoá, xác nhận chính sách đúng ý
    - sai thì AbortVaultLock và làm lại
        ↓
Sau khi Complete, hoặc quá 24 giờ mà không Complete
        ↓
    → khoá vĩnh viễn / chính sách bị huỷ
        ↓
    → không có đường lùi
Chính tính không đảo ngược đó là thứ khiến kiểm toán viên chấp nhận nó: bạn không cần chứng minh rằng sẽ không ai xoá dữ liệu, bạn chứng minh rằng không ai CÓ THỂ xoá.
Ví dụ chính sách:
{
  "Rule": [{
    "RuleId": "giu-7-nam",
    "Condition": {
      "NumericLessThan": {"glacier:ArchiveAgeInDays": "2555"}
    },
    "Effect": "Deny",
    "Principal": "*",
    "Action": "glacier:DeleteArchive"
  }]
}
Vì sao các phương án khác sai
-
D (S3 + bucket policy + versioning + MFA-Delete) — đây là phương án gần nhất và là một cấu hình bảo vệ tốt trong đời thực. Nhưng nó không phải WORM thật: bucket policy sửa lại được, và MFA-Delete có thể tắt bởi ai cầm thiết bị MFA của tài khoản gốc. Kiểm toán viên sẽ hỏi "ai có thể gỡ biện pháp này" và có câu trả lời — thế là không đạt. (Cách S3 tương đương thật sự là S3 Object Lock ở chế độ Compliance, nhưng phương án không nêu nó.)
-
A (lưu trên EBS và dùng quyền hệ thống tệp Linux) — quyền tệp do quản trị viên hệ thống đặt, nên cũng gỡ được bởi quản trị viên hệ thống. Ngoài ra EBS đắt hơn Glacier rất nhiều lần cho 7 năm × 1 TB mỗi tuần, và bản thân volume có thể bị xoá.
-
B (lưu vào AWS Artifact rồi bật giám sát tuân thủ) — hiểu sai hoàn toàn: AWS Artifact là cổng để BẠN TẢI VỀ tài liệu tuân thủ của AWS (báo cáo SOC, ISO, PCI). Bạn không lưu dữ liệu của mình vào đó.
Ghi nhớ
⚠ Các cơ chế WORM trên AWS — bảng phải thuộc: | Cơ chế | Gỡ được không | |---|---| | Glacier Vault Lock | KHÔNG, sau khi Complete | | S3 Object Lock — Compliance | KHÔNG, kể cả root | | S3 Object Lock — Governance | được, nếu có quyền s3:BypassGovernanceRetention | | AWS Backup Vault Lock | chế độ compliance thì không | | Bucket policy + MFA-Delete | được — không phải WORM thật |
Từ khoá nhận diện:
"không ai được sửa/xoá, phải chứng minh được" → Vault Lock hoặc Object Lock Compliance "giữ N năm theo luật" → retention period "tranh chấp pháp lý, chưa biết bao lâu" → Legal Hold "lưu trữ rẻ nhất" → Glacier Deep Archive "MFA-Delete là WORM" → SAI, gỡ được
| Ba lớp Glacier | Thời gian lấy lại |
|---|---|
| Instant Retrieval | mili giây |
| Flexible Retrieval | Expedited 1–5 phút, Standard 3–5 giờ, Bulk 5–12 giờ |
| Deep Archive | Standard 12 giờ, Bulk 48 giờ |
| Vault Lock — quy trình hai bước | Nội dung |
|---|---|
1. InitiateVaultLock |
chính sách vào trạng thái InProgress |
| 2. Thử nghiệm trong 24 giờ | ghi thử, xoá thử, xác nhận đúng ý |
3a. CompleteVaultLock |
khoá vĩnh viễn |
3b. AbortVaultLock |
huỷ, làm lại từ đầu |
| Quá 24 giờ không làm gì | chính sách tự huỷ |
| Chi phí cần tính trước | Nội dung |
|---|---|
| Thời gian lưu tối thiểu | Glacier 90 ngày, Deep Archive 180 ngày |
| Phí lấy lại | tính theo GB — Bulk rẻ nhất |
| Phí theo số đối tượng | gom tệp nhỏ lại trước khi lưu |
| Ước tính đề bài | 1 TB/tuần × 7 năm ≈ 364 TB — chọn lớp sai là chênh rất lớn |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Chính sách đã khoá chưa | get-vault-lock, xem State: Locked | | Chính sách có đúng ý không | thử xoá thật trong 24 giờ đầu | | Có bằng chứng cho kiểm toán không | xuất chính sách + CloudTrail ghi lại thao tác khoá |
Và một cảnh báo tương xứng với sức mạnh của công cụ này: hãy đọc lại chính sách Vault Lock cùng bộ phận pháp chế trước khi bấm CompleteVaultLock, và dùng trọn 24 giờ thử nghiệm. Đây là một trong số rất ít thao tác trên AWS thực sự không thể đảo ngược — đặt nhầm 25.550 ngày thay vì 2.555 ngày thì bạn vừa cam kết trả tiền lưu trữ cho tới năm 2096, và không có lệnh nào, không có ticket hỗ trợ nào gỡ được nó ra.
In order to improve the read performance of the files stored in S3, you have decided to deploy it using CloudFront. As part of this deployment, you would like to ensure that only CloudFront is allowed to access the S3 bucket files.
How can you achieve that?
-
A
Using an Origin Access Identity and a bucket policy
-
B
Attaching a security group to S3 and CloudFront and only allow incoming traffic from CloudFront using the security group rules
-
C
Attaching an IAM role to CloudFront and defining a bucket policy to only allow this role
-
D
Encrypt all your files using a KMS key that only CloudFront can access
Xem giải thích
Đáp án
A — Dùng Origin Access Identity kết hợp với bucket policy.
Vì sao đúng
Đây là mẫu kiến trúc chuẩn để đặt CloudFront trước một bucket S3 riêng tư.
⚠ Điểm mấu chốt — OAI là một danh tính đặc biệt mà CloudFront dùng để tự xưng với S3:
Tạo Origin Access Identity
        ↓
    Gắn OAI đó vào origin của distribution
        ↓
    Bucket policy chỉ cho phép ĐÚNG danh tính OAI đó đọc
        ↓
    Người dùng gọi thẳng URL S3 → 403 AccessDenied
    Người dùng gọi qua CloudFront → CloudFront ký request bằng OAI → 200
Bucket policy tương ứng:
{
  "Effect": "Allow",
  "Principal": {
    "AWS": "arn:aws:iam::cloudfront:user/CloudFront Origin Access Identity E1XXXXXXXXXX"
  },
  "Action": "s3:GetObject",
  "Resource": "arn:aws:s3:::bucket-cua-toi/*"
}
⚠ Đừng quên bước cuối, thiếu nó là công cốc:
Bật S3 Block Public Access cho bucket
        ↓
    → chặn mọi đường mở công khai khác
        ↓
    Không làm bước này thì một ACL cũ hay một
    bucket policy khác vẫn có thể để lọt dữ liệu ra ngoài
⚠ Ngày nay AWS khuyến nghị OAC thay cho OAI:
| OAI (cũ) | OAC (mới) | |
|---|---|---|
| SSE-KMS | không hỗ trợ tốt | hỗ trợ đầy đủ |
| Phương thức | chỉ GET, HEAD |
cả PUT, DELETE |
| Ký request | hạn chế | SigV4 đầy đủ |
| Cấu hình | qua ARN đặc biệt | qua aws:SourceArn của distribution |
Trong đề thi, OAI vẫn là đáp án đúng khi OAC không có mặt trong danh sách phương án — như câu này.
Xem thêm câu #11577: cùng bài toán "chỉ CloudFront được vào S3" nhưng bucket ở đó được cấu hình làm website endpoint, mà website endpoint không hỗ trợ OAI/OAC — khi ấy đáp án là custom origin + custom header.
Vì sao các phương án khác sai
-
C (gắn IAM role cho CloudFront rồi cho phép role đó trong bucket policy) — đây là phương án gần nhất vì ý tưởng thì đúng hướng: dùng một danh tính để CloudFront tự xưng. Nhưng CloudFront không gắn IAM role được; cơ chế dành riêng cho nó chính là OAI/OAC.
-
B (gắn Security Group cho S3 và CloudFront) — Security Group gắn vào ENI trong VPC. Cả S3 lẫn CloudFront đều không nằm trong VPC của bạn, nên không có chỗ nào để gắn.
-
D (mã hoá tệp bằng KMS key mà chỉ CloudFront truy cập được) — nhầm lẫn giữa mã hoá và kiểm soát truy cập. Ngoài ra chính OAI (bản cũ) mới là thứ không làm việc tốt với SSE-KMS — nên phương án này còn tự mâu thuẫn về kỹ thuật.
Ghi nhớ
⚠ Bảo vệ origin theo từng loại — bảng phải thuộc: | Origin | Cách chỉ cho CloudFront vào | |---|---| | S3 (REST endpoint) | OAC (hoặc OAI) | | S3 (website endpoint) | custom header bí mật — OAI không dùng được | | ALB / EC2 | custom header + WAF, hoặc prefix list của CloudFront | | ALB (mới hơn) | VPC origin — ALB không cần phơi ra internet |
Từ khoá nhận diện:
"chỉ CloudFront được đọc bucket" → OAC / OAI + bucket policy "bucket là website endpoint" → custom header, KHÔNG phải OAI "Security Group cho S3 hoặc CloudFront" → LUÔN SAI "link chia sẻ có hạn giờ" → CloudFront signed URL / signed cookie "chặn theo quốc gia" → geo restriction của CloudFront "chặn tấn công tầng ứng dụng" → AWS WAF gắn vào CloudFront
| Các bước triển khai đầy đủ | Nội dung |
|---|---|
| 1 | tạo OAC (hoặc OAI) |
| 2 | gắn vào origin của distribution |
| 3 | cập nhật bucket policy cho phép danh tính đó |
| 4 | bật Block Public Access trên bucket |
| 5 | kiểm tra: gọi thẳng S3 phải 403 |
| Lợi ích kèm theo khi đặt CloudFront trước S3 | Nội dung |
|---|---|
| Giảm chi phí | truyền dữ liệu ra từ CloudFront rẻ hơn từ S3 |
| Nhanh hơn | cache ở edge location gần người dùng |
| Chống DDoS | AWS Shield Standard miễn phí, gắn WAF được |
| HTTPS và tên miền riêng | qua ACM ở Region us-east-1 |
| Bẫy hay gặp | Nội dung |
|---|---|
| Chứng chỉ ACM cho CloudFront | BẮT BUỘC ở us-east-1 |
| Sửa tệp trên S3 | phải invalidation hoặc dùng tên tệp có phiên bản |
| Cache dựa trên gì | cache policy — cẩn thận với query string và header |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Gọi thẳng S3 có bị chặn không | curl URL S3 — phải 403 | | Qua CloudFront có được không | curl tên miền CloudFront — phải 200 | | Distribution đã triển khai xong chưa | trạng thái phải là Deployed, không phải InProgress |
Và một lời khuyên khi vận hành: hãy đặt tên tệp có phiên bản (style.a1b2c3.css) thay vì trông cậy vào invalidation. Invalidation mất vài phút để lan tới mọi edge location, chỉ được miễn phí 1.000 đường dẫn mỗi tháng, và trong lúc chờ thì mỗi người dùng thấy một phiên bản khác nhau tuỳ họ ở gần edge nào — một tình huống gỡ lỗi rất mệt mỏi mà chỉ cần đổi cách đặt tên tệp là tránh được hoàn toàn.
You distribute a monthly raw data extract of your public forum's discussions that is about 10TB each month. Currently, the archive is distributed through an EFS drive, that is mounted on all your EC2 instances. Customers retrieve the file through the load balancer you have. This solution is costing you a lot of money and forces you to tremendously scale on the 1st of each month as people all try to retrieve the file at the same time.
What can you do to improve the situation?
-
A
Enable enhanced networking between EC2 and ALB
-
B
Enable static file caching on the ALB
-
C
Store the files in S3 and distribute them using a CloudFront distribution instead
-
D
Store the files on instance stores instead, so you don't need to use EFS anymore
Xem giải thích
Đáp án
C — Lưu tệp trên S3 và phân phối bằng một CloudFront distribution.
Vì sao đúng
Kiến trúc hiện tại có ba tầng đều bị dùng sai mục đích, và cả ba đều tốn tiền:
| Đang dùng | Vấn đề |
|---|---|
| EFS cho tệp tĩnh 10 TB | EFS đắt hơn S3 nhiều lần cho mỗi GB |
| EC2 fleet chỉ để phục vụ tải tệp | phải scale lên đúng ngày mùng 1 |
| ALB truyền 10 TB × số khách | tính tiền theo LCU và theo dữ liệu xử lý |
⚠ Điểm mấu chốt — chuyển sang S3 + CloudFront gỡ bỏ cả ba:
S3 lưu tệp
        ↓
    Rẻ hơn EFS rất nhiều cho dữ liệu tĩnh
    Không cần EC2 nào tham gia phục vụ tải
        ↓
CloudFront phân phối
        ↓
    Tệp được CACHE ở edge location
        ↓
    Khách thứ hai trở đi tải từ edge, KHÔNG chạm vào S3
        ↓
    → không có gì để scale vào mùng 1
    → truyền dữ liệu ra rẻ hơn từ S3
⚠ Vì sao mô hình này đặc biệt hợp với tình huống của đề:
Tệp GIỐNG HỆT NHAU cho mọi khách
        ↓
    → tỷ lệ trúng cache gần như tuyệt đối
        ↓
Ai cũng tải cùng lúc vào mùng 1
        ↓
    → đúng kịch bản mà CDN sinh ra để giải
        ↓
Tệp chỉ đổi MỖI THÁNG MỘT LẦN
        ↓
    → đặt TTL rất dài, gần như không bao giờ phải làm mới
Hai cải tiến nên làm thêm:
| Việc | Lợi ích |
|---|---|
| Signed URL của CloudFront | chỉ khách hàng trả tiền tải được, link có hạn giờ |
| Lifecycle policy | bản trích xuất cũ chuyển sang Glacier, giảm chi phí lưu trữ |
Vì sao các phương án khác sai
-
B (bật cache tệp tĩnh trên ALB) — đây là phương án gần nhất vì caching đúng là hướng giải quyết. Nhưng ALB KHÔNG CÓ chức năng cache — nó chỉ định tuyến request. Muốn cache thì phải dùng CloudFront.
-
D (chuyển tệp sang instance store) — instance store là ổ đĩa tạm, mất sạch khi máy dừng, và mỗi instance sẽ cần bản sao riêng 10 TB. Vừa tốn kém vừa nguy hiểm, mà không giải quyết vấn đề đường truyền qua ALB.
-
A (bật enhanced networking giữa EC2 và ALB) — enhanced networking tăng PPS và giảm độ trễ cho instance, nhưng vấn đề ở đây là lượng dữ liệu và chi phí, không phải hiệu năng card mạng. Nó cũng đã bật sẵn trên mọi instance thế hệ mới.
Ghi nhớ
⚠ Chọn nơi lưu trữ theo mục đích — bảng phải thuộc: | Loại | Dùng cho | |---|---| | S3 | tệp tĩnh, phân phối, hồ dữ liệu, sao lưu | | EFS | hệ thống tệp chia sẻ cho nhiều EC2 cùng đọc ghi | | EBS | ổ đĩa của một instance | | Instance store | dữ liệu tạm, hiệu năng cực cao, mất khi dừng máy | | FSx | Windows (SMB), Lustre (HPC) |
Từ khoá nhận diện:
"phân phối tệp cho nhiều người tải" → S3 + CloudFront "ALB cache được không" → KHÔNG, phải dùng CloudFront "nhiều EC2 cùng ghi vào một hệ thống tệp" → EFS "tải lên nhanh từ xa" → S3 Transfer Acceleration "chỉ khách trả tiền mới tải được" → signed URL / signed cookie
| Vì sao CloudFront rẻ hơn cho phân phối | Nội dung |
|---|---|
| Giá truyền ra thấp hơn so với truyền thẳng từ S3 | |
| Miễn phí truyền từ S3 sang CloudFront (origin fetch) | |
| Cache hit không tính phí request tới S3 | |
| Shield Standard đi kèm miễn phí |
| Điều chỉnh cache cho hợp | Nội dung |
|---|---|
| TTL dài cho tệp không đổi | Cache-Control: max-age=2592000 |
| Tên tệp có phiên bản | du-lieu-2026-09.tar.gz — không cần invalidation |
| Origin Shield | thêm một lớp cache trước origin, giảm tải hơn nữa |
| Tệp rất lớn | CloudFront hỗ trợ range request, tải tiếp được khi đứt |
| Nếu dữ liệu cần bảo vệ | Cách |
|---|---|
| Signed URL | một tệp, một người, có hạn giờ |
| Signed cookie | nhiều tệp, cùng một phiên |
| OAC + Block Public Access | không ai vào thẳng S3 được |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Tỷ lệ trúng cache | chỉ số CacheHitRate của CloudFront | | Có bị trượt cache không | header X-Cache: Hit from cloudfront trong phản hồi | | Tiết kiệm bao nhiêu | Cost Explorer, so DataTransfer-Out trước và sau |
Và một lời khuyên khi chuyển đổi: hãy kiểm tra header X-Cache trong phản hồi ngay sau khi triển khai. Một cấu hình cache policy sai — chuyển tiếp toàn bộ query string hay toàn bộ header xuống origin — khiến gần như mọi request đều trượt cache, và khi đó bạn vừa trả tiền cho CloudFront vừa trả tiền cho S3 mà không được lợi gì. Con số CacheHitRate sẽ nói cho bạn biết ngay điều đó, nếu bạn nhớ nhìn vào nó.
How should MFA-Delete be enabled on an S3 bucket?
-
A
Using the root account and the AWS Console
-
B
Using the root account and the AWS CLI
-
C
Using an admin IAM user and the AWS Console
-
D
Using an admin IAM user and the AWS CLI
Xem giải thích
Đáp án
B — Bằng TÀI KHOẢN GỐC (root) và AWS CLI.
Vì sao đúng
MFA-Delete có hai điều kiện cùng lúc, và cả hai đều là ngoại lệ hiếm gặp trong AWS.
⚠ Điểm mấu chốt — chỉ root, và chỉ qua CLI/API:
Điều kiện 1: PHẢI là tài khoản gốc (root)
        ↓
    IAM user dù có quyền quản trị đầy đủ cũng KHÔNG bật được
        ↓
Điều kiện 2: PHẢI qua CLI hoặc API
        ↓
    Console KHÔNG có tuỳ chọn nào để bật MFA-Delete
Lệnh bật:
aws s3api put-bucket-versioning \
  --bucket ten-bucket \
  --versioning-configuration Status=Enabled,MFADelete=Enabled \
  --mfa "arn:aws:iam::111122223333:mfa/root-account-mfa-device 123456"
Chuỗi --mfa gồm ARN của thiết bị MFA và mã sáu số hiện tại, cách nhau bằng một dấu cách.
⚠ MFA-Delete bảo vệ đúng hai thao tác:
Xoá VĨNH VIỄN một phiên bản đối tượng (DeleteObjectVersion)
        ↓
Tắt hoặc đổi trạng thái versioning của bucket
        ↓
    → cả hai đều đòi mã MFA mới thực hiện được
Còn đây là điều rất hay bị hiểu nhầm:
Xoá đối tượng THÔNG THƯỜNG (không nêu version id)
        ↓
    → chỉ tạo ra một delete marker
    → KHÔNG cần MFA
    → dữ liệu vẫn còn nguyên ở phiên bản cũ
Nghĩa là MFA-Delete không chặn việc "xoá" hằng ngày, nó chặn việc xoá thật, không thể phục hồi.
⚠ Điều kiện tiên quyết và giới hạn:
Bucket PHẢI bật versioning trước
        ↓
Bật MFA-Delete rồi thì KHÔNG tắt versioning được
    (trừ khi tắt MFA-Delete trước, cũng bằng root + MFA)
        ↓
KHÔNG dùng được với lifecycle policy có expiration
Vì sao các phương án khác sai
-
A (root + Console) — đây là phương án gần nhất và vế root hoàn toàn đúng. Nhưng Console không có chỗ nào bật MFA-Delete — phải qua CLI hoặc API. Chỉ sai một nửa vẫn là sai.
-
C (IAM user quản trị + Console) — sai cả hai vế.
-
D (IAM user quản trị + CLI) — vế CLI đúng nhưng IAM user không làm được, dù có gắn
AdministratorAccess. Đây là một trong số rất ít thao tác chỉ root mới thực hiện được.
Xem thêm câu #11612: cùng chủ đề nhưng hỏi ở góc sau khi bật thì thao tác nào cần MFA — chỉ hai thao tác phá huỷ: xoá vĩnh viễn một phiên bản, và tạm ngừng versioning.
Ghi nhớ
⚠ Những việc CHỈ tài khoản gốc làm được — bảng phải thuộc: | Việc | |---| | Bật/tắt MFA-Delete trên bucket S3 | | Đổi email, tên tài khoản, thông tin thanh toán | | Đổi hoặc huỷ gói AWS Support | | Đóng tài khoản AWS | | Khôi phục quyền khi IAM policy tự khoá chính mình | | Đăng ký GovCloud, gửi form một số dịch vụ |
Từ khoá nhận diện:
"bật MFA-Delete" → root + CLI "MFA-Delete qua Console" → LUÔN SAI "IAM admin bật MFA-Delete" → LUÔN SAI "chống xoá theo yêu cầu tuân thủ" → Object Lock Compliance, không phải MFA-Delete "khôi phục đối tượng đã xoá" → versioning + xoá delete marker
⚠ MFA-Delete so với Object Lock — hai thứ hay bị dùng lẫn: | | MFA-Delete | S3 Object Lock | |---|---|---| | Bật bằng | root + CLI | lúc tạo bucket (hoặc mở ticket) | | Chặn ai | người không có thiết bị MFA | TẤT CẢ, kể cả root (chế độ Compliance) | | Dùng cho | chống xoá nhầm | tuân thủ pháp lý, WORM | | Gỡ được không | được, bởi root | Compliance thì KHÔNG | | Lifecycle | không dùng chung được | dùng chung được |
| Ba mức bảo vệ dữ liệu trên S3 | Nội dung |
|---|---|
| Versioning | giữ mọi phiên bản — nền tảng của mọi thứ còn lại |
| MFA-Delete | thêm một lớp cho thao tác xoá vĩnh viễn |
| Object Lock | bất biến thật sự, có thời hạn giữ |
| (kèm) Replication | sang bucket hoặc Region khác |
| Bẫy vận hành của MFA-Delete | Nội dung |
|---|---|
| Mất thiết bị MFA của root | phải qua quy trình khôi phục của AWS, rất phiền |
| Không tự động hoá được | mọi thao tác xoá vĩnh viễn cần người nhập mã |
| Lifecycle expiration không chạy | phiên bản cũ tích tụ mãi, chi phí lưu trữ tăng dần |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Đã bật chưa | get-bucket-versioning — xem trường MFADelete | | Thiết bị MFA của root là gì | IAM console, mục Security credentials của root | | Có bao nhiêu phiên bản tồn đọng | list-object-versions, hoặc S3 Storage Lens |
Và một lời khuyên thực dụng: với hầu hết nhu cầu chống xoá nhầm, versioning cộng với một bucket policy chặn s3:DeleteObjectVersion là đủ, và dễ vận hành hơn nhiều. MFA-Delete nghe rất hấp dẫn trên giấy, nhưng nó ràng buộc mọi thao tác dọn dẹp vào thiết bị MFA của tài khoản gốc — thứ mà trong một tổ chức lành mạnh thì hiếm ai được chạm tới, và cũng không nên phải chạm tới hằng tuần chỉ để xoá vài phiên bản cũ.
Your accounting application on an EC2 instance has the tendency to sometimes go into a panic and then the CPU Utilization of your EC2 instance runs at 100% for a long duration. When this happens, someone has to manually intervene and restart your application for it to work properly again.
How can you automate this in the most efficient way?
-
A
Create a CloudWatch Event when CPU Utilization reaches 100% and trigger an EC2 reboot action
-
B
Create a CloudWatch Alarm when CPU Utilization reaches 100% for 3 periods of 5 minutes and trigger an EC2 reboot action
-
C
Invoke an AWS Lambda function via a cron job that checks for the metric every minute and restarts the instance if a problem is found
-
D
Put your instance in an ASG and behind an ELB and enable ELB health check, so that the instance gets terminated upon problems and a new one gets created
Xem giải thích
Đáp án
B — Tạo CloudWatch Alarm khi CPU đạt 100% trong 3 chu kỳ 5 phút, và kích hoạt hành động reboot EC2.
Vì sao đúng
Đây là cơ chế EC2 action dựng sẵn của CloudWatch Alarm — không cần viết mã, không cần hạ tầng phụ.
⚠ Điểm mấu chốt — bốn hành động EC2 mà alarm gọi trực tiếp được:
CloudWatch Alarm → EC2 action:
        recover  → chuyển sang host khác (chỉ với StatusCheckFailed_System)
        reboot   → khởi động lại   ← câu này
        stop     → dừng máy
        terminate → chấm dứt máy
        ↓
    Không cần Lambda, không cần cron, không cần gì thêm
⚠ Vì sao "3 chu kỳ 5 phút" là con số quan trọng nhất trong đáp án:
CPU 100% trong 1 phút
        ↓
    → có thể chỉ là một tác vụ nặng bình thường

CPU 100% LIÊN TỤC 15 PHÚT
        ↓
    → đúng mô tả "chạy 100% trong thời gian dài" của đề
    → gần như chắc chắn ứng dụng đã treo
        ↓
    → tránh khởi động lại oan trong lúc máy đang làm việc thật
Đây chính là ý nghĩa của EvaluationPeriods — thứ ngăn cảnh báo phản ứng với những gai nhọn nhất thời.
aws cloudwatch put-metric-alarm \
  --alarm-name ung-dung-ke-toan-treo \
  --metric-name CPUUtilization --namespace AWS/EC2 \
  --dimensions Name=InstanceId,Value=i-xxxxxxxx \
  --statistic Average --period 300 --evaluation-periods 3 \
  --threshold 99 --comparison-operator GreaterThanThreshold \
  --alarm-actions arn:aws:automate:ap-southeast-1:ec2:reboot
Vì sao các phương án khác sai
-
A (tạo CloudWatch Event khi CPU đạt 100% rồi kích hoạt reboot) — đây là phương án gần nhất và chỉ sai ở một khái niệm. CloudWatch Events / EventBridge phản ứng với SỰ KIỆN, không phải với ngưỡng chỉ số. Không có cách nào khai "khi CPU chạm 100%" thành một event pattern; đó là công việc của Alarm. (EventBridge có thể bắt sự kiện alarm đổi trạng thái, nhưng khi đó vẫn phải có alarm trước.)
-
C (Lambda chạy cron mỗi phút để kiểm tra chỉ số) — chạy được nhưng là bản tự chế của thứ đã có sẵn: thêm mã phải bảo trì, thêm quyền IAM, thêm chi phí gọi Lambda mỗi phút, và thêm một chỗ có thể hỏng. Đề hỏi cách hiệu quả nhất.
-
D (đưa vào ASG sau ELB rồi để health check chấm dứt và thay máy) — về mặt kiến trúc thì đây là cách tốt nhất trong đời thực, nhưng nó không phải "tự động hoá việc khởi động lại" như đề yêu cầu, và là một cuộc tái kiến trúc chứ không phải một cấu hình. Với ứng dụng kế toán có trạng thái, thay máy còn có thể làm mất dữ liệu đang xử lý.
Ghi nhớ
⚠ Alarm và Event — bảng phải thuộc, đây là chỗ nhầm nhiều nhất: | | CloudWatch Alarm | EventBridge (CloudWatch Events) | |---|---|---| | Kích hoạt bởi | ngưỡng của một CHỈ SỐ | một SỰ KIỆN xảy ra | | Ví dụ | CPU > 80% trong 15 phút | instance chuyển sang stopped | | Hành động | EC2 action, SNS, Auto Scaling, Systems Manager | Lambda, SNS, SQS, Step Functions… | | Có trạng thái | OK / ALARM / INSUFFICIENT_DATA | không, chỉ là dòng sự kiện |
Từ khoá nhận diện:
"khi chỉ số vượt ngưỡng" → CloudWatch Alarm "khi có việc gì đó xảy ra" → EventBridge "tự khởi động lại máy treo" → Alarm + EC2 reboot action "host phần cứng lỗi" →
StatusCheckFailed_System+ recover action "thay máy hỏng bằng máy mới" → ASG health check
| Bốn EC2 action của alarm | ARN |
|---|---|
| Reboot | arn:aws:automate:<region>:ec2:reboot |
| Stop | arn:aws:automate:<region>:ec2:stop |
| Terminate | arn:aws:automate:<region>:ec2:terminate |
| Recover | arn:aws:automate:<region>:ec2:recover — chỉ với StatusCheckFailed_System |
| Ba tham số quyết định độ nhạy của alarm | Nội dung |
|---|---|
Period |
độ dài mỗi chu kỳ đánh giá |
EvaluationPeriods |
bao nhiêu chu kỳ liên tiếp phải vi phạm |
DatapointsToAlarm |
M trong N chu kỳ — linh hoạt hơn |
TreatMissingData |
xử lý khi thiếu dữ liệu |
| Nếu muốn làm tốt hơn nữa | Cách |
|---|---|
| Đặt cảnh báo trên chỉ số của ỨNG DỤNG | CPU 100% chỉ là triệu chứng |
| Systems Manager Automation | runbook: thu log rồi mới khởi động lại |
| Lifecycle hook | kịp lấy log trước khi máy đi |
| Sửa gốc rễ | tìm vì sao ứng dụng treo — reboot chỉ là băng dán |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Alarm có kích hoạt đúng lúc không | describe-alarm-history | | Reboot có thật sự chạy không | CloudTrail sự kiện RebootInstances | | Có khởi động lại oan không | đối chiếu lịch sử alarm với biểu đồ CPU |
Và một lời nhắc về bản chất của giải pháp này: tự động khởi động lại là băng dán, không phải thuốc chữa — nó biến một sự cố cần người can thiệp thành một sự cố im lặng. Hãy luôn gắn thêm một thông báo SNS vào cùng alarm đó, để mỗi lần máy tự khởi động lại thì có người biết; nếu không, ứng dụng có thể đang treo ba lần mỗi ngày suốt nhiều tháng mà không ai từng nhìn thấy vấn đề để đi tìm nguyên nhân thật.
A company manages multiple applications on a fleet of Amazon EC2 instances. The company is looking at automating the process of patch management for all the instances that includes OS updates, application updates and security updates.
Which service/tool is the right fit for this requirement?
-
A
Patch Fleet, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
B
Patch Manager, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
C
Fleet Manager, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
D
OS updates and patch management are responsibilities of AWS as per AWS Shared Responsibility model and does not need customer inputs
Xem giải thích
Đáp án
B — Patch Manager, một capability của AWS Systems Manager.
Vì sao đúng
Câu này kiểm tra hai thứ cùng lúc: biết Patch Manager, và không bị lừa bởi những cái tên nghe rất giống.
⚠ Điểm mấu chốt — trong ba cái tên được nêu, chỉ hai cái có thật:
Patch Manager  → CÓ THẬT — tự động vá, báo cáo tuân thủ  ← đáp án
Fleet Manager  → CÓ THẬT — nhưng để QUẢN LÝ và xem máy
Patch Fleet    → KHÔNG TỒN TẠI
⚠ Patch Manager làm đúng những gì đề liệt kê:
| Đề yêu cầu | Patch Manager |
|---|---|
| Cập nhật hệ điều hành | có — Linux và Windows |
| Cập nhật ứng dụng | có — Windows applications, và trên Linux là gói từ repo |
| Cập nhật bảo mật | có — baseline mặc định duyệt sẵn nhóm Security |
| Toàn bộ fleet cùng lúc | có — chọn theo Patch Group (tag) |
Cấu trúc của một lần vá tự động:
Patch Baseline  → duyệt bản vá nào được cài
        +
Patch Group     → máy nào thuộc nhóm nào (một tag)
        +
Maintenance Window → được vá vào khung giờ nào
        ↓
    → chạy tự động, xuất báo cáo COMPLIANT / NON_COMPLIANT
Xem thêm câu #11572: cùng đáp án Patch Manager nhưng đặt vấn đề từ góc kiểm toán tuân thủ và nhấn mạnh việc chọn máy theo tag. Hai câu bổ trợ nhau, không mâu thuẫn.
Vì sao các phương án khác sai
-
C (Fleet Manager) — đây là phương án gần nhất và Fleet Manager là một capability CÓ THẬT của Systems Manager. Nhưng việc của nó là quản lý và quan sát máy: xem danh sách instance, duyệt hệ thống tệp, xem log, kết nối vào máy qua giao diện. Nó không vá gì cả.
-
A (Patch Fleet) — không tồn tại. Đây là kiểu bẫy ghép hai tên thật thành một tên giả, rất hay gặp trong đề thi AWS.
-
D (vá hệ điều hành là trách nhiệm của AWS) — sai về mô hình trách nhiệm chia sẻ. Với EC2, khách hàng chịu trách nhiệm cho mọi thứ từ hệ điều hành trở lên, bao gồm cả việc vá. AWS chỉ vá phần hạ tầng bên dưới.
Ghi nhớ
⚠ Các capability của Systems Manager — bảng phải thuộc, đây là ổ bẫy tên gọi: | Capability | Việc | |---|---| | Patch Manager | vá hệ điều hành và ứng dụng, báo cáo tuân thủ | | Fleet Manager | xem và quản lý máy — duyệt tệp, xem log, xem hiệu năng | | Session Manager | shell không cần SSH, không cần cổng 22, không cần bastion | | Run Command | chạy lệnh một lần trên nhiều máy | | Automation | runbook nhiều bước | | State Manager | giữ máy ở đúng trạng thái mong muốn | | Inventory | kiểm kê phần mềm đã cài | | Parameter Store | lưu cấu hình và bí mật | | Application Manager | gom tài nguyên theo ứng dụng |
Từ khoá nhận diện:
"tự động vá" → Patch Manager "Patch Fleet" → KHÔNG TỒN TẠI "Amazon Patch Manager" → KHÔNG TỒN TẠI (đúng là AWS Systems Manager Patch Manager) "xem log và duyệt ổ đĩa của máy từ console" → Fleet Manager "vá là việc của AWS" → SAI với EC2, ĐÚNG với dịch vụ được quản lý (RDS, Lambda)
⚠ Mô hình trách nhiệm chia sẻ với EC2 — vẽ lại được là hiểu: | Tầng | Ai lo | |---|---| | Trung tâm dữ liệu, phần cứng, ảo hoá | AWS | | Hệ điều hành khách, bản vá OS | KHÁCH HÀNG | | Ứng dụng, dữ liệu, cấu hình | KHÁCH HÀNG | | Security Group, IAM, mã hoá | KHÁCH HÀNG |
| Với dịch vụ được quản lý thì khác | Nội dung |
|---|---|
| RDS | AWS vá công cụ cơ sở dữ liệu (trong maintenance window) |
| Lambda | AWS lo toàn bộ hệ điều hành và runtime |
| Fargate | AWS lo máy chủ, bạn lo image container |
| Ba điều kiện để Patch Manager thấy được máy | Nội dung |
|---|---|
| SSM Agent đang chạy | |
IAM instance profile với AmazonSSMManagedInstanceCore |
|
| Đường mạng tới endpoint SSM | NAT Gateway hoặc 3 VPC endpoint |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Máy nào chưa được quản lý | Fleet Manager — máy vắng mặt mới là vấn đề lớn | | Tình trạng tuân thủ | describe-instance-patch-states | | Vá có chạy đúng lịch không | lịch sử maintenance window |
Và một lời nhắc khi đọc báo cáo: instance vắng mặt trong Patch Manager nguy hiểm hơn instance báo NON_COMPLIANT. Máy không tuân thủ thì hiện ngay trên bảng và sẽ có người xử lý; còn máy thiếu SSM Agent hoặc thiếu IAM role thì đơn giản là không xuất hiện ở đâu cả, trong khi bảng tổng hợp vẫn hiện một tỷ lệ tuân thủ đẹp đẽ cho phần còn lại.
You are in S3 and have deleted all the files in it. As you can see, the bucket is empty:
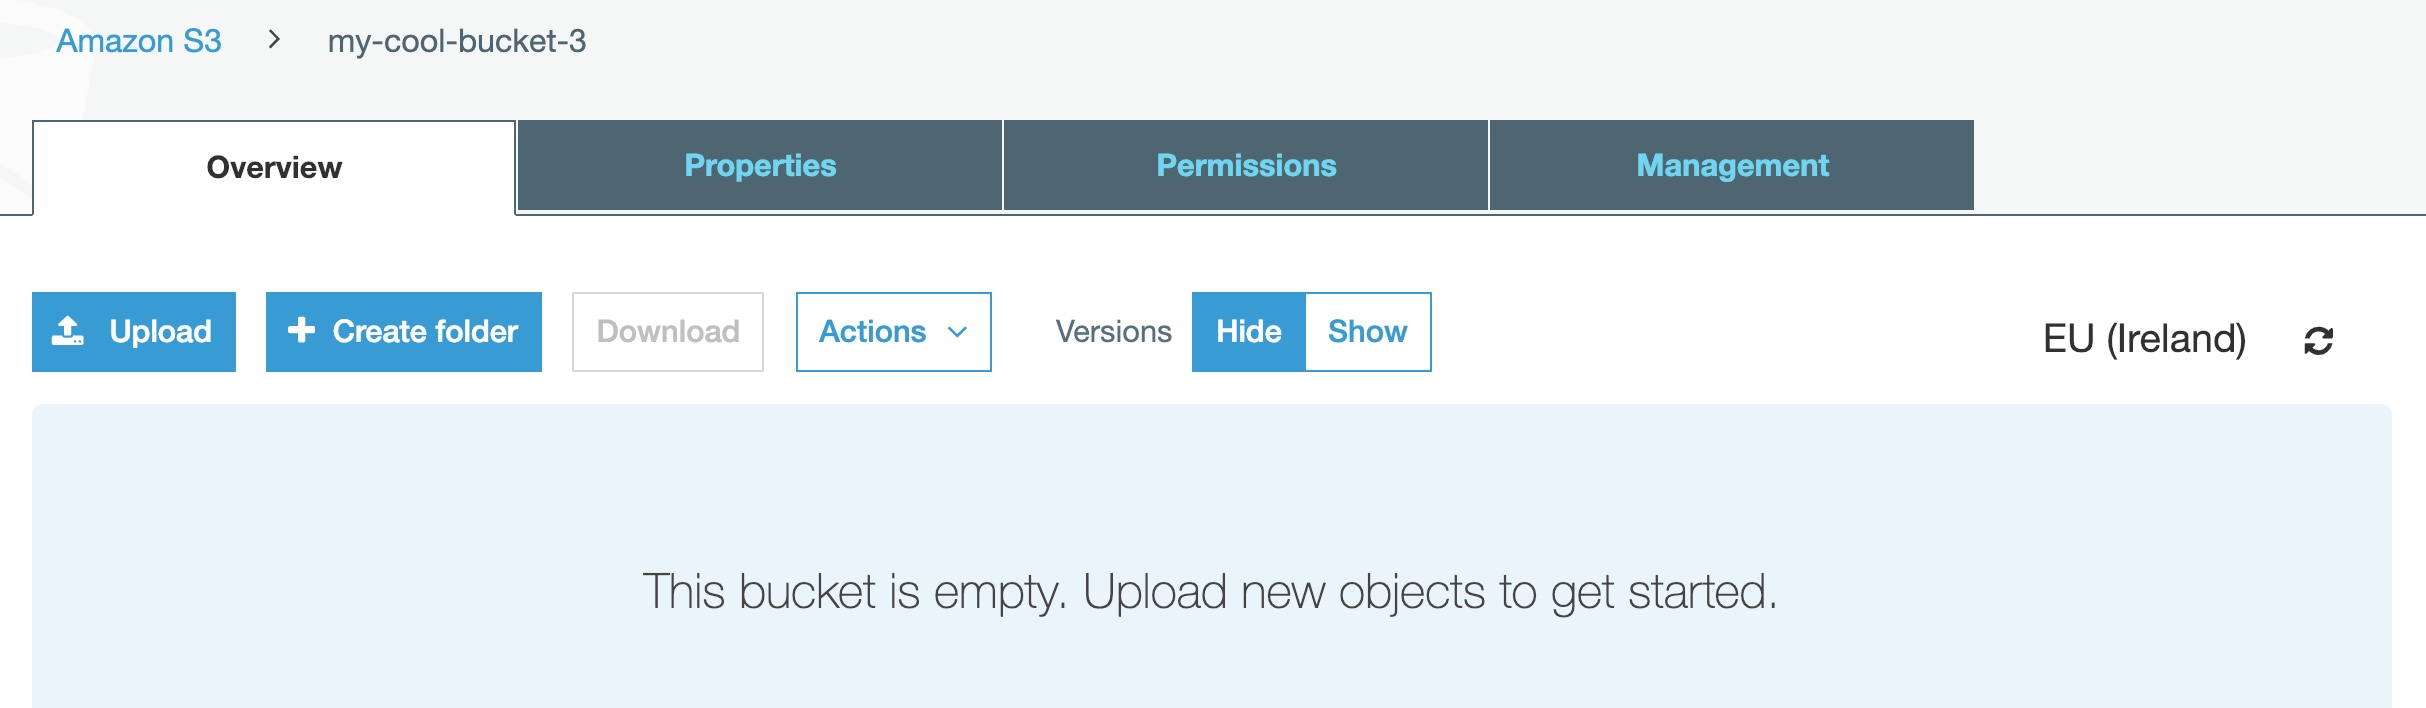
You have tried to delete the bucket afterward and it fails with an error saying the bucket is not empty.
What's the issue?
-
A
Some files are in Glacier
-
B
S3 is eventually consistent. Wait two minutes and retry, it will work then
-
C
S3 versioning is enabled and delete markers are still present in the bucket
-
D
An S3 bucket policy is set up and it prevents bucket deletion
Xem giải thích
Đáp án
C — Versioning đang bật và các delete marker vẫn còn trong bucket.
Vì sao đúng
Console S3 mặc định chỉ hiện phiên bản hiện tại của đối tượng, nên bucket trông có vẻ rỗng trong khi thực tế còn đầy dữ liệu.
⚠ Điểm mấu chốt — "xoá" trên bucket có versioning không xoá gì cả:
Bấm Delete trên một tệp
        ↓
    S3 KHÔNG xoá tệp
        ↓
    Nó tạo thêm một DELETE MARKER làm phiên bản mới nhất
        ↓
    → console không hiện tệp nữa (trông như đã xoá)
    → nhưng phiên bản cũ VẪN CÒN, vẫn tính tiền
        ↓
    Xoá bucket → S3 báo "bucket không rỗng"
⚠ Cách nhìn thấy sự thật — bật "Show versions" trên console, hoặc dùng CLI:
aws s3api list-object-versions --bucket ten-bucket \
  --query '{PhienBan: Versions[].Key, DanhDauXoa: DeleteMarkers[].Key}'
⚠ Cách dọn sạch thật sự:
# Cách nhanh nhất — xoá đệ quy MỌI phiên bản
aws s3 rb s3://ten-bucket --force

# Hoặc chủ động hơn: lifecycle rule dọn hộ
#   NoncurrentVersionExpiration: 1 ngày
#   ExpiredObjectDeleteMarker: true
Và đây cũng chính là mặt tốt của cơ chế này: xoá nhầm thì khôi phục được — chỉ cần xoá delete marker đi, tệp hiện lại nguyên vẹn.
Xem thêm câu #11608 và #11612: cùng chủ đề versioning, nói về MFA-Delete — lớp bảo vệ thêm cho thao tác xoá vĩnh viễn phiên bản.
Vì sao các phương án khác sai
-
B (S3 nhất quán cuối cùng, chờ hai phút rồi thử lại) — đây là phương án gần nhất và từng đúng một phần trước tháng 12/2020. Nhưng từ đó S3 đã có tính nhất quán mạnh (strong read-after-write consistency) cho mọi thao tác, ở mọi Region — chờ đợi không giải quyết gì.
-
A (một số tệp nằm trong Glacier) — đối tượng ở lớp Glacier vẫn là đối tượng S3 và vẫn xoá được bình thường; chúng không chặn việc xoá bucket. (Chỉ Object Lock mới chặn.)
-
D (bucket policy ngăn việc xoá bucket) — có thể xảy ra về lý thuyết, nhưng khi đó thông báo lỗi sẽ là
AccessDenied, chứ không phảiBucketNotEmptynhư đề mô tả.
Ghi nhớ
⚠ Versioning đổi ý nghĩa của "xoá" như thế nào — bảng phải thuộc: | Thao tác | Kết quả | |---|---| | DeleteObject (không nêu version) | tạo delete marker — dữ liệu còn nguyên | | DeleteObject + versionId | xoá vĩnh viễn đúng phiên bản đó | | Xoá delete marker | tệp hiện lại — đây là cách khôi phục | | GetObject khi có delete marker | trả về 404 | | GetObject + versionId | vẫn đọc được phiên bản cũ |
Từ khoá nhận diện:
"bucket rỗng mà không xoá được" → còn phiên bản hoặc delete marker "khôi phục tệp lỡ xoá" → xoá delete marker "hoá đơn S3 tăng dù không thêm dữ liệu" → phiên bản cũ tích tụ "S3 eventually consistent" → SAI từ 12/2020, giờ là strong consistency "xoá sạch bucket" →
aws s3 rb --force
| Ba trạng thái versioning | Nội dung |
|---|---|
| Unversioned | mặc định, một khi đã bật thì không quay lại được |
| Enabled | giữ mọi phiên bản |
| Suspended | phiên bản mới có id null, phiên bản cũ vẫn còn |
| Lifecycle rule nên có ở mọi bucket bật versioning | Nội dung |
|---|---|
NoncurrentVersionExpiration |
xoá phiên bản cũ sau N ngày |
ExpiredObjectDeleteMarker |
dọn delete marker mồ côi |
AbortIncompleteMultipartUpload |
dọn phần tải lên dang dở — rất hay bị quên, tốn tiền âm thầm |
NoncurrentVersionTransition |
chuyển phiên bản cũ sang IA/Glacier |
| Công cụ tìm dữ liệu ẩn | Nội dung |
|---|---|
| S3 Storage Lens | thấy ngay bao nhiêu dung lượng là phiên bản cũ |
| S3 Inventory | báo cáo hằng ngày/tuần liệt kê mọi đối tượng và phiên bản |
list-object-versions |
tra cứu tức thì |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Versioning có bật không | get-bucket-versioning | | Còn gì trong bucket | list-object-versions — không phải ls | | Dung lượng thật là bao nhiêu | Storage Lens hoặc chỉ số CloudWatch BucketSizeBytes (chọn đúng storage type) |
Và một lời khuyên áp dụng được ngay: hãy thêm lifecycle rule dọn phiên bản cũ cho mọi bucket ngay khi bật versioning. Đây là nguồn chi phí S3 âm thầm lớn nhất mà các đội hay gặp — một bucket log hay một thư mục build ghi đè cùng tên tệp mỗi ngày sẽ tích tụ hàng nghìn phiên bản trong im lặng, không hiện ra ở bất kỳ danh sách tệp nào, và chỉ lộ diện khi có ai đó mở Storage Lens ra xem vì tò mò.
After enabling S3 MFA-Delete, for which actions do you need MFA? (Select two)
-
A
Permanently delete an object version
-
B
Suspending versioning
-
C
Listing deleted versions
-
D
Enabling Versioning
-
E
Uploading a new object version
Xem giải thích
Đáp án
A, B — hai thao tác đòi MFA sau khi bật MFA-Delete:
- A — Xoá VĨNH VIỄN một phiên bản đối tượng.
- B — Tạm ngừng (suspend) versioning.
Vì sao đúng
MFA-Delete được thiết kế rất có chủ đích: nó chỉ canh những thao tác gây MẤT DỮ LIỆU KHÔNG PHỤC HỒI ĐƯỢC.
⚠ Điểm mấu chốt — hai thao tác này, và chỉ hai thao tác này:
Xoá vĩnh viễn một phiên bản (DeleteObjectVersion)
        ↓
    → dữ liệu MẤT HẲN, không có cách nào lấy lại
        ↓
    → phải có MFA

Tạm ngừng versioning
        ↓
    → gỡ bỏ chính lưới an toàn đang bảo vệ mọi thứ
        ↓
    → phải có MFA
⚠ Và đây là điều rất hay bị hiểu nhầm — xoá thông thường KHÔNG cần MFA:
Người dùng xoá một tệp (không nêu version id)
        ↓
    S3 chỉ tạo một DELETE MARKER
        ↓
    → dữ liệu vẫn còn nguyên, khôi phục được
        ↓
    → KHÔNG cần MFA
Điều này hợp lý: công việc hằng ngày không bị cản trở, còn thứ thật sự nguy hiểm thì bị khoá lại. Nếu MFA-Delete chặn cả thao tác xoá thường thì mọi ứng dụng dùng bucket đó sẽ hỏng ngay.
Cú pháp lệnh cần mã MFA:
aws s3api delete-object --bucket ten-bucket \
  --key bao-cao.pdf --version-id 3sL4kqtJlcpXroDTDmJ+rmSpXd3dIbrHY \
  --mfa "arn:aws:iam::111122223333:mfa/root-account-mfa-device 123456"
Xem thêm câu #11608: cùng chủ đề nhưng hỏi cách BẬT MFA-Delete — chỉ tài khoản gốc và chỉ qua CLI/API, không có trên Console.
Vì sao các phương án khác sai
-
D (bật versioning) — đây là phương án gần nhất vì nó đối xứng với đáp án B, nên rất dễ chọn nhầm. Nhưng bật versioning là thao tác làm tăng mức bảo vệ, còn tạm ngừng là giảm bảo vệ — MFA-Delete chỉ canh chiều làm yếu đi.
-
E (tải lên một phiên bản mới của đối tượng) — ghi thêm phiên bản không phá huỷ gì cả; phiên bản cũ vẫn còn nguyên. Đòi MFA cho mỗi lần ghi thì bucket sẽ không dùng được cho bất kỳ ứng dụng nào.
-
C (liệt kê các phiên bản đã xoá) — thao tác chỉ đọc. MFA-Delete không đụng tới quyền đọc.
Ghi nhớ
⚠ MFA-Delete canh gì và không canh gì — bảng phải thuộc: | Thao tác | Cần MFA | |---|---| | Xoá vĩnh viễn một phiên bản | CÓ | | Tạm ngừng versioning | CÓ | | Xoá thường (tạo delete marker) | không | | Bật versioning | không | | Tải lên phiên bản mới | không | | Liệt kê, đọc, tải về | không |
Từ khoá nhận diện:
"xoá vĩnh viễn phiên bản" → cần MFA "tạm ngừng versioning" → cần MFA "xoá tệp bình thường" → KHÔNG cần MFA, chỉ tạo delete marker "bật MFA-Delete" → root + CLI (xem #11608) "chặn xoá kể cả root" → Object Lock Compliance, không phải MFA-Delete
| Ba lớp bảo vệ dữ liệu trên S3 | Mức độ |
|---|---|
| Versioning | khôi phục được sau khi xoá nhầm |
| MFA-Delete | thêm rào cho thao tác phá huỷ |
| Object Lock (Compliance) | không ai gỡ được, kể cả root |
| Replication sang Region khác | chống mất cả một Region |
| Hệ quả vận hành của MFA-Delete | Nội dung |
|---|---|
| Lifecycle expiration không chạy | phiên bản cũ tích tụ, chi phí tăng dần |
| Không tự động hoá được | mọi lần dọn dẹp cần người nhập mã |
| Phụ thuộc thiết bị MFA của root | mất thiết bị là kẹt |
| Cân nhắc thay thế | bucket policy chặn s3:DeleteObjectVersion cho mọi principal trừ một role riêng |
| Cách khôi phục khi đã bật versioning | Các bước |
|---|---|
| 1 | list-object-versions tìm delete marker |
| 2 | delete-object --version-id <id-cua-delete-marker> |
| 3 | tệp hiện lại nguyên vẹn ở phiên bản trước đó |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | MFA-Delete đã bật chưa | get-bucket-versioning — xem trường MFADelete | | Thử nghiệm | thử xoá một phiên bản không kèm --mfa — phải bị từ chối | | Phiên bản cũ chiếm bao nhiêu | S3 Storage Lens |
Và một lưu ý về chi phí mà rất ít người nghĩ tới khi bật tính năng này: MFA-Delete và lifecycle expiration không dùng chung được. Bật MFA-Delete nghĩa là bạn vừa tự tay tắt cơ chế duy nhất tự động dọn phiên bản cũ — và trên một bucket có lưu lượng ghi cao, dung lượng sẽ lớn dần mãi mà không có gì trên bảng điều khiển S3 nhắc bạn rằng chuyện đó đang xảy ra.
Your website is hosted on S3 and exposed through a CloudFront distribution and some users are said to experience a lot of 501 errors.
How can you analyze these errors and come up with a solution?
-
A
Enable S3 access logs and analyze using Inspector
-
B
Analyze the CloudFront access logs using Inspector
-
C
Enable S3 access logs and analyze using Athena
-
D
Analyze the CloudFront access logs using Athena
Xem giải thích
Đáp án
D — Phân tích CloudFront access log bằng Amazon Athena.
Vì sao đúng
Có hai lựa chọn đúng phải ghép lại: đúng nguồn log và đúng công cụ phân tích.
⚠ Điểm mấu chốt thứ nhất — lỗi xảy ra ở CloudFront, nên log phải lấy ở CloudFront:
Người dùng → CloudFront → S3
                  ↓
        Lỗi 501 sinh ra ở đây
                  ↓
    → CloudFront access log ghi lại MỌI request,
      kể cả những request KHÔNG BAO GIỜ tới S3
        ↓
    S3 access log chỉ thấy phần đi tới S3
        ↓
    → nhìn vào S3 log là mù đúng chỗ cần nhìn
⚠ Điểm mấu chốt thứ hai — Athena là công cụ đúng cho log trên S3:
CloudFront access log đổ vào S3
        ↓
    Athena tạo bảng ngoài, truy vấn bằng SQL
    Không cần dựng máy chủ, trả tiền theo dữ liệu quét
        ↓
    Inspector là dịch vụ QUÉT LỖ HỔNG BẢO MẬT
        ↓
    → không phân tích log được, không liên quan
Truy vấn tìm nguyên nhân:
SELECT uri, useragent, edgeresultType, count(*) AS so_lan
FROM cloudfront_logs
WHERE status = 501
GROUP BY uri, useragent, edgeresultType
ORDER BY so_lan DESC;
⚠ Và đây là điều đáng biết về chính mã 501:
501 Not Implemented = phương thức HTTP không được hỗ trợ
        ↓
    CloudFront chỉ chuyển tiếp một số phương thức
    tuỳ cấu hình "Allowed HTTP Methods"
        ↓
    Client gửi PUT, POST, DELETE, PATCH...
    mà distribution chỉ cho phép GET, HEAD
        ↓
    → 501
        ↓
Chữa: mở rộng danh sách phương thức cho phép,
      hoặc sửa client — tuỳ ý đồ thiết kế
Với một website tĩnh trên S3 thì thường client mới là bên sai, và 501 chính là dấu hiệu có ai đó đang dò tìm điểm ghi dữ liệu.
Vì sao các phương án khác sai
-
C (bật S3 access log rồi phân tích bằng Athena) — đây là phương án gần nhất và công cụ thì đúng, nhưng nguồn log sai. Request bị CloudFront từ chối với 501 không bao giờ tới S3, nên S3 access log sẽ không có dòng nào về chúng.
-
B (phân tích CloudFront access log bằng Inspector) — nguồn log đúng, công cụ sai. Amazon Inspector quét lỗ hổng phần mềm trên EC2, container và Lambda; nó không đọc log.
-
A (S3 access log + Inspector) — sai cả hai vế.
Ghi nhớ
⚠ Chọn nguồn log theo nơi lỗi xảy ra — bảng phải thuộc: | Lỗi ở đâu | Log cần xem | |---|---| | CloudFront | CloudFront access log (hoặc real-time log) | | S3 | S3 server access log / CloudTrail data event | | ALB | ELB access log | | API Gateway | execution log và access log của stage | | Ứng dụng trên EC2 | CloudWatch Logs (qua agent) |
Từ khoá nhận diện:
"lỗi trên CloudFront" → CloudFront access log + Athena "Inspector phân tích log" → LUÔN SAI, Inspector quét lỗ hổng "501 Not Implemented" → phương thức HTTP không được cho phép "cần log tức thì, không chờ được" → CloudFront real-time logs (qua Kinesis) "chặn request độc hại" → AWS WAF
⚠ Mã lỗi hay gặp ở CloudFront — bảng đáng thuộc: | Mã | Nghĩa | |---|---| | 403 | bị WAF, geo restriction, hoặc origin từ chối (thiếu OAC) | | 404 | không có tệp ở origin | | 501 | phương thức HTTP không được distribution cho phép | | 502 | origin trả phản hồi hỏng, hoặc lỗi bắt tay SSL với origin | | 503 | origin quá tải | | 504 | origin không trả lời kịp — so với origin timeout |
| Hai kiểu log của CloudFront | Nội dung |
|---|---|
| Standard (access) log | đổ vào S3, miễn phí tính năng, trễ vài phút |
| Real-time log | qua Kinesis Data Streams, có phí, độ trễ vài giây |
| Trường quan trọng | x-edge-result-type (Hit, Miss, Error), x-edge-response-result-type |
| Ba cột đáng nhìn nhất khi gỡ lỗi | Nội dung |
|---|---|
sc-status |
mã CloudFront trả cho client |
x-edge-result-type |
trúng cache, trượt cache, hay lỗi |
x-edge-detailed-result-type |
lý do chi tiết — rất hữu ích với 403 và 502 |
Ba việc kiểm chứng: | Việc | Cách | |---|---| | Log đã bật chưa | cấu hình distribution, mục Standard logging | | Phương thức nào đang được phép | thuộc tính Allowed HTTP Methods của cache behavior | | Ai đang gửi request lạ | nhóm theo cs(User-Agent) và IP trong Athena |
Và một lời khuyên khi dựng bảng Athena cho log CloudFront: hãy phân vùng theo ngày ngay từ đầu. Log của một website đông khách tích tụ rất nhanh, và một truy vấn không phân vùng sẽ quét toàn bộ lịch sử để trả lời một câu hỏi về hôm qua — vừa chậm vừa tính tiền theo đúng lượng dữ liệu đã quét oan đó.