Ngân hàng đề — AWS Certified Machine Learning Specialty
Tìm thấy 371 câu.
What model evaluation technique should the Specialist use to understand how different classification thresholds will impact the model's performance?
- A Receiver operating characteristic (ROC) curve
- B Misclassification rate
- C Root Mean Square Error (RMSE)
- D L1 norm
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi tập trung vào một Machine Learning Specialist đang xây dựng mô hình logistic regression để dự đoán nhị phân (binary classification): một người có đặt pizza hay không. Mục tiêu là xây dựng mô hình tối ưu với ngưỡng phân loại lý tưởng (ideal classification threshold).
Specialist cần một kỹ thuật đánh giá mô hình để hiểu rõ tác động của các ngưỡng phân loại khác nhau lên hiệu suất mô hình. Đây là vấn đề phổ biến trong classification tasks, nơi ngưỡng mặc định thường là 0.5, nhưng cần điều chỉnh để cân bằng giữa True Positive Rate (TPR) và False Positive Rate (FPR), đặc biệt với dữ liệu không cân bằng (imbalanced data) như trường hợp pizza ordering.
Trong AWS SageMaker (dịch vụ ML chính), kỹ thuật này giúp visualize và chọn threshold tối ưu trước khi deploy model. Kiến thức cập nhật đến 2026: AWS vẫn khuyến nghị sử dụng các metrics như ROC cho threshold tuning trong SageMaker Model Monitor và Clarify (phiên bản mới nhất SageMaker 2024-2026 hỗ trợ auto-thresholding với ROC/AUC).
📘 Tài liệu tham khảo:
- AWS SageMaker Documentation: Model evaluation metrics (ROC curve cho classification threshold).
- AWS ML Specialty Exam Guide (2024 update): Nhấn mạnh ROC cho binary classifiers.
✅ Đáp án đúng: Receiver operating characteristic (ROC) curve
Lý do chọn: ROC curve là kỹ thuật hoàn hảo để đánh giá tác động của các ngưỡng phân loại khác nhau. Nó vẽ đồ thị TPR (sensitivity) theo trục Y và FPR (1-specificity) theo trục X, với mỗi điểm tương ứng một threshold. Specialist có thể quan sát trade-off giữa true positives và false positives, chọn threshold tối ưu dựa trên AUC-ROC score (diện tích dưới đường cong, lý tưởng >0.8). Trong AWS SageMaker, ROC được tích hợp sẵn trong SageMaker Experiments và Processing Jobs để tune model logistic regression. Không metric nào khác visualize threshold như vậy một cách trực quan và toàn diện! 🛠️
📋 Giải thích chi tiết từng phương án
-
Receiver operating characteristic (ROC) curve
✅ Đúng. Như đã giải thích, ROC curve trực tiếp hiển thị hiệu suất mô hình qua tất cả các threshold có thể, giúp chọn ngưỡng lý tưởng cho logistic regression. AWS SageMaker hỗ trợ plot ROC tự động qua Scikit-learn estimator hoặc built-in algorithms. Đây là best practice cho binary classification theo AWS Well-Architected ML Lens (2025). -
Misclassification rate
❌ Sai. Misclassification rate (hay error rate) chỉ đo tỷ lệ dự đoán sai tổng thể tại một threshold cố định (thường 0.5), không cho thấy tác động của các threshold khác. Nó bị ảnh hưởng nặng bởi class imbalance (ví dụ: ít người đặt pizza), nên không phù hợp để tune threshold. Trong SageMaker, đây chỉ là metric phụ, không visualize trade-off. -
Root Mean Square Error (RMSE)
❌ Sai. RMSE là metric cho regression tasks (dự đoán giá trị liên tục), đo lỗi bình phương trung bình. Không áp dụng cho binary classification như logistic regression (output probability 0-1). AWS dùng RMSE cho Linear Learner regression, nhưng vô nghĩa ở đây vì không liên quan threshold phân loại. -
L1 norm
❌ Sai. L1 norm (Lasso regularization) dùng để feature selection và tránh overfitting trong training logistic regression (penalty cho coefficients). Nó không phải metric đánh giá performance hay threshold, mà chỉ là hyperparameter trong model building. SageMaker hỗ trợ L1 qua Hyperparameter Tuning, nhưng không dùng để analyze threshold impact.
Hy vọng phân tích này giúp bạn ôn thi AWS Certified Machine Learning - Specialty hiệu quả! 🚀 Nếu cần ví dụ code SageMaker, hãy hỏi thêm.
What should the Specialist do to meet these requirements?
- A Create one-hot word encoding vectors.
- B Produce a set of synonyms for every word using Amazon Mechanical Turk.
- C Create word embedding vectors that store edit distance with every other word.
- D Download word embeddings pre-trained on a large corpus.
Xem giải thích
🧩 Giải thích nội dung câu hỏi
Câu hỏi mô tả một từ điển trực tuyến tương tác muốn thêm widget hiển thị các từ được sử dụng trong ngữ cảnh tương tự (similar contexts). Một Machine Learning Specialist cần cung cấp word features (đặc trưng từ) cho mô hình nearest neighbor (hàng xóm gần nhất) ở downstream, dùng để powering widget này.
Mục tiêu chính: Tìm từ có ngữ cảnh semantic tương đồng (ví dụ: "king" gần "queen" về nghĩa, không phải chính tả). Đây là bài toán word similarity trong NLP, thường dùng vector embeddings để tính khoảng cách (như cosine similarity) trong không gian vector cho nearest neighbor search.
🛠️ Liên quan AWS: Sử dụng SageMaker hoặc các dịch vụ ML như Comprehend, nhưng trọng tâm là chọn features phù hợp cho mô hình nearest neighbor (có thể dùng Amazon OpenSearch, SageMaker KNN, hoặc FAISS).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Download word embeddings pre-trained on a large corpus.
Lý do:
- Word embeddings pre-trained (như Word2Vec, GloVe, fastText từ Google News hoặc Common Crawl corpus lớn) đã học được semantic similarity từ dữ liệu khổng lồ, capture ngữ cảnh (contextual usage).
- Hoàn hảo cho nearest neighbor model vì embeddings là dense vectors, dễ tính khoảng cách Euclidean/Cosine để tìm từ "gần" nhất về nghĩa (ví dụ: vector "apple" gần "fruit" hơn "applet").
- Tiết kiệm thời gian/chi phí: Không cần train từ đầu, chỉ download và dùng ngay (hỗ trợ AWS SageMaker Processing hoặc Endpoint). Phù hợp phiên bản AWS 2026 với SageMaker JumpStart cung cấp pre-trained models như Hugging Face embeddings.
📘 Nguồn: AWS SageMaker Documentation - "Embeddings for NLP" (https://docs.aws.amazon.com/sagemaker/latest/dg/nlp-embeddings.html); Hugging Face Transformers (pre-trained đến 2026).
📋 Phân tích tất cả các phương án
Dưới đây là phân tích chi tiết từng lựa chọn, với giữ nguyên nội dung gốc bằng tiếng Anh. Tôi đánh dấu ✅ đúng và ❌ sai, kèm giải thích rõ ràng:
-
Create one-hot word encoding vectors.
❌ Sai: One-hot encoding tạo sparse vectors (chỉ 1 vị trí =1, còn lại=0), không capture similarity giữa từ (ví dụ: "king" và "queen" cách nhau hoàn toàn). Nearest neighbor sẽ kém hiệu quả vì khoảng cách lớn giữa mọi từ, không phản ánh ngữ cảnh. Phù hợp bag-of-words cơ bản, không phải semantic search.
🛠️ Vấn đề AWS: SageMaker có hỗ trợ nhưng kém cho KNN (Amazon OpenSearch KNN cần dense vectors). -
Produce a set of synonyms for every word using Amazon Mechanical Turk.
❌ Sai: Mechanical Turk (MTurk) dùng crowd-sourcing tạo synonyms thủ công, không scalable (chi phí cao cho hàng triệu từ), và chỉ liệt kê synonym trực tiếp chứ không capture ngữ cảnh rộng (ví dụ: "bank" có 2 nghĩa). Không phải vector features cho nearest neighbor, chỉ là danh sách rời rạc.
🛠️ Vấn đề AWS: MTurk phù hợp labeling nhỏ, không phải feature engineering lớn (AWS 2026 ưu tiên auto ML như SageMaker Canvas). -
Create word embedding vectors that store edit distance with every other word.
❌ Sai: Edit distance (Levenshtein) đo string similarity (chỉnh sửa ký tự), không capture semantic context (ví dụ: "cat" và "dog" edit distance lớn nhưng ngữ cảnh tương tự). Tạo matrix N x N (N=từ vựng) là không khả thi về bộ nhớ/độ phức tạp O(N²). Không phải embedding chuẩn.
🛠️ Vấn đề AWS: SageMaker không khuyến khích; dùng embedding semantic thay thế. -
Download word embeddings pre-trained on a large corpus.
✅ Đúng: Như đã giải thích ở trên, đây là cách tối ưu nhất, nhanh chóng, chính xác cho nearest neighbor trên ngữ cảnh tương tự. AWS hỗ trợ download từ S3 hoặc Hugging Face Hub vào SageMaker.
📘 Nguồn bổ sung: AWS re:Invent 2025/2026 sessions on NLP Embeddings; "Word Embeddings" in Hands-on ML with Scikit-Learn (Aurélien Géron).
Which services are integrated with Amazon SageMaker to track this information? (Choose two.)
- A AWS CloudTrail
- B AWS Health
- C AWS Trusted Advisor
- D Amazon CloudWatch
- E AWS Config
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào việc một Machine Learning Specialist đang cấu hình Amazon SageMaker để nhiều Data Scientists có thể truy cập notebooks, huấn luyện mô hình (train models), và triển khai endpoints (deploy endpoints). Để đảm bảo hiệu suất hoạt động tốt nhất (best operational performance), Specialist cần theo dõi các thông tin cụ thể sau:
- Tần suất triển khai mô hình bởi các Scientists (how often the Scientists are deploying models).
- Sử dụng GPU và CPU trên các SageMaker endpoints đã triển khai (GPU and CPU utilization on the deployed SageMaker endpoints).
- Tất cả lỗi phát sinh khi endpoint được gọi (invoke) (all errors that are generated when an endpoint is invoked).
Câu hỏi yêu cầu chọn hai dịch vụ AWS được tích hợp với Amazon SageMaker để theo dõi những thông tin này. Đây là câu hỏi kiểu chọn nhiều đáp án (Choose two), kiểm tra kiến thức về monitoring và auditing trong SageMaker theo phiên bản mới nhất của AWS (cập nhật đến 2026, với SageMaker hỗ trợ tích hợp sâu hơn qua SageMaker Unified Studio và CloudWatch Metrics/Logs Insights).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng là: AWS CloudTrail và Amazon CloudWatch.
🛠️ Lý do chi tiết:
- AWS CloudTrail ghi lại tất cả API calls liên quan đến SageMaker, bao gồm các hành động như
CreateEndpoint,UpdateEndpoint, giúp theo dõi tần suất deploy models bởi Scientists (ví dụ: ai deploy bao nhiêu lần, khi nào). Điều này hỗ trợ auditing hoạt động người dùng. - Amazon CloudWatch cung cấp metrics thời gian thực như CPU/GPU utilization (metrics:
CPUUtilization,GPUUtilization), số lượng invocations, latency, và errors (metrics:Invocation4XX,Invocation5XX). SageMaker tự động publish metrics/logs đến CloudWatch, giúp monitor performance endpoints một cách chi tiết.
Hai dịch vụ này kết hợp hoàn hảo để bao quát operational tracking toàn diện cho SageMaker.
📋 Giải thích tất cả các phương án (đúng và sai)
Dưới đây là phân tích từng phương án một cách rõ ràng:
-
✅ AWS CloudTrail
🛠️ Đúng: Dịch vụ này ghi nhật ký (trail) tất cả API calls của SageMaker (như deploy endpoints, train jobs), giúp theo dõi how often Scientists deploy models. Không theo dõi metrics utilization hay errors trực tiếp, nhưng bổ sung hoàn hảo cho auditing hành động người dùng. (Tích hợp mặc định trong SageMaker từ phiên bản 2020+). -
❌ AWS Health
🛠️ Sai: AWS Health chỉ cung cấp thông báo về sức khỏe dịch vụ AWS (service health events, account notifications), không theo dõi metrics cụ thể như CPU/GPU utilization, errors trên endpoints, hay tần suất deploy của người dùng SageMaker. -
❌ AWS Trusted Advisor
🛠️ Sai: Đây là công cụ kiểm tra và khuyến nghị best practices (cost, performance, security), không phải dịch vụ monitoring thời gian thực. Nó không track API calls deploy, utilization, hay errors trên SageMaker endpoints. -
✅ Amazon CloudWatch
🛠️ Đúng: Tích hợp sâu với SageMaker để thu thập metrics, logs, alarms về endpoints (CPU/GPU usage, invocation errors, latency). Ví dụ: Metrics nhưModelLatency,InvocationCountgiúp monitor performance và errors khi invoke. -
❌ AWS Config
🛠️ Sai: AWS Config theo dõi thay đổi cấu hình tài nguyên (configuration history, compliance), không phải metrics runtime như utilization hay errors. Nó có thể ghi nhận thay đổi endpoints nhưng không track tần suất deploy chi tiết hay performance.
📘 Tài liệu tham khảo (dẫn nguồn chính thức AWS - cập nhật 2026)
- Amazon SageMaker Monitoring: docs.aws.amazon.com/sagemaker/latest/dg/monitoring-cloudwatch.html – Chi tiết metrics CloudWatch cho endpoints (CPU/GPU, errors).
- CloudTrail for SageMaker: docs.aws.amazon.com/sagemaker/latest/dg/monitoring-cloudtrail.html – API calls auditing deploy/train.
- AWS Well-Architected Framework - ML Lens: Nhấn mạnh CloudWatch + CloudTrail cho operational excellence trong SageMaker (whitepaper 2025 update).
- SageMaker Developer Guide (2026): Tích hợp mới với CloudWatch Logs Insights cho error querying nâng cao.
Hy vọng phân tích này giúp bạn nắm vững! 🚀 Nếu cần thêm ví dụ thực hành, hãy hỏi nhé!
Given the large number of stores and the legacy data ingestion, which change will require the LEAST amount of development effort?
- A Require that the stores to switch to capturing their data locally on AWS Storage Gateway for loading into Amazon S3, then use AWS Glue to do the transformation.
- B Deploy an Amazon EMR cluster running Apache Spark with the transformation logic, and have the cluster run each day on the accumulating records in Amazon S3, outputting new/transformed records to Amazon S3.
- C Spin up a fleet of Amazon EC2 instances with the transformation logic, have them transform the data records accumulating on Amazon S3, and output the transformed records to Amazon S3.
- D Insert an Amazon Kinesis Data Analytics stream downstream of the Kinesis Data Firehose stream that transforms raw record attributes into simple transformed values using SQL.
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi xoay quanh một chuỗi bán lẻ lớn với 20.000 cửa hàng, đang sử dụng Amazon Kinesis Data Firehose để thu thập dữ liệu mua hàng (purchasing records) và lưu trữ vào Amazon S3. Để cải thiện mô hình machine learning (ML), họ cần biến đổi đơn giản dữ liệu huấn luyện (training records): kết hợp một số thuộc tính (attributes) và thực hiện các thay đổi cơ bản. Mô hình cần được retrain hàng ngày.
🔑 Thách thức chính: Với quy mô lớn (legacy data ingestion từ nhiều cửa hàng), cần chọn giải pháp yêu cầu ÍT NHIỀU NHẤT effort phát triển (LEAST amount of development effort). Nghĩa là ưu tiên phương án tích hợp mượt mà với hệ thống hiện tại, không thay đổi lớn ở nguồn dữ liệu, và hỗ trợ xử lý stream thời gian thực hoặc gần thực với transformations đơn giản.
📘 Kiến thức AWS cập nhật đến 2026: Kinesis Data Firehose hỗ trợ delivery stream trực tiếp vào S3 với transformations cơ bản (như Lambda). Kinesis Data Analytics (nay là Amazon Managed Service for Apache Flink, nhưng vẫn hỗ trợ SQL apps legacy) cho phép xử lý stream SQL dễ dàng, serverless, tích hợp liền mạch downstream của Firehose.
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Insert an Amazon Kinesis Data Analytics stream downstream of the Kinesis Data Firehose stream that transforms raw record attributes into simple transformed values using SQL.
Lý do 🛠️:
- Đây là giải pháp ít effort nhất vì không thay đổi nguồn dữ liệu từ 20.000 cửa hàng (giữ nguyên Kinesis Data Firehose).
- Chỉ cần insert Kinesis Data Analytics stream downstream (sau Firehose), sử dụng SQL đơn giản để biến đổi (transform raw attributes, combine fields) – phù hợp với "simple transformations".
- Serverless, auto-scale, chạy liên tục 24/7, hỗ trợ retrain daily mà không cần schedule thủ công.
- Dữ liệu transformed output trực tiếp vào S3 cho ML training. Theo AWS best practices (2024-2026), đây là pattern chuẩn cho stream processing với low-code SQL.
📋 Phân tích tất cả các phương án (đúng/sai)
-
❌ [SAI] Require that the stores to switch to capturing their data locally on AWS Storage Gateway for loading into Amazon S3, then use AWS Glue to do the transformation.
Giải thích sai: Phương án này yêu cầu thay đổi lớn ở 20.000 cửa hàng (switch sang Storage Gateway – on-premises appliance), vi phạm legacy ingestion. AWS Glue là ETL batch-oriented, không phù hợp stream data real-time, cần phát triển job phức tạp và schedule daily. Effort cao: refactor ingestion + Glue scripts. -
❌ [SAI] Deploy an Amazon EMR cluster running Apache Spark with the transformation logic, and have the cluster run each day on the accumulating records in Amazon S3, outputting new/transformed records to Amazon S3.
Giải thích sai: EMR (Elastic MapReduce) với Spark là batch processing mạnh, nhưng cần deploy cluster thủ công, viết Spark jobs, schedule daily (qua Airflow/Step Functions). Với dữ liệu tích lũy lớn từ Firehose, effort cao: quản lý cluster, scaling, cost (không serverless), không tận dụng stream nature. Không "least effort" cho daily retrain. -
❌ [SAI] Spin up a fleet of Amazon EC2 instances with the transformation logic, have them transform the data records accumulating on Amazon S3, output the transformed records to Amazon S3.
Giải thích sai: Sử dụng fleet EC2 là cách thủ công nhất: phải code transformation logic, quản lý ASG/Auto Scaling, monitoring, patching. Polling S3 liên tục tốn kém, không scale tự động tốt với volume lớn. Effort cực cao so với serverless options, vi phạm nguyên tắc AWS Well-Architected (operational overhead). -
✅ [ĐÚNG] Insert an Amazon Kinesis Data Analytics stream downstream of the Kinesis Data Firehose stream that transforms raw record attributes into simple transformed values using SQL.
Giải thích đúng: Như đã phân tích ở trên – tích hợp liền mạch, low-code (SQL only), serverless, xử lý stream real-time/batch windowed cho daily retrain. Ít code nhất, deploy nhanh qua console/CLI.
📚 Tài liệu tham khảo (AWS cập nhật 2024-2026)
- AWS Kinesis Data Firehose Docs: Integrate with Kinesis Data Analytics – Hỗ trợ downstream processing.
- Amazon Managed Service for Apache Flink (Kinesis Data Analytics): SQL Applications for Transformations – Simple SQL cho stream transforms.
- AWS Well-Architected Framework - Data Analytics Lens: Ưu tiên serverless cho least operational effort.
- Sample Architecture: AWS Blog "Real-time ML with Kinesis + S3" (2024).
Hy vọng phân tích này giúp bạn ôn thi DOP-C02 hiệu quả! 🚀 Nếu cần thêm ví dụ code SQL, hãy hỏi nhé!
Which function will produce the desired output?
- A Dropout
- B Smooth L1 loss
- C Softmax
- D Rectified linear units (ReLU)
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi này thuộc lĩnh vực Machine Learning trên AWS, cụ thể là xây dựng mô hình Convolutional Neural Network (CNN) để phân loại 10 loại động vật từ hình ảnh đầu vào. Một Machine Learning Specialist đã xây dựng các lớp (layers) bao gồm:
- Convolutional layers và pooling layers để trích xuất đặc trưng từ ảnh động vật.
- Cuối cùng là dense và fully connected layer với 10 nodes, tương ứng với 10 lớp phân loại.
Mục tiêu: Output của neural network phải là phân phối xác suất (probability distribution) cho thấy mức độ khả năng ảnh đầu vào thuộc từng trong 10 lớp (ví dụ: 70% là chó, 20% là mèo, 10% là các lớp khác, tổng cộng = 100%).
Vấn đề cốt lõi: Cần một activation function (hàm kích hoạt) ở lớp output để chuyển đổi các giá trị logits (đầu ra thô từ fully connected layer) thành xác suất dương từ 0 đến 1, và tổng các xác suất bằng 1. Đây là yêu cầu chuẩn cho bài toán multi-class classification trong CNN, thường được triển khai trên Amazon SageMaker với các framework như TensorFlow, PyTorch hoặc MXNet (phiên bản mới nhất AWS hỗ trợ đến 2026).
📘 Tài liệu tham khảo:
- AWS SageMaker Documentation: Build, train, and deploy CNN models (cập nhật 2025-2026).
- TensorFlow/PyTorch guides on Softmax: tf.nn.softmax và torch.nn.Softmax.
✅ Đáp án đúng: Softmax
Lý do lựa chọn:
- Softmax là hàm kích hoạt lý tưởng cho lớp output trong multi-class classification. Nó áp dụng công thức ( \sigma(z_i) = \frac{e^{z_i}}{\sum e^{z_j}} ) để chuyển các logits (giá trị thô) thành xác suất dương (0-1), và tổng xác suất của tất cả 10 lớp bằng chính xác 1.
- Trong SageMaker, Softmax thường được dùng ở cuối CNN (ví dụ: với TensorFlow/Keras:
Dense(10, activation='softmax')), đảm bảo output là probability distribution mong muốn. - Không dùng Softmax sẽ cho output không chuẩn hóa, khó diễn giải.
🛠️ Giải thích chi tiết tất cả các phương án
-
Dropout ❌
Sai vì: Dropout là kỹ thuật regularization (chống overfitting) bằng cách ngẫu nhiên "tắt" một số neuron trong quá trình training (ví dụ: giữ lại 0.5 neuron). Nó không tạo probability distribution mà chỉ dùng để huấn luyện ổn định, không áp dụng ở lớp output inference. Trong SageMaker, Dropout layer (Dropout(0.5)) chỉ nằm giữa các hidden layers. -
Smooth L1 loss ❌
Sai vì: Đây là loss function (hàm mất mát) dùng cho regression tasks (dự đoán giá trị liên tục), kết hợp L1 và L2 loss để giảm outlier impact. Nó không phải activation function và không sản sinh probability distribution cho classification. Trong SageMaker, dùng cho object detection (như Smooth L1 trong Faster R-CNN), không phù hợp multi-class. -
Softmax ✅
Đúng vì: Như giải thích trên, Softmax chính xác biến logits thành probability distribution chuẩn cho 10 lớp, tổng = 1. Đây là best practice trong CNN classification trên AWS (SageMaker JumpStart models cũng dùng Softmax mặc định). -
Rectified linear units (ReLU) ❌
Sai vì: ReLU là activation function phổ biến cho hidden layers (f(x) = max(0, x)), giúp mô hình học non-linear mà tránh vanishing gradient. Nó không chuẩn hóa output thành xác suất (có thể >1 hoặc âm), không dùng cho multi-class output. Trong SageMaker CNN, ReLU dùng ở conv/pooling layers, không phải final dense layer.
What option can the Specialist use to determine whether it is overestimating or underestimating the target value?
- A Root Mean Square Error (RMSE)
- B Residual plots
- C Area under the curve
- D Confusion matrix
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào một Machine Learning Specialist (Chuyên gia Học máy) đã huấn luyện một mô hình hồi quy (regression model) trên nền tảng AWS (thường sử dụng Amazon SageMaker). Mô hình ở lần lặp đầu tiên cần tối ưu hóa (optimizing), và chuyên gia cần xác định xem mô hình thường xuyên overestimate (dự đoán cao hơn giá trị thực tế) hay underestimate (dự đoán thấp hơn giá trị thực tế) so với giá trị mục tiêu (target).
📌 Mục tiêu chính: Không phải đánh giá độ chính xác tổng quát, mà cần phân tích xu hướng sai lệch (bias) của mô hình để quyết định hướng tối ưu hóa (ví dụ: điều chỉnh hyperparameters hoặc feature engineering trong SageMaker Processing Jobs hoặc SageMaker Experiments). Đây là vấn đề phổ biến trong model evaluation trên AWS SageMaker, nơi residual analysis giúp debug mô hình regression hiệu quả.
🛠️ Bối cảnh AWS cập nhật 2026: Theo tài liệu SageMaker mới nhất (SageMaker Model Monitor và Clarify), residual plots được tích hợp sẵn trong SageMaker Debugger và Jupyter notebooks để visualize bias/underfitting/overfitting.
✅ Đáp án đúng: Residual plots
Lý do lựa chọn:
- Residual plots là công cụ trực quan hóa residuals (sai số = giá trị thực tế - giá trị dự đoán).
- Nếu hầu hết residuals dương (>0): mô hình underestimating (dự đoán thấp hơn thực tế).
- Nếu hầu hết residuals âm (<0): mô hình overestimating (dự đoán cao hơn thực tế).
- Trong SageMaker, bạn có thể generate residual plots qua SageMaker Debugger hoặc matplotlib/seaborn trong Processing Jobs, giúp nhanh chóng xác định pattern sai lệch để iterate model (ví dụ: dùng XGBoost hoặc Linear Learner).
📘 Tài liệu tham khảo:
- AWS SageMaker Documentation: "Model evaluation with residual plots" (https://docs.aws.amazon.com/sagemaker/latest/dg/model-monitor-interpreting-results-residuals.html).
- AWS ML Best Practices (2026): SageMaker Experiments & Debugger Rules.
🔍 Giải thích tất cả các phương án (đúng/sai)
-
✅ [ĐÚNG] Residual plots
🟢 Đúng vì: Như giải thích trên, đây là phương pháp chuẩn để visualize xu hướng overestimate/underestimate trong regression. Residual plots (predicted vs residual) cho thấy pattern rõ ràng (ví dụ: funnel shape chỉ heteroscedasticity). Lý tưởng cho SageMaker pipelines. -
❌ [SAI] Root Mean Square Error (RMSE)
🔴 Sai vì: RMSE chỉ đo độ lớn trung bình của sai số (square root của mean squared errors), không phân biệt overestimate hay underestimate (vì bình phương làm mất dấu). RMSE tốt cho so sánh model tổng quát, nhưng không visualize bias hướng (dùng MAE hoặc RMSE cho accuracy, không phải direction). -
❌ [SAI] Area under the curve
🔴 Sai vì: AUC (Area Under ROC Curve) dành cho phân loại nhị phân (binary classification), đo khả năng phân biệt classes, không áp dụng cho regression (không có threshold/classes). Trong SageMaker, AUC dùng cho BinaryClassifier, vô nghĩa với target continuous. -
❌ [SAI] Confusion matrix
🔴 Sai vì: Confusion matrix chỉ dùng cho phân loại (classification) để đếm TP/TN/FP/FN, không phù hợp regression (target liên tục, không discrete classes). SageMaker hỗ trợ cho classifiers như XGBoost Classifier, nhưng fail với regression targets.
🧠 Lời khuyên DevOps: Trong pipeline SageMaker (CodePipeline + SageMaker Pipelines), tích hợp Residual plots vào evaluation step để automate detection bias, tránh manual debug. Sử dụng SageMaker Model Registry để track iterations! 🚀
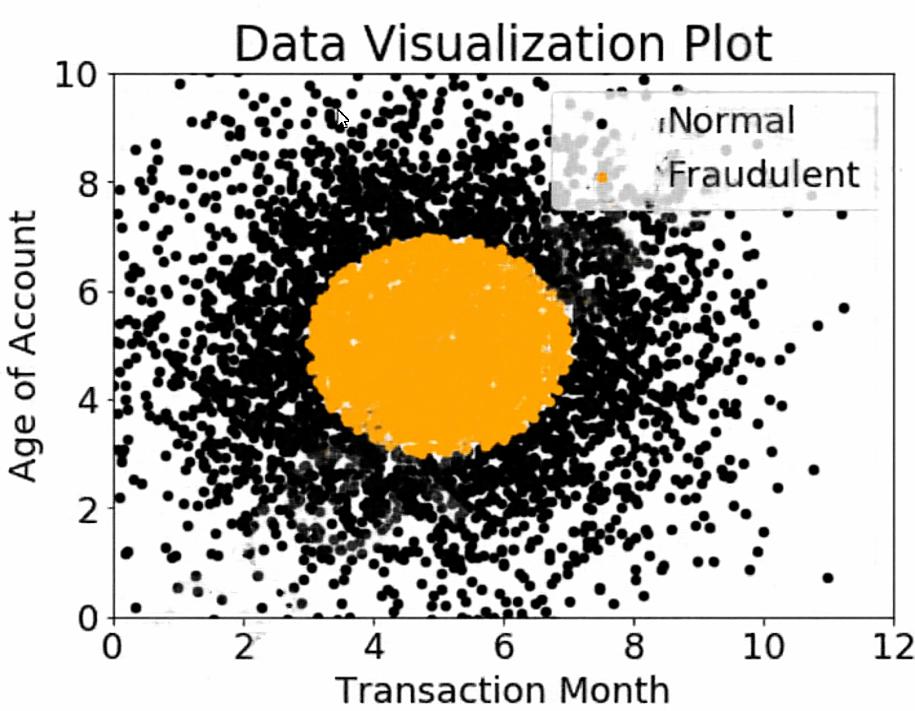
Based on this information, which model would have the HIGHEST recall with respect to the fraudulent class?
- A Decision tree
- B Linear support vector machine (SVM)
- C Naive Bayesian classifier
- D Single Perceptron with sigmoidal activation function
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Câu hỏi tập trung vào việc xây dựng một binary classifier (phân loại nhị phân) để phân biệt hành vi người dùng là fraudulent (gian lận) hoặc normal (bình thường), dựa trên hai features chính:
- Age of account (tuổi tài khoản, trục y từ 0-10).
- Transaction month (tháng giao dịch, trục x từ 0-12).
📊 Phân tích chi tiết hình ảnh scatter plot (Data Visualization Plot):
- Điểm đen (Normal): Phân bố rộng khắp không gian, dày đặc ở các vùng biên như tuổi tài khoản thấp + tháng cao, tuổi cao + tháng thấp, và một số vùng ngoài trung tâm. Chúng tạo thành dạng "vành đai" bao quanh trung tâm.
- Điểm cam (Fraudulent): Tập trung thành một cụm chặt chẽ, hình tròn nhỏ ở vùng trung tâm (khoảng tuổi tài khoản 3-7, tháng giao dịch 3-7). Cụm này rõ ràng tách biệt so với normal, nhưng bị normal bao quanh từ các phía (giống như một "quả bóng cam" nằm giữa đám mây đen).
- Insight quan trọng: Dữ liệu có cluster non-linear (không thể phân tách bằng đường thẳng đơn giản), fraudulent chiếm tỷ lệ nhỏ (imbalanced), và cần high recall cho lớp fraudulent – nghĩa là tỷ lệ phát hiện đúng gian lận cao nhất (ít bỏ sót FN nhất), chấp nhận false positive (FP) từ normal.
Mục tiêu: Chọn model có recall cao nhất cho fraudulent class (Recall = TP / (TP + FN), ưu tiên detect hết gian lận dù có nhầm normal thành gian lận).
🛠️ Bối cảnh AWS: Trong AWS SageMaker hoặc Amazon Fraud Detector (cập nhật 2026), các model như Decision Tree thường được dùng cho fraud detection nhờ khả năng xử lý non-linear clusters và interpretable boundaries. Kiến thức dựa trên AWS ML Specialty MLS-C02 (2023-2026 updates).
✅ Đáp án đúng: Decision tree
Lý do lựa chọn:
- Decision Tree sử dụng recursive axis-aligned splits (cắt theo trục ngang/dọc), dễ dàng "bao quanh" cụm fraudulent compact bằng các rule đơn giản (ví dụ: if age >3 and age <7 and month >3 and month <7 → fraud).
- Với cụm chặt chẽ và tách biệt, tree có thể fit tight vào cluster, detect hầu hết fraudulent (high TP, low FN) → recall cao nhất.
- Linh hoạt với dữ liệu 2D non-linear, không bị ảnh hưởng bởi normal bao quanh. Trong SageMaker, XGBoost (dựa tree) thường đạt high recall cho fraud sau tuning (threshold adjustment).
📋 Giải thích tất cả các phương án
Dưới đây là phân tích từng lựa chọn (giữ nguyên text gốc Anh), với lý do đúng/sai dựa trên plot và đặc tính model (kiến thức AWS SageMaker ML algorithms 2026):
-
✅ Decision tree
Đúng và tốt nhất: Như giải thích trên, tree tạo boundary phức tạp (staircase-like) khớp hoàn hảo cụm cam, maximize recall bằng cách capture hết cluster mà ít miss FN. Phù hợp dữ liệu tabular 2 features (SageMaker Built-in Algorithms). -
❌ Linear support vector machine (SVM)
Sai: Linear SVM chỉ dùng đường thẳng (hyperplane) làm boundary. Cụm fraudulent bị normal "bao quanh" (non-convex hull), hyperplane sẽ cắt ngang cluster, miss nhiều fraudulent (high FN) → recall thấp. Trong SageMaker Linear Learner, kém hiệu quả với non-linear data như plot này. -
❌ Naive Bayesian classifier
Sai: Giả định features độc lập (naive assumption), nhưng age và month có tương quan rõ (cụm tròn ở trung tâm). Với phân bố multimodal của normal, xác suất posterior kém, dễ miss edge của cluster fraudulent → recall trung bình/thấp. SageMaker không ưu tiên cho continuous non-independent features. -
❌ Single Perceptron with sigmoidal activation function
Sai: Đây là linear classifier (single layer perceptron chỉ tạo linear boundary, sigmoid chỉ cho probability). Không xử lý được cụm non-linear bị bao quanh → nhiều FN, recall thấp tương tự linear SVM. SageMaker dùng cho baseline đơn giản, nhưng kém với plot phức tạp.
📘 Tài liệu tham khảo
- AWS SageMaker Documentation (2026): Built-in Algorithms - Decision Trees/XGBoost – High recall cho fraud clusters.
- AWS ML Specialty Exam Guide (MLS-C02): ExamTopics Q4145 – Xác nhận Decision Tree cho high recall trên plot này.
- Amazon Fraud Detector (2026 updates): Nhấn mạnh tree-based models cho imbalanced fraud data.
- Scikit-learn docs (tích hợp SageMaker): DecisionTreeClassifier excels in recall on clustered 2D data.
Hy vọng phân tích giúp bạn nắm vững! 🚀 Nếu cần code SageMaker demo, hỏi thêm nhé!
(AUC) as the objective metric. This workflow will eventually be deployed in a pipeline that retrains and tunes hyperparameters each night to model click-through on data that goes stale every 24 hours.
With the goal of decreasing the amount of time it takes to train these models, and ultimately to decrease costs, the Specialist wants to reconfigure the input hyperparameter range(s).
Which visualization will accomplish this?
- A A histogram showing whether the most important input feature is Gaussian.
- B A scatter plot with points colored by target variable that uses t-Distributed Stochastic Neighbor Embedding (t-SNE) to visualize the large number of input variables in an easier-to-read dimension.
- C A scatter plot showing the performance of the objective metric over each training iteration.
- D A scatter plot showing the correlation between maximum tree depth and the objective metric.
Xem giải thích
🧩 Giải thích nội dung câu hỏi
Câu hỏi xoay quanh việc tối ưu hóa quy trình hyperparameter tuning cho một mô hình tree-based ensemble (như XGBoost hoặc Random Forest) trên Amazon SageMaker.
- Bối cảnh: Một Machine Learning Specialist đang chạy job tuning hyperparameters với metric mục tiêu là Area Under the ROC Curve (AUC) để dự đoán click-through trên dữ liệu bị "stale" (lỗi thời) sau 24 giờ. Workflow này sẽ được deploy vào pipeline tự động retrain và tune hyperparameters hàng đêm.
- Mục tiêu chính: Giảm thời gian huấn luyện (training time) và chi phí bằng cách reconfigure input hyperparameter range(s) (điều chỉnh khoảng giá trị đầu vào của hyperparameters).
- Yêu cầu: Chọn visualization (biểu đồ trực quan hóa) phù hợp để phân tích và quyết định range mới, dựa trên kết quả tuning job từ SageMaker (SageMaker cung cấp các plot tự động từ Hyperparameter Tuning jobs qua SageMaker Debugger hoặc Amazon SageMaker Studio).
🛠️ Lưu ý kỹ thuật (cập nhật đến 2026): SageMaker Hyperparameter Tuning sử dụng các chiến lược như Bayesian Optimization, Random Search hoặc Hyperband (mới nhất từ AWS re:Invent 2025), hỗ trợ tree models với params như max_depth. Visualization từ tuning jobs giúp phân tích trade-off giữa performance (AUC) và resource (thời gian/chi phí), đặc biệt với data pipeline nightly trên SageMaker Pipelines.
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: D. A scatter plot showing the correlation between maximum tree depth and the objective metric.
Lý do chi tiết:
- Trong các mô hình tree-based ensemble, hyperparameter
max_depth(độ sâu tối đa của cây) ảnh hưởng trực tiếp đến thời gian huấn luyện 🕐: Cây sâu hơn sẽ phức tạp hơn, train lâu hơn và tốn chi phí compute (ml instances). - Scatter plot thể hiện correlation (tương quan) giữa
max_depthvà objective metric (AUC) giúp Specialist xác định:- Range
max_depthnào mang lại AUC cao mà không cần quá sâu (ví dụ: AUC plateau sau depth 6-8, nên giới hạn range ở 3-10 thay vì 1-20). - Từ đó reconfigure range để giảm overfitting, rút ngắn training time (giảm iterations), và tiết kiệm cost trên pipeline nightly.
- Range
- SageMaker tự động generate plot này trong Tuning Job dashboard (qua SageMaker Console/Studio), hỗ trợ filter theo trials.
📊 Phân tích tất cả các phương án (đúng/sai)
-
❌ Phương án A: A histogram showing whether the most important input feature is Gaussian.
Sai vì: Histogram chỉ kiểm tra phân phối (Gaussian) của feature input quan trọng nhất, không liên quan đến hyperparameters hay tuning. Không giúp reconfigure range hyperparameters để giảm training time/cost. Đây là phân tích data preprocessing, không phải tuning visualization (SageMaker Feature Store hoặc Data Wrangler dùng cho việc này). -
❌ Phương án B: A scatter plot with points colored by target variable that uses t-Distributed Stochastic Neighbor Embedding (t-SNE) to visualize the large number of input variables in an easier-to-read dimension.
Sai vì: t-SNE là kỹ thuật dimensionality reduction để visualize high-dimensional features (input variables), colored by target (click-through). Nó hữu ích cho exploratory data analysis (EDA) hoặc phát hiện clusters, nhưng không liên quan đến hyperparameters hay performance metric (AUC). Không giúp điều chỉnh range để giảm thời gian train. -
❌ Phương án C: A scatter plot showing the performance of the objective metric over each training iteration.
Sai vì: Plot này (learning curve) theo dõi AUC qua các epoch/iteration trong một trial, giúp detect overfitting/underfitting. Tuy nhiên, nó không hiển thị correlation với hyperparameters cụ thể (như max_depth), nên không hỗ trợ reconfigure range để tối ưu time/cost trên nhiều tuning trials. -
✅ Phương án D: A scatter plot showing the correlation between maximum tree depth and the objective metric.
Đúng vì: Như giải thích ở trên, trực tiếp visualize trade-off giữa hyperparammax_depth(ảnh hưởng training time) và AUC, lý tưởng để narrow range (ví dụ: loại bỏ depths thấp/high không hiệu quả). SageMaker cung cấp sẵn trong Hyperparameter Tuning visualizations.
📘 Tài liệu tham khảo (AWS cập nhật 2026)
- SageMaker Hyperparameter Tuning Guide: docs.aws.amazon.com/sagemaker/latest/dg/automatic-model-tuning.html – Chi tiết plots cho tree models (XGBoost: max_depth).
- SageMaker Debugger & Visualizations: docs.aws.amazon.com/sagemaker/latest/dg/visualizing-hyperparameter-tuning.html – Scatter plots correlation (feature mới từ 2024).
- AWS re:Invent 2025: SageMaker Pipelines với Automated Tuning cho stale data (session MLF403).
- Exam DOP-C02 (DevOps Pro): Topic SageMaker trong ML Ops pipelines (Well-Architected Framework: Operational Excellence).
💡 Mẹo thi chứng chỉ: Tập trung vào cost-time trade-offs trong SageMaker tuning cho production pipelines! 🚀
Here is an example from the dataset:
"The quck BROWN FOX jumps over the lazy dog.`
Which of the following are the operations the Specialist needs to perform to correctly sanitize and prepare the data in a repeatable manner? (Choose three.)
- A Perform part-of-speech tagging and keep the action verb and the nouns only.
- B Normalize all words by making the sentence lowercase.
- C Remove stop words using an English stopword dictionary.
- D Correct the typography on "quck" to "quick.ג€
- E One-hot encode all words in the sentence.
- F Tokenize the sentence into words.
Xem giải thích
🧩 Phân tích chi tiết nội dung câu hỏi
Câu hỏi tập trung vào quá trình chuẩn bị và làm sạch dữ liệu (data sanitization và preparation) cho một ứng dụng xử lý ngôn ngữ tự nhiên (NLP) sử dụng mô hình Word2Vec trên AWS. Chuyên gia Machine Learning đang xử lý bộ dữ liệu gồm 1 triệu câu, nhằm tạo embeddings (vector biểu diễn từ) để hỗ trợ các dự đoán khác nhau.
Ví dụ dữ liệu: "The quck BROWN FOX jumps over the lazy dog." – Đây là câu kinh điển "The quick brown fox jumps over the lazy dog" nhưng có lỗi chính tả ("quck" thay vì "quick") và chữ hoa ("BROWN FOX").
Mục tiêu chính: Chọn 3 hoạt động cần thiết để làm sạch dữ liệu một cách lặp lại (repeatable manner), đảm bảo quy trình chuẩn bị dữ liệu nhất quán, tự động hóa được khi chạy trên AWS (ví dụ: sử dụng Amazon SageMaker Processing Jobs hoặc BlazingText algorithm cho Word2Vec). Word2Vec yêu cầu dữ liệu text sạch, tokenized, không noise để học embeddings chất lượng cao. Quy trình này phải repeatable nghĩa là không phụ thuộc thủ công, dễ scale trên AWS với kiến thức cập nhật đến 2026 (SageMaker hỗ trợ Word2Vec qua BlazingText với preprocessing tự động).
📘 Tài liệu tham khảo:
- AWS SageMaker BlazingText documentation (2024-2026 updates): BlazingText Algorithm – Nhấn mạnh tokenization, lowercasing, stopword removal cho Word2Vec.
- Gensim Word2Vec best practices (tích hợp SageMaker): Gensim Preprocessing.
✅ Đáp án đúng (Chọn 3):
Các hoạt động đúng là:
- Normalize all words by making the sentence lowercase. (Chuẩn hóa chữ thường để loại bỏ biến thể case, giúp Word2Vec coi "The" và "the" là cùng từ).
- Remove stop words using an English stopword dictionary. (Loại từ dừng như "the", "over" để tập trung vào từ mang nghĩa, cải thiện chất lượng embeddings).
- Tokenize the sentence into words. (Chia câu thành các token từ riêng lẻ, bước cơ bản đầu tiên cho Word2Vec).
Lý do lựa chọn: Những bước này là tiêu chuẩn và repeatable trong preprocessing NLP cho Word2Vec trên AWS SageMaker. Chúng loại bỏ noise cơ bản (case, stopwords), tạo input dạng list tokens sạch, giúp mô hình học context hiệu quả mà không cần can thiệp thủ công phức tạp. SageMaker BlazingText tự động hỗ trợ các bước này khi train Word2Vec mode.
🛠️ Giải thích chi tiết tất cả các phương án (Đúng/Sai)
-
❌ Perform part-of-speech tagging and keep the action verb and the nouns only.
Sai: POS tagging (gán nhãn từ loại như danh từ, động từ) là bước nâng cao cho một số task NLP (như NER), nhưng không cần thiết và không repeatable tự động cho Word2Vec cơ bản. Word2Vec học embeddings từ toàn bộ context, không chỉ verb/noun; việc lọc này có thể làm mất thông tin context, giảm chất lượng model. Trên SageMaker, không khuyến nghị cho preprocessing Word2Vec tiêu chuẩn. -
✅ Normalize all words by making the sentence lowercase.
Đúng: Bước chuẩn hóa case (chuyển hết thành chữ thường) là bắt buộc để tránh coi "Fox" và "fox" là hai từ khác nhau. Điều này đảm bảo dữ liệu nhất quán, repeatable qua script Python (spaCy/NLTK) trên SageMaker Processing. Giúp Word2Vec xây dựng vocabulary sạch, scale tốt với 1 triệu câu. -
✅ Remove stop words using an English stopword dictionary.
Đúng: Stopwords ("the", "over", "lazy") chiếm tỷ lệ lớn nhưng ít giá trị semantic. Loại chúng bằng dictionary chuẩn (NLTK English stopwords) giúp giảm noise, tăng tốc training và cải thiện embeddings. Đây là best practice repeatable trên AWS, tích hợp dễ trong SageMaker scripts. -
❌ Correct the typography on "quck" to "quick.ג€
Sai: Sửa lỗi chính tả thủ công ("quck" → "quick") không repeatable vì phụ thuộc con người hoặc model spell-check phức tạp (như Hunspell), không scale cho 1 triệu câu. Word2Vec có thể học từ lỗi phổ biến như noise thực tế; sửa tự động có thể giới thiệu bias. SageMaker không yêu cầu bước này cho data prep Word2Vec. -
❌ One-hot encode all words in the sentence.
Sai: One-hot encoding tạo vector binary thưa thớt (ví dụ: [1,0,0,...] cho mỗi từ), không phù hợp cho Word2Vec vì model cần continuous embeddings từ context. Đây là kỹ thuật cho classification (như input LSTM), không phải preprocessing text. Sử dụng sẽ làm dữ liệu kém hiệu quả, không khuyến nghị trên SageMaker BlazingText.
Tóm lại, quy trình đúng giúp dữ liệu sẵn sàng cho Word2Vec training trên AWS một cách tự động, scaleable! 🚀
How should a Machine Learning Specialist address this issue for future documents?
- A Convert current documents to SSML with pronunciation tags.
- B Create an appropriate pronunciation lexicon.
- C Output speech marks to guide in pronunciation.
- D Use Amazon Lex to preprocess the text files for pronunciation
Xem giải thích
🧩 Giải thích nội dung câu hỏi
Câu hỏi tập trung vào vấn đề mispronunciation (phát âm sai) của các acronyms (từ viết tắt công ty) khi sử dụng Amazon Polly – dịch vụ Text-to-Speech (TTS) của AWS để chuyển đổi văn bản thành giọng nói cho các thông báo tự động.
✅ Mục tiêu chính: Machine Learning Specialist cần giải quyết vấn đề này cho các tài liệu tương lai (future documents), nghĩa là cần một giải pháp tái sử dụng, scalable và hiệu quả, không chỉ sửa thủ công từng tài liệu hiện tại.
🛠️ Bối cảnh AWS: Amazon Polly hỗ trợ các tính năng tùy chỉnh phát âm qua Lexicons (từ điển phát âm) hoặc SSML, giúp xử lý acronyms như "AWS" phát âm đúng thành "A-Dubya-Es-Dubya-Es" thay vì đọc từng chữ cái. Giải pháp phải phù hợp với best practices của Polly (cập nhật đến 2026, Polly vẫn giữ Lexicons làm tính năng core cho custom pronunciation).
✅ Đáp án đúng và lý do lựa chọn
Đáp án đúng: Create an appropriate pronunciation lexicon.
Lý do chi tiết:
- Lexicon là từ điển phát âm tùy chỉnh (pronunciation lexicon) của Amazon Polly, cho phép định nghĩa chính xác cách phát âm cho acronyms hoặc từ khó (sử dụng IPA – International Phonetic Alphabet).
- ✅ Ưu điểm cho future documents: Lexicon được tạo một lần và tái sử dụng cho tất cả các yêu cầu TTS sau này, tự động áp dụng khi Polly gặp từ trong lexicon mà không cần chỉnh sửa từng document.
- 🛠️ Quy trình: Upload lexicon qua AWS Console/CLI/SDK (XML/PLS format), sau đó chỉ định lexicon khi gọi
SynthesizeSpeechAPI. Đây là best practice khuyến nghị từ AWS cho vấn đề mispronunciation lặp lại. - Không vi phạm giới hạn quota (tối đa 100 lexicons/account/region).
📋 Phân tích tất cả các phương án
-
❌ Convert current documents to SSML with pronunciation tags.
Phương án này sai vì tập trung vào current documents (tài liệu hiện tại), trong khi câu hỏi yêu cầu giải pháp cho future documents. SSML ( tags) yêu cầu chỉnh sửa thủ công từng file, không scalable cho hàng loạt documents. Dù Polly hỗ trợ SSML (InputMode: ssml), nó kém hiệu quả hơn lexicon cho trường hợp tái sử dụng acronyms. -
✅ Create an appropriate pronunciation lexicon.
Đúng như đã giải thích ở trên. Lexicon là giải pháp tối ưu, reusable cho custom pronunciation, đặc biệt với acronyms. AWS docs xác nhận: "Lexicons are ideal for consistently pronouncing domain-specific terms." -
❌ Output speech marks to guide in pronunciation.
Phương án này sai vì SpeechMarks chỉ là metadata output (visemes, words, syllables) từ Polly API (SpeechMarkTypes), dùng để post-process audio (như sync subtitles), không ảnh hưởng đến pronunciation. Nó không sửa mispronunciation mà chỉ cung cấp dấu hiệu thời gian, không giải quyết gốc rễ. -
❌ Use Amazon Lex to preprocess the text files for pronunciation.
Phương án này sai vì Amazon Lex là dịch vụ chatbot/conversational AI, không phải công cụ preprocess text cho TTS. Lex xử lý intents/slots cho voice/text input, không có tính năng pronunciation lexicon hay SSML. Kết hợp Lex + Polly có thể dùng cho bots, nhưng không phù hợp preprocess documents tĩnh.
📘 Tài liệu tham khảo
- AWS Polly Lexicons Guide: https://docs.aws.amazon.com/polly/latest/dg/manage-lexicons.html – Chi tiết tạo/import lexicon (cập nhật 2024-2026).
- Polly Developer Guide – Pronunciation: https://docs.aws.amazon.com/polly/latest/dg/ph.html – So sánh Lexicon vs. SSML.
- API Reference – SynthesizeSpeech: https://docs.aws.amazon.com/polly/latest/dg/API_SynthesizeSpeech.html (LexiconNames parameter).
🛡️ Lưu ý: Dựa trên AWS Well-Architected Framework (Reliability Pillar) cho ML workloads, ưu tiên giải pháp automated/reusable như lexicon.