Ngân hàng đề — AWS Certified CloudOps Engineer Associate
Tìm thấy 585 câu.
Amazon DynamoDB is experiencing a high level of rejected requests and this outage is directly impacting your applications. Your CTO would like to know all the resources that are affected in your AWS Account and how to mitigate them.
Where should you look first?
-
A
In DynamoDB
-
B
In AWS Personal Health Dashboard
-
C
In AWS Organizations
-
D
In AWS Service Health Dashboard
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả tình huống: Amazon DynamoDB đang từ chối một lượng lớn request, sự cố ảnh hưởng trực tiếp tới ứng dụng, và CTO muốn biết tất cả các resource bị ảnh hưởng trong AWS Account của bạn cùng cách khắc phục. Câu hỏi kết thúc bằng "Where should you look first?".
Hai cụm từ quyết định đáp án nằm sát nhau:
- "all the resources that are affected in your AWS Account" — phạm vi là tài khoản của bạn, không phải tình trạng chung của dịch vụ AWS trên toàn thế giới. Đây chính là ranh giới tách hai dashboard nghe rất giống nhau trong danh sách phương án.
- "how to mitigate them" — người hỏi cần hướng dẫn khắc phục, chứ không chỉ cần một bảng trạng thái xanh/đỏ.
Chỉ cần bám vào chữ your AWS Account là đã loại được phương án "toàn cảnh dịch vụ", và bám vào mitigate là loại được những nơi chỉ hiển thị trạng thái mà không đưa khuyến nghị.
✅ Vì sao đáp án đúng là đúng
Đáp án đúng theo tệp là B — AWS Personal Health Dashboard.
Personal Health Dashboard đưa ra cảnh báo và hướng dẫn khắc phục khi AWS đang gặp sự cố có thể ảnh hưởng tới bạn. Điểm khác biệt cốt lõi: trong khi Service Health Dashboard hiển thị tình trạng chung của các dịch vụ AWS, Personal Health Dashboard cho một góc nhìn được cá nhân hoá về hiệu năng và tính sẵn sàng của những dịch vụ AWS đang nằm dưới chính các resource trong tài khoản của bạn.
Nghĩa là nó trả lời được đúng hai thứ CTO hỏi: resource nào của tôi bị ảnh hưởng và làm gì để giảm thiệt hại. Ngoài ra, Personal Health Dashboard còn chủ động thông báo khi AWS có sự kiện có thể tác động tới bạn — giúp nhìn thấy vấn đề nhanh, có hướng xử lý cho sự cố đang diễn ra, và lên kế hoạch cho các thay đổi đã lên lịch như bảo trì phần cứng của AWS. Đó là lý do nó là nơi cần nhìn trước tiên.
❌ Vì sao các phương án còn lại sai
A — In DynamoDB. Đây là phương án dễ bị chọn theo phản xạ, vì sự cố đang xảy ra với DynamoDB. Nhưng vào chính console của DynamoDB chỉ giúp quan sát bản thân dịch vụ đó (bảng, throughput, metric); nó không cho biết toàn bộ resource đang bị ảnh hưởng trong AWS Account của bạn. Nó hỏng đúng ở chữ all the resources của đề: sự cố hạ tầng có thể lan tới nhiều dịch vụ khác, mà nhìn từ một dịch vụ đơn lẻ thì không thấy được bức tranh đó, cũng không có hướng dẫn mitigate ở tầm tài khoản.
C — In AWS Organizations. AWS Organizations là công cụ quản trị tập trung khi môi trường của bạn lớn dần: quản lý billing tập trung, kiểm soát truy cập, tuân thủ và bảo mật, chia sẻ resource giữa các AWS account. Toàn bộ đó là quản trị và tổ chức tài khoản — không phải công cụ theo dõi sự cố. Bạn không thể dùng AWS Organizations để biết vấn đề nào đang ảnh hưởng tới các resource trong tài khoản.
D — In AWS Service Health Dashboard. Đây là phương án gần đúng nhất và là cái bẫy thật của câu hỏi. Service Health Dashboard công bố thông tin cập nhật nhất về trạng thái và tính sẵn sàng của tất cả các dịch vụ AWS, trình bày dạng bảng cho mọi Region mà AWS có mặt (xem tại status.aws.amazon.com). Chỗ nó hỏng: đó là góc nhìn chung cho mọi khách hàng, không cá nhân hoá. Nó có thể cho bạn biết DynamoDB ở một Region đang có vấn đề, nhưng không liệt kê được resource nào trong tài khoản của bạn bị ảnh hưởng và không đưa hướng dẫn mitigate riêng cho bạn — đúng hai thứ mà đề bài yêu cầu.
📌 Điểm cần nhớ
- Personal = phạm vi tài khoản của bạn, có hướng dẫn khắc phục và cảnh báo chủ động. Service = trạng thái chung của mọi dịch vụ AWS cho mọi khách hàng, dạng bảng theo Region. Gặp cặp này trong đề, hãy đọc xem đề hỏi "tài khoản của tôi" hay "AWS nói chung".
- Từ khoá "affected resources in your account" và "how to mitigate" gần như luôn chỉ về Personal Health Dashboard; từ khoá "current status of AWS services" chỉ về Service Health Dashboard.
- Console của chính dịch vụ đang lỗi (ở đây là DynamoDB) chỉ cho góc nhìn một dịch vụ; nó không phải nơi tổng hợp ảnh hưởng ở tầm tài khoản.
- AWS Organizations thuộc nhóm quản trị nhiều tài khoản (billing, quyền truy cập, tuân thủ, chia sẻ resource) — nếu đề hỏi về sự cố hay tình trạng dịch vụ thì đây gần như chắc chắn là phương án nhiễu.
You host a forum for law questions and per your country's law, you must store all the archives of conversations (about 1 TB) every week for 7 years. These archives must not be tampered with in any way, and you must prove you have set enough controls around your data protection.
What should you do?
-
A
Store the archives in EBS and use Linux file system protection on the files
-
B
Store the archives in AWS Artifact and enable compliance monitoring
-
C
Store the archives in Glacier and set up a Vault Lock Policy for WORM access
-
D
Store the archives in S3 and set up a bucket policy, enable versioning and MFA-Delete
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một diễn đàn hỏi đáp pháp luật phải lưu trữ toàn bộ lịch sử hội thoại — khoảng 1 TB mỗi tuần, giữ trong 7 năm — theo yêu cầu của luật pháp quốc gia.
Cụm từ quyết định nằm ở hai chỗ:
- "must not be tampered with in any way" — dữ liệu phải bất biến tuyệt đối, không ai được sửa hay ghi đè, kể cả người có quyền quản trị.
- "you must prove you have set enough controls around your data protection" — không chỉ cần dữ liệu an toàn trên thực tế, mà còn phải chứng minh được với cơ quan kiểm tra rằng chính sách bảo vệ đó đã được khoá lại và không thể gỡ.
Vế thứ hai mới là ràng buộc phân biệt các phương án. Nhiều cách lưu trữ giữ được dữ liệu an toàn "nếu không ai cố tình phá", nhưng chỉ có một cơ chế cho phép khoá vĩnh viễn chính sách để bằng chứng tuân thủ đứng vững. Thêm nữa, đây là dữ liệu lưu trữ dài hạn, ít khi đọc lại — đúng đặc tính của archive storage.
✅ Vì sao đáp án đúng là đúng
C — Store the archives in Glacier and set up a Vault Lock Policy for WORM access.
Trong Glacier, dữ liệu được lưu dưới dạng archive, và các archive gom lại trong vault. Glacier Vault Lock cho phép gắn một vault lock policy lên từng vault để áp đặt các kiểm soát tuân thủ, trong đó có WORM (write once read many) — ghi một lần, đọc nhiều lần, không sửa được.
Điểm mấu chốt: sau khi policy được lock, nó không còn sửa được nữa, kể cả bởi chính chủ tài khoản. Đây chính là thứ trả lời cho vế "phải chứng minh được": kiểm toán viên nhìn vào vault lock policy đã khoá là thấy ngay các kiểm soát này không thể bị gỡ đi sau lưng. Kết hợp với việc Glacier là lớp lưu trữ archive dành cho dữ liệu giữ nhiều năm, phương án này khớp cả yêu cầu bất biến lẫn yêu cầu chứng minh tuân thủ.
❌ Vì sao các phương án còn lại sai
D — S3 + bucket policy + versioning + MFA-Delete (phương án gần đúng nhất, và là bẫy chính)
Nghe rất hợp lý: versioning giữ lại bản cũ, MFA-Delete chặn xoá bừa. Nhưng nó hỏng ở chỗ: versioning không ngăn được việc ghi đè. Ai đó vẫn có thể ghi lên object và tạo ra một version mới — tức là object hiện hành đã bị thay đổi, dù bản cũ còn nằm đâu đó. Đề đòi dữ liệu "không bị tamper theo bất kỳ cách nào", nên việc một object có thể biến thành version mới là đã vi phạm. Còn MFA-Delete chỉ bảo vệ trước thao tác xoá vĩnh viễn, không đụng gì tới chuyện ghi đè. Ngoài ra bucket policy sửa được bất cứ lúc nào, nên nó không phải một bằng chứng tuân thủ đã bị khoá.
A — EBS + Linux file system protection
Đây là quyền của hệ điều hành (chmod, chown, thuộc tính file). Bất kỳ ai có quyền root trên instance đều gỡ được, và không có gì để trình ra cho kiểm toán viên như một compliance control ở tầng dịch vụ. Nó là biện pháp trong phạm vi một máy chủ, không phải cơ chế enforce tuân thủ trên dữ liệu lưu trữ dài hạn.
B — AWS Artifact + compliance monitoring
Sai ngay ở bản chất dịch vụ. AWS Artifact là cổng tự phục vụ để tải tài liệu tuân thủ và hợp đồng của AWS (báo cáo audit, thoả thuận) — nó cho bạn xem bằng chứng về việc AWS tuân thủ, chứ không phải nơi lưu dữ liệu của bạn. Không thể đẩy 1 TB archive mỗi tuần vào đó, và cũng không dùng nó để áp kiểm soát lên dữ liệu của mình được.
📌 Điểm cần nhớ
- Đề nhắc tới WORM / immutable / "must not be tampered with" kèm yêu cầu giữ nhiều năm → nghĩ tới Glacier Vault Lock. Điểm bán hàng của nó là policy khoá xong không sửa được nữa.
- Versioning ≠ bất biến. Versioning cho phép ghi đè rồi sinh version mới; MFA-Delete chỉ chặn xoá vĩnh viễn. Cả hai đều không đáp ứng yêu cầu "không được thay đổi bằng bất kỳ cách nào".
- Phân biệt "bảo vệ được dữ liệu" với "chứng minh được là đã bảo vệ". Cái gì admin sửa lại được bất cứ lúc nào (bucket policy, quyền file Linux) thì không dùng làm bằng chứng tuân thủ.
- AWS Artifact không phải kho lưu dữ liệu — nó là nơi lấy tài liệu tuân thủ của chính AWS. Thấy nó xuất hiện trong phương án lưu trữ thì gần như chắc chắn là distractor.
In order to improve the read performance of the files stored in S3, you have decided to deploy it using CloudFront. As part of this deployment, you would like to ensure that only CloudFront is allowed to access the S3 bucket files.
How can you achieve that?
-
A
Using an Origin Access Identity and a bucket policy
-
B
Attaching a security group to S3 and CloudFront and only allow incoming traffic from CloudFront using the security group rules
-
C
Attaching an IAM role to CloudFront and defining a bucket policy to only allow this role
-
D
Encrypt all your files using a KMS key that only CloudFront can access
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một tình huống rất quen: file nằm trong S3, đặt CloudFront phía trước để cải thiện tốc độ đọc. Nhưng cụm từ quyết định đáp án không phải "improve the read performance" — đó chỉ là bối cảnh. Cụm quyết định là:
"ensure that only CloudFront is allowed to access the S3 bucket files"
Nghĩa là: sau khi triển khai xong, người dùng phải không gọi thẳng URL của S3 bucket được nữa, mọi đường vào đều phải đi qua CloudFront. Đây là bài toán kiểm soát quyền truy cập vào origin, không phải bài toán mã hoá, không phải bài toán lọc lưu lượng mạng.
Khi đã đóng khung như vậy thì phải hỏi: S3 nhận diện "ai đang gọi" bằng cái gì? Câu trả lời là danh tính (principal) trong bucket policy — S3 là dịch vụ ở tầng API, quyền được quyết định bằng policy chứ không bằng thiết bị mạng. Ba phương án sai đều trượt vì chọn nhầm cơ chế.
✅ Vì sao đáp án đúng là đúng
A — Using an Origin Access Identity and a bucket policy.
Origin Access Identity (OAI) là một người dùng CloudFront đặc biệt do bạn tạo ra rồi gắn vào distribution. Quy trình đúng gồm hai bước, và cả hai đều cần thiết:
- Tạo OAI và associate nó với CloudFront distribution đang trỏ tới bucket đó.
- Sửa bucket policy để cho phép chính OAI này đọc object, đồng thời đảm bảo người dùng không dùng URL trực tiếp tới S3 mà lấy được file.
Sau hai bước đó, mỗi request CloudFront gửi tới S3 đều được ký dưới danh tính OAI, nên S3 chấp nhận. Còn request bất kỳ từ Internet gõ thẳng vào endpoint của bucket thì không mang danh tính đó, bucket policy từ chối. Đây đúng là điều đề bài yêu cầu: chỉ CloudFront truy cập được file trong bucket.
Điểm mấu chốt: OAI là một principal mà bucket policy viết ra được, nên nó khớp đúng với cách S3 phân quyền.
❌ Vì sao các phương án còn lại sai
B — Attaching a security group to S3 and CloudFront, chỉ cho traffic từ CloudFront đi vào.
Sai ngay ở tiền đề kỹ thuật: không gắn được security group vào S3, cũng không gắn được vào CloudFront. Security group là công cụ của tầng VPC, dùng cho những thứ có network interface như EC2 instance. S3 và CloudFront là dịch vụ quản trị (managed) truy cập qua endpoint công khai, không có ENI cho bạn buộc security group vào. Đây là một distractor kinh điển — nghe rất "mạng máy tính" và nếu quen tư duy firewall thì dễ chọn nhầm.
C — Attaching an IAM role to CloudFront và viết bucket policy chỉ cho role đó.
Đây là phương án gần đúng nhất, nên cần chỉ rõ nó hỏng ở đâu. Ý tưởng "một danh tính + bucket policy giới hạn theo danh tính đó" là hoàn toàn đúng hướng — đó chính là điều OAI làm. Chỗ hỏng nằm ở phần "attaching an IAM role to CloudFront": CloudFront distribution không phải là thứ bạn gắn IAM role vào được. Nó không phải compute resource kiểu EC2 hay Lambda để nhận execution role rồi tự lấy credentials tạm thời. Cơ chế danh tính mà CloudFront dùng khi gọi tới S3 origin chính là OAI, chứ không phải IAM role. Nói cách khác, C mô tả đúng hình dạng của giải pháp nhưng gọi sai tên cơ chế, và cơ chế đó không tồn tại.
D — Encrypt all your files bằng KMS key mà chỉ CloudFront truy cập được.
Phương án này nhầm mục tiêu: mã hoá giải quyết chuyện bảo mật dữ liệu ở trạng thái nghỉ, không giải quyết chuyện ai được gọi API vào bucket. Nếu bucket vẫn mở, người ta vẫn gọi được S3 trực tiếp — đề bài yêu cầu chặn đúng điều đó mà D không chặn.
Có tồn tại kiến trúc phục vụ nội dung mã hoá SSE-KMS qua CloudFront (dùng thêm Lambda@Edge để ký request), nhưng đó là câu chuyện khác, giải bài toán khác. Nó không thay thế được việc dùng OAI + bucket policy để hạn chế truy cập vào origin.
📌 Điểm cần nhớ
- Chặn truy cập trực tiếp vào S3 origin = OAI + bucket policy. Nhớ cả hai vế: tạo OAI và gắn vào distribution là chưa đủ, phải sửa bucket policy cho phép OAI đó thì mới có tác dụng.
- Security group không gắn được vào S3 hay CloudFront. Hễ thấy phương án nói tới security group cho dịch vụ managed không nằm trong VPC thì loại ngay — đây là distractor lặp đi lặp lại trong đề AWS.
- CloudFront distribution không nhận IAM role. Đừng suy diễn từ mô hình execution role của EC2/Lambda sang mọi dịch vụ; mỗi dịch vụ có cách mang danh tính riêng.
- Phân biệt "mã hoá" với "phân quyền". KMS bảo vệ dữ liệu ở trạng thái nghỉ; muốn giới hạn ai gọi được thì phải sửa policy. Đề hỏi "only X is allowed to access" là đang hỏi về phân quyền.
You distribute a monthly raw data extract of your public forum's discussions that is about 10TB each month. Currently, the archive is distributed through an EFS drive, that is mounted on all your EC2 instances. Customers retrieve the file through the load balancer you have. This solution is costing you a lot of money and forces you to tremendously scale on the 1st of each month as people all try to retrieve the file at the same time.
What can you do to improve the situation?
-
A
Enable enhanced networking between EC2 and ALB
-
B
Enable static file caching on the ALB
-
C
Store the files in S3 and distribute them using a CloudFront distribution instead
-
D
Store the files on instance stores instead, so you don't need to use EFS anymore
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một tình huống rất cụ thể: mỗi tháng phát hành một bản trích xuất dữ liệu thô khoảng 10TB, hiện đặt trên EFS mount vào tất cả EC2 instance, và khách hàng tải file qua load balancer. Hai triệu chứng được nêu thẳng: tốn rất nhiều tiền và phải scale kinh khủng vào ngày mùng 1 khi mọi người cùng lúc tải file.
Cụm từ quyết định đáp án nằm ở bản chất của dữ liệu: đây là file tĩnh, không đổi, dung lượng lớn, phân phát cho nhiều người ở nhiều nơi. Không có chỗ nào trong đề nói dữ liệu cần được nhiều EC2 instance ghi đồng thời hay xử lý theo kiểu file system — nó chỉ đơn thuần là tải xuống. Khi một khối dữ liệu tĩnh được phục vụ cho hàng loạt người dùng, việc đưa nó qua chuỗi EFS → EC2 → load balancer là kiến trúc sai từ gốc: bạn đang trả tiền lưu trữ theo mức file system, trả tiền compute chỉ để đóng vai người bưng file, và tự đặt vào tình thế phải scale EC2 theo lưu lượng tải xuống.
Câu hỏi thuộc Domain 6: Cost and Performance Optimization, nên đáp án phải giải quyết đồng thời cả hai vế: chi phí và khả năng chịu tải đột biến.
✅ Vì sao đáp án đúng là đúng
C — Store the files in S3 and distribute them using a CloudFront distribution instead.
Đáp án này xử lý trọn cả hai triệu chứng của đề:
- Về chi phí lưu trữ: giá mỗi GB mỗi tháng của S3 thấp hơn đáng kể so với EFS. Với khối lượng 10TB mỗi tháng, khoảng chênh này là con số rất lớn. EFS được thiết kế cho file system chia sẻ có ngữ nghĩa POSIX — trả giá đó cho một file chỉ để tải xuống là lãng phí.
- Về việc phải scale ngày mùng 1: khi đặt file trên S3 và phát qua CloudFront, EC2 và load balancer hoàn toàn ra khỏi đường đi của lưu lượng tải xuống. Không còn instance nào phải scale theo số người tải, vì không instance nào tham gia vào việc phục vụ file nữa.
- Về hiệu năng và chi phí truyền dữ liệu: CloudFront là CDN, cache nội dung ở edge location gần người dùng. Đợt tải dồn vào mùng 1 chủ yếu được phục vụ từ cache thay vì đọc lại từ origin, và theo thiết kế thì đưa dữ liệu ra qua CloudFront có thể rẻ hơn so với phát trực tiếp từ S3 tới người dùng. AWS khuyến nghị đúng mô hình S3 + CloudFront cho nội dung tĩnh.
❌ Vì sao các phương án còn lại sai
A — Enable enhanced networking between EC2 and ALB. Enhanced networking là thật, nhưng nó không phải là thứ bật "giữa EC2 và ALB". Đây là tính năng ở tầng instance: dùng SR-IOV (single root I/O virtualization) để network interface của EC2 đạt throughput cao hơn và tốn ít CPU hơn so với network interface ảo hoá kiểu truyền thống, và chỉ có trên một số loại instance được hỗ trợ. Không có khái niệm "bật enhanced networking cho cặp EC2–ALB". Kể cả nếu hiểu theo hướng có lợi nhất là tăng throughput mạng cho instance, nó vẫn không đụng gì tới chi phí lưu trữ EFS và cũng không gỡ được việc phải scale EC2 khi tất cả khách cùng tải.
B — Enable static file caching on the ALB. Đây là distractor thuần: ALB không có chức năng cache nội dung tĩnh. ALB là load balancer tầng 7 làm nhiệm vụ định tuyến request tới target, không phải cache server và cũng không phải CDN. Phương án này nghe hợp lý vì đúng hướng tư duy (cache nội dung tĩnh là ý đúng), nhưng nó gán chức năng đó cho sai dịch vụ — dịch vụ làm việc này trong danh sách là CloudFront.
D — Store the files on instance stores instead, so you don't need to use EFS anymore. Đây là phương án gần đúng nhất về mặt chi phí lưu trữ, nhưng hỏng ở đặc tính của instance store: nó gắn vật lý vào từng EC2 instance cụ thể, không phải kho lưu trữ chia sẻ như EFS. Đề nói rõ hiện tại EFS được mount trên tất cả các instance, tức là bài toán cần dữ liệu dùng chung. Chuyển sang instance store thì hoặc phải nhân bản 10TB lên từng instance, hoặc mỗi instance chỉ phục vụ được phần dữ liệu của riêng nó — cả hai đều không dùng được. Chưa kể phương án này vẫn để EC2 và load balancer nằm trên đường đi của lưu lượng, nên vấn đề scale ngày mùng 1 còn nguyên.
📌 Điểm cần nhớ
- Nội dung tĩnh phát cho nhiều người đọc = S3 + CloudFront. Đây là mẫu kiến trúc mặc định; thấy đề mô tả file tĩnh đang được phục vụ qua EC2 hoặc load balancer thì gần như chắc chắn hướng đi là bỏ compute ra khỏi đường phân phối.
- Chọn lớp lưu trữ theo cách dữ liệu được truy cập, không theo thói quen. EFS đáng tiền khi cần file system chia sẻ có ngữ nghĩa POSIX cho nhiều instance cùng đọc ghi; chỉ để tải xuống thì S3 vừa rẻ hơn nhiều vừa hợp mô hình truy cập hơn.
- CDN vừa là câu trả lời về hiệu năng, vừa là câu trả lời về chi phí. Cache ở edge hấp thụ đợt tải dồn nên không phải scale hạ tầng, đồng thời chi phí đưa dữ liệu ra qua CloudFront có thể thấp hơn phát thẳng từ S3.
- Cảnh giác với phương án gán đúng chức năng cho sai dịch vụ. "Static file caching on the ALB" là ý tưởng đúng đặt nhầm chỗ. Khi một phương án nghe hợp lý, hãy tự hỏi dịch vụ đó có thật sự làm được việc đó không, và nhớ rằng instance store không bao giờ là kho lưu trữ chia sẻ.
How should MFA-Delete be enabled on an S3 bucket?
-
A
Using the root account and the AWS Console
-
B
Using the root account and the AWS CLI
-
C
Using an admin IAM user and the AWS Console
-
D
Using an admin IAM user and the AWS CLI
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề hỏi: bật MFA-Delete trên một S3 bucket thì phải làm bằng cách nào? Cả bốn phương án đều là tổ hợp của đúng hai biến số:
- Ai thực hiện: root account hay admin IAM user
- Bằng công cụ gì: AWS Console hay AWS CLI
Nên cụm từ quyết định nằm ngay ở tên tính năng: "MFA-Delete" — chứ không phải "versioning". Đây là bẫy quen thuộc của câu này. Rất nhiều người học nhớ rằng "bất kỳ IAM user nào có quyền phù hợp đều bật được versioning trên bucket", rồi đem nguyên trí nhớ đó áp sang MFA-Delete. Hai thứ đó liên quan chặt với nhau (MFA-Delete chỉ có nghĩa trên bucket đã bật versioning) nhưng điều kiện để bật chúng thì khác nhau hoàn toàn. Đọc đề mà không tách bạch được "versioning" với "MFA-Delete" thì cả bốn phương án đều trông hợp lý như nhau.
✅ Vì sao đáp án đúng là đúng
Đáp án đúng theo tệp là B — Using the root account and the AWS CLI.
MFA-Delete là một lớp bảo vệ thêm cho bucket: khi bật, nó bắt buộc phải có thêm yếu tố xác thực MFA cho hai thao tác nhạy cảm nhất trên bucket đã bật versioning:
- Đổi trạng thái versioning của bucket (ví dụ tắt hoặc tạm dừng versioning)
- Xoá vĩnh viễn một object version
Vì đây là chốt chặn cuối cùng chống xoá dữ liệu, AWS siết chặt cả hai đầu:
- Chỉ bucket owner — tức là root account — mới bật được MFA-Delete. Một IAM user, kể cả gắn quyền admin, cũng không làm được việc này.
- Chỉ bật được qua AWS CLI, không có trong AWS Console.
Phương án B là tổ hợp duy nhất khớp cả hai ràng buộc đó, nên nó đúng.
Đáng chú ý thêm để phân biệt về sau: versioning thì bucket owner và các IAM user được cấp quyền đều bật được, và bật được qua Console. Chính sự khác biệt này là thứ mà câu hỏi đang kiểm tra.
❌ Vì sao các phương án còn lại sai
A — Using the root account and the AWS Console: đây là phương án gần đúng nhất, và nó là bẫy chính. Chọn đúng chủ thể (root account) nhưng sai công cụ. AWS Console không phơi ra tuỳ chọn bật MFA-Delete; trong màn hình properties của bucket bạn bật được versioning nhưng không bật được MFA-Delete. Ai nhớ đúng "phải là root" mà không nhớ vế "chỉ qua CLI" sẽ dừng lại ở A.
C — Using an admin IAM user and the AWS Console: sai cả hai vế. Sai chủ thể vì admin IAM user không phải bucket owner, không có thẩm quyền bật MFA-Delete dù policy có rộng đến đâu. Sai luôn công cụ vì Console không có thao tác này. Phương án này thường được chọn bởi người đang nhớ nhầm sang quy tắc của versioning — nơi mà IAM user + Console thật sự là cách làm bình thường.
D — Using an admin IAM user and the AWS CLI: chọn đúng công cụ (CLI) nhưng sai chủ thể. Đây là phương án dễ đánh lừa người quen thực hành theo nguyên tắc "không dùng root cho việc thường ngày, tạo IAM user admin thay thế". Nguyên tắc đó đúng trong phần lớn tình huống vận hành, nhưng MFA-Delete nằm trong nhóm nhỏ các thao tác bắt buộc phải là root account, không uỷ quyền được cho IAM user. Quyền admin trong IAM không nâng được một IAM user lên thành bucket owner.
📌 Điểm cần nhớ
- MFA-Delete: chỉ root account, chỉ AWS CLI. Hai ràng buộc đi cùng nhau — nhớ thiếu một vế là rơi vào bẫy A hoặc D.
- Đừng lẫn versioning với MFA-Delete. Versioning thì IAM user được cấp quyền cũng bật được và bật qua Console được; MFA-Delete thì không. MFA-Delete cần bucket đã bật versioning nhưng điều kiện thực hiện thì chặt hơn hẳn.
- MFA-Delete bảo vệ đúng hai thao tác: đổi trạng thái versioning của bucket, và xoá vĩnh viễn một object version. Nó không chặn thao tác ghi hay đọc thông thường.
- Có một nhóm nhỏ thao tác trong AWS mà quyền admin của IAM user không thay thế được root account. Gặp câu hỏi dạng "root vs IAM admin", hãy kiểm tra xem thao tác đó có thuộc nhóm này không thay vì mặc định chọn IAM user theo thói quen bảo mật thường ngày.
Your accounting application on an EC2 instance has the tendency to sometimes go into a panic and then the CPU Utilization of your EC2 instance runs at 100% for a long duration. When this happens, someone has to manually intervene and restart your application for it to work properly again.
How can you automate this in the most efficient way?
-
A
Create a CloudWatch Event when CPU Utilization reaches 100% and trigger an EC2 reboot action
-
B
Create a CloudWatch Alarm when CPU Utilization reaches 100% for 3 periods of 5 minutes and trigger an EC2 reboot action
-
C
Invoke an AWS Lambda function via a cron job that checks for the metric every minute and restarts the instance if a problem is found
-
D
Put your instance in an ASG and behind an ELB and enable ELB health check, so that the instance gets terminated upon problems and a new one gets created
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một ứng dụng kế toán chạy trên EC2 instance, thỉnh thoảng bị "panic" và đẩy CPU Utilization lên 100% trong thời gian dài. Cách chữa duy nhất đang dùng là có người vào restart thủ công. Câu hỏi: tự động hoá việc này theo cách hiệu quả nhất ("in the most efficient way").
Hai cụm từ quyết định đáp án:
- "CPU Utilization runs at 100% for a long duration" — vấn đề không phải một đỉnh nhọn tức thời mà là trạng thái kéo dài. Thứ dùng để phát hiện phải là một cơ chế biết đo một metric qua nhiều chu kỳ liên tiếp rồi mới hành động, chứ không phải thứ phản ứng ngay lần đầu chạm ngưỡng.
- "most efficient way" — trong ngữ cảnh trắc nghiệm, "efficient" nghĩa là ít thành phần phải dựng và vận hành nhất, ít chi phí phát sinh nhất. Đây là cụm loại bỏ những phương án tuy có chạy được nhưng phải thêm hạ tầng hoặc thêm mã tự viết.
Cộng lại: cần một CloudWatch Alarm trên metric CPUUtilization với điều kiện nhiều chu kỳ, gắn thẳng EC2 reboot action.
✅ Vì sao đáp án đúng là đúng
B — Create a CloudWatch Alarm when CPU Utilization reaches 100% for 3 periods of 5 minutes and trigger an EC2 reboot action.
CloudWatch Alarm sinh ra đúng để làm việc này. Với alarm actions, alarm có thể tự động stop, terminate, reboot hoặc recover một EC2 instance mà không cần bất cứ mã nào do bạn viết: stop/terminate để tiết kiệm khi instance không còn cần chạy, còn reboot và recover để khởi động lại instance hoặc đưa nó sang phần cứng mới khi có sự cố hệ thống.
Phần "3 periods of 5 minutes" khớp chính xác với chữ long duration trong đề: alarm chỉ chuyển sang trạng thái ALARM khi điều kiện đúng liên tục qua đủ số chu kỳ đánh giá, nên một đỉnh CPU thoáng qua của tác vụ hợp lệ sẽ không kích hoạt reboot oan. Đây chính là chỗ CloudWatch Alarm hơn hẳn một phép kiểm "chạm 100% là làm ngay".
Và toàn bộ giải pháp gọn trong một tài nguyên duy nhất: một alarm. Không thêm hàm, không thêm load balancer, không thêm chi phí hạ tầng — thoả cụm most efficient.
Điểm hay bị gài trong đề thi: một CloudWatch Alarm action chỉ nhận được các đích sau — gửi thông báo tới một Amazon SNS topic, thực hiện một Amazon EC2 action, một Auto Scaling action, hoặc tạo một Systems Manager OpsItem. Nhớ đúng danh sách này là loại được nhiều phương án bẫy.
❌ Vì sao các phương án còn lại sai
A — Create a CloudWatch Event when CPU Utilization reaches 100% and trigger an EC2 reboot action. Đây là phương án gần đúng nhất và cũng là bẫy chính, vì phần "trigger an EC2 reboot action" nghe y hệt đáp án đúng. Chỗ hỏng nằm ở từ Event: metric CPUUtilization của một EC2 instance là dữ liệu được CloudWatch Alarm tiêu thụ trực tiếp để đặt ngưỡng, chứ không dùng để phát sinh một CloudWatch Event. Sai công cụ ngay từ bước phát hiện. Ngoài ra phương án này còn bỏ mất ràng buộc nhiều chu kỳ — nó nói "reaches 100%" chứ không nói kéo dài bao lâu, tức là không bám vào chữ long duration của đề.
C — Invoke an AWS Lambda function via a cron job that checks for the metric every minute and restarts the instance if a problem is found. Về mặt kỹ thuật thì làm được, nhưng nó là giải pháp lãng phí và thiếu tinh tế: bạn phải tự viết hàm Lambda, tự dựng lịch chạy, tự đọc metric, tự xử lý lỗi và tự bảo trì đoạn mã đó — để làm lại đúng thứ mà CloudWatch Alarm đã cung cấp sẵn. Kiểu kiểm tra theo nhịp cố định còn chạy cả những lúc chẳng có gì xảy ra. Với tiêu chí most efficient của đề, dùng alarm action luôn thắng.
D — Put your instance in an ASG and behind an ELB and enable ELB health check, so that the instance gets terminated upon problems and a new one gets created. Phương án này giải quyết được vấn đề nhưng bằng cách đắt và phức tạp hơn hẳn: thêm ELB là thêm chi phí, và ghép ELB với ASG làm kiến trúc rắc rối hơn cho một nhu cầu vốn chỉ là "khởi động lại ứng dụng". Đề chỉ nói về một instance đang cần được restart, không nói gì tới nhu cầu phân phối tải hay chạy nhiều instance. Đây là kiểu đáp án "kiến trúc đẹp nhưng vượt yêu cầu" — trong câu hỏi có chữ efficient, nó là đáp án sai.
📌 Điểm cần nhớ
- CloudWatch Alarm có thể tự stop / terminate / reboot / recover một EC2 instance — không cần Lambda, không cần mã tự viết. Thấy nhu cầu "tự động khởi động lại instance khi metric vượt ngưỡng", nghĩ tới alarm action trước tiên.
- Học thuộc danh sách đích hợp lệ của một alarm action: SNS topic, EC2 action, Auto Scaling action, Systems Manager OpsItem. Đề rất hay chèn một đích không nằm trong danh sách này để gài.
- Metric ⇒ Alarm, không phải Event. Một metric như
CPUUtilizationđược đánh giá bằng CloudWatch Alarm; đừng để chữ "trigger an EC2 reboot action" ở vế sau che mất chỗ sai ở vế đầu. - Chi tiết "for N periods" trong phương án không phải chữ thừa — nó là thứ khớp với "kéo dài" trong đề và là thứ phân biệt cảnh báo thật với đỉnh nhọn thoáng qua.
- Khi đề nhấn "most efficient", ưu tiên phương án ít thành phần và ít chi phí nhất. Giải pháp thêm ELB, ASG hay hàm tự viết thường là đáp án sai dù nó vẫn chạy được.
A company manages multiple applications on a fleet of Amazon EC2 instances. The company is looking at automating the process of patch management for all the instances that includes OS updates, application updates and security updates.
Which service/tool is the right fit for this requirement?
-
A
Patch Fleet, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
B
Patch Manager, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
C
Fleet Manager, a capability of AWS Systems Manager, can be used to automate patch management and OS updates for all the instances at one go
-
D
OS updates and patch management are responsibilities of AWS as per AWS Shared Responsibility model and does not need customer inputs
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một công ty chạy nhiều ứng dụng trên một đội EC2 instances, và muốn tự động hoá quá trình patch management cho toàn bộ instances — bao gồm OS updates, application updates và security updates.
Cụm từ quyết định đáp án là "automating the process of patch management" kèm phạm vi "OS updates, application updates and security updates". Ba phương án đầu đều gắn nhãn "a capability of AWS Systems Manager" nên nghe rất giống nhau; điều phân biệt chúng là tên capability nào thực sự làm việc vá lỗi, chứ không phải công nghệ nào khác. Phương án D thì tấn công từ hướng khác: nó phủ nhận luôn nhu cầu, dựa vào AWS Shared Responsibility Model — nên phải xác định rõ ranh giới trách nhiệm với EC2.
✅ Vì sao đáp án đúng là đúng
Đáp án đúng là B — Patch Manager, a capability of AWS Systems Manager.
Patch Manager là capability được thiết kế đúng cho việc này: nó tự động hoá quá trình vá managed instances với cả security-related updates lẫn các loại update khác. Patch Manager áp dụng patch cho operating system và cả application (trên Windows Server, phần application giới hạn ở các ứng dụng do Microsoft phát hành) — khớp trọn vẹn ba nhóm mà đề liệt kê.
Ngoài ra Patch Manager còn:
- Cài Service Packs trên Windows instances và thực hiện minor version upgrades trên Linux instances.
- Vá cả fleet EC2 instances lẫn on-premises servers và VMs, phân loại theo operating system type — hỗ trợ nhiều bản phân phối như Amazon Linux, Amazon Linux 2, CentOS, Debian Server, macOS, Oracle Linux, RHEL, SUSE Linux Enterprise Server, Ubuntu Server và Windows Server.
- Cho phép scan để chỉ xem báo cáo các patch còn thiếu, hoặc scan rồi tự động cài toàn bộ patch còn thiếu.
Đúng tinh thần "for all the instances at one go" mà đề yêu cầu: một cơ chế duy nhất, tự động, phủ cả đội máy.
❌ Vì sao các phương án còn lại sai
A — "Patch Fleet, a capability of AWS Systems Manager": Không tồn tại capability nào tên là Patch Fleet. Đây là distractor thuần tuý, ghép hai từ quen thuộc ("Patch" của Patch Manager và "Fleet" của Fleet Manager) để tạo ra một cái tên nghe có vẻ hợp lý. Phần mô tả phía sau chép y hệt đáp án đúng, nên nếu chỉ đọc lướt phần mô tả mà bỏ qua tên dịch vụ thì rất dễ chọn nhầm.
C — "Fleet Manager, a capability of AWS Systems Manager": Đây là capability có thật, nên nó là phương án gần đúng nguy hiểm nhất. Nhưng vai trò của Fleet Manager là một giao diện người dùng hợp nhất (unified UI) để quản lý từ xa server fleet chạy trên AWS hoặc on-premises: xem health và performance status của toàn bộ fleet từ một console, và thu thập dữ liệu từ từng instance để xử lý sự cố và làm các tác vụ quản lý thông thường — xem nội dung thư mục và tệp, quản lý Windows registry, quản lý user của hệ điều hành, v.v. Nó thiên về quan sát và thao tác thủ công từ console, không phải cơ chế tự động hoá việc vá. Chỗ hỏng của C là ở chữ "automate patch management": đó không phải việc của Fleet Manager.
D — "OS updates and patch management are responsibilities of AWS as per AWS Shared Responsibility model": Sai ở việc đặt nhầm ranh giới trách nhiệm. Theo AWS Shared Responsibility Model, khách hàng triển khai một EC2 instance chịu trách nhiệm quản lý guest operating system — bao gồm cả updates và security patches — cùng với phần mềm ứng dụng hoặc tiện ích do khách hàng cài lên instance, và cấu hình security group trên mỗi instance. Nói cách khác, chính vì trách nhiệm này thuộc về khách hàng nên nhu cầu trong đề mới hợp lệ, và mới cần đến Patch Manager.
📌 Điểm cần nhớ
- Patch Manager = tự động hoá patch cho OS và application, quét ra patch còn thiếu và cài chúng, làm được trên cả EC2 lẫn on-premises, phân nhóm theo operating system type. Thấy đề nói "automate patching" thì nghĩ ngay tới nó.
- Fleet Manager = UI hợp nhất để quản lý và troubleshoot từ xa (health/performance, xem file, Windows registry, OS users). Quản lý ≠ vá tự động — đừng nhầm hai capability này chỉ vì cùng nằm trong AWS Systems Manager.
- Với EC2, guest OS, patch, ứng dụng khách cài và cấu hình security group đều là trách nhiệm của khách hàng theo Shared Responsibility Model. Mọi phương án nói "AWS lo hết, khách hàng không cần làm gì" cho EC2 đều sai.
- Khi ba phương án có phần mô tả gần như giống hệt nhau, ràng buộc phân biệt nằm ở chính cái tên dịch vụ — hãy kiểm tra tên đó có thật hay không (như "Patch Fleet" là tên bịa).
You are in S3 and have deleted all the files in it. As you can see, the bucket is empty:
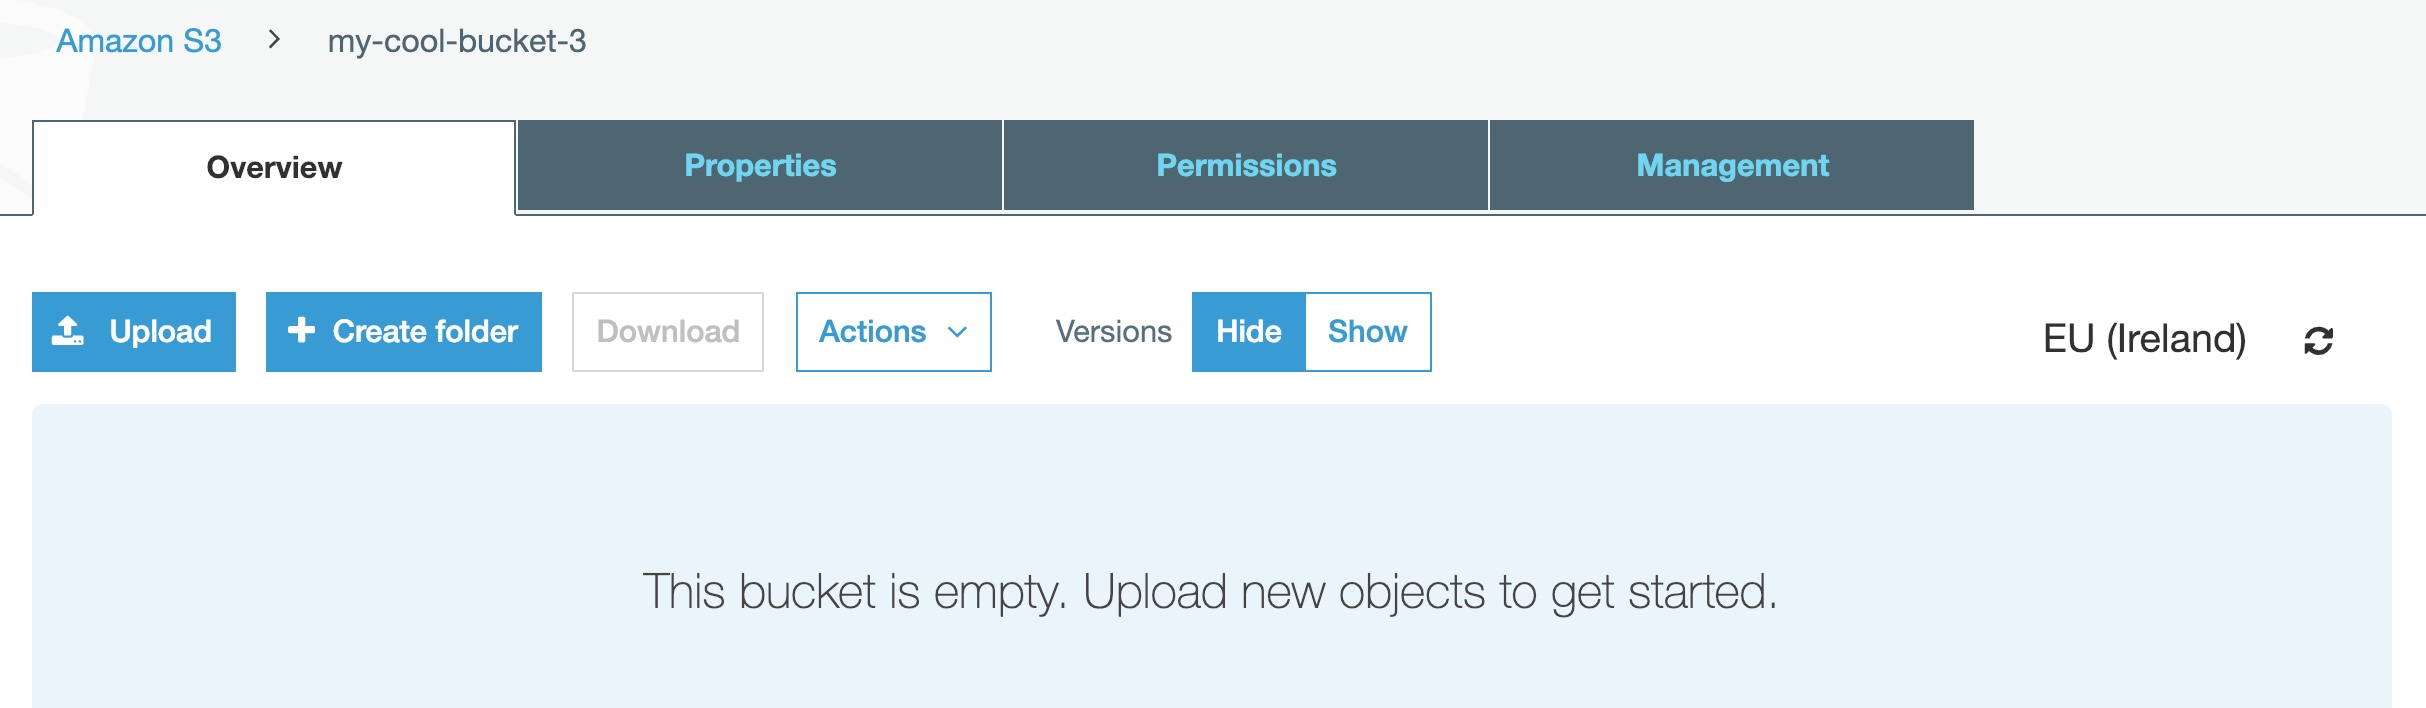
You have tried to delete the bucket afterward and it fails with an error saying the bucket is not empty.
What's the issue?
-
A
Some files are in Glacier
-
B
S3 is eventually consistent. Wait two minutes and retry, it will work then
-
C
S3 versioning is enabled and delete markers are still present in the bucket
-
D
An S3 bucket policy is set up and it prevents bucket deletion
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một tình huống vận hành rất cụ thể: bạn đã xoá hết file trong một S3 bucket, giao diện hiển thị bucket rỗng, nhưng khi xoá bucket thì AWS báo lỗi "the bucket is not empty".
Cụm từ quyết định đáp án là chính thông báo lỗi "bucket is not empty" kết hợp với việc giao diện lại cho thấy bucket rỗng. Hai điều này chỉ mâu thuẫn khi nào? Khi trong bucket vẫn còn object mà chế độ xem mặc định không hiển thị. Trong S3, thứ duy nhất khớp mô tả đó là các version cũ và delete marker do versioning sinh ra — chúng chỉ hiện ra khi bật "List versions" / "Show versions".
Nói cách khác, đề không hỏi "làm sao xoá bucket", mà hỏi vì sao S3 vẫn coi bucket là còn nội dung trong khi mắt bạn thấy nó rỗng. Mọi phương án phải trả lời đúng câu hỏi đó, kể cả khi bản thân phương án mô tả một cơ chế có thật.
✅ Vì sao đáp án đúng là đúng
C — S3 versioning đang bật và các delete marker vẫn còn trong bucket.
S3 versioning giữ nhiều phiên bản của cùng một object trong cùng một bucket, để bạn khôi phục lại được sau thao tác nhầm của người dùng hoặc lỗi ứng dụng. Khi versioning bật:
- Ghi đè một object không thay thế nội dung cũ, mà tạo thêm một version mới; version cũ vẫn nằm đó.
- Xoá một object không xoá thật. S3 chèn một delete marker và biến nó thành version hiện hành. Object "biến mất" khỏi danh sách mặc định, nhưng cả delete marker lẫn các version trước đó vẫn nằm trong bucket.
Đó chính xác là tình huống trong đề: bạn xoá hết file, danh sách hiện ra rỗng vì mọi object hiện hành đều là delete marker, nhưng bucket vẫn chứa dữ liệu. S3 chỉ cho xoá bucket khi không còn version nào, nên nó trả lỗi "bucket is not empty". Muốn xoá được, phải xoá luôn các version và delete marker (bật chế độ xem version rồi xoá vĩnh viễn, hoặc dùng lifecycle rule dọn version cũ).
❌ Vì sao các phương án còn lại sai
A — "Some files are in Glacier": Đây là phương án gần đúng nhất về mặt cảm giác, vì Glacier đúng là nơi chứa dữ liệu "không thấy ngay". Nhưng cách hỏi ở đây gài theo hướng Amazon S3 Glacier như một dịch vụ riêng: ở đó dữ liệu lưu dưới dạng archive nằm trong vault, không nằm trong bucket. Dữ liệu ở vault không hề tham gia vào việc bucket rỗng hay không, nên không thể sinh ra lỗi "bucket is not empty". (Còn nếu là các object S3 đang ở storage class lạnh thì chúng vẫn hiện ra bình thường trong danh sách object — trái với mô tả "bucket đang rỗng" của đề.)
B — "S3 eventually consistent, đợi hai phút rồi thử lại": Phương án bịa dựa trên kiến thức đã lỗi thời. Amazon S3 cung cấp strong read-after-write consistency cho thao tác PUT và DELETE object ở mọi Region. Xoá xong là lần đọc kế tiếp thấy ngay kết quả đã xoá; không có độ trễ nào để "đợi cho nó đồng bộ". Lỗi ở đây cũng không phải lỗi tạm thời — thử lại bao nhiêu lần vẫn hỏng chừng nào version còn nằm đó.
D — "Bucket policy chặn việc xoá bucket": Cơ chế này có thật — bạn hoàn toàn có thể viết một bucket policy Deny cho hành động xoá bucket. Nó hỏng ở chỗ thông báo lỗi không khớp: chặn bằng policy sẽ trả về lỗi kiểu Access Denied / không đủ quyền, chứ không bao giờ nói bucket còn nội dung. Đây là bẫy kinh điển "cơ chế đúng, triệu chứng sai" — đề đã đưa sẵn thông báo lỗi cụ thể chính là để loại phương án này.
📌 Điểm cần nhớ
- Bám vào chính chuỗi thông báo lỗi. "Bucket is not empty" nói về nội dung, "Access Denied" nói về quyền. Phương án nào mô tả một cơ chế có thật nhưng sinh ra loại lỗi khác thì vẫn là sai.
- Với versioning bật, DELETE không xoá — nó tạo delete marker. Bucket trông rỗng ở chế độ xem mặc định nhưng vẫn còn version bên dưới; phải xem "list versions" mới thấy.
- Xoá bucket đòi hỏi không còn version nào, kể cả delete marker. Dọn bằng cách xoá vĩnh viễn từng version hoặc đặt lifecycle rule cho noncurrent version.
- S3 đã có strong read-after-write consistency; đừng chọn phương án đổ lỗi cho "eventual consistency" nữa — đó gần như luôn là mồi nhử trong đề thi AWS hiện nay.
- Phân biệt object trong bucket với archive trong vault của Glacier: hai mô hình lưu trữ khác nhau, và archive không ảnh hưởng tới việc bucket có rỗng hay không.
After enabling S3 MFA-Delete, for which actions do you need MFA? (Select two)
-
A
Permanently delete an object version
-
B
Suspending versioning
-
C
Listing deleted versions
-
D
Enabling Versioning
-
E
Uploading a new object version
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề hỏi: sau khi bật S3 MFA-Delete trên một bucket, những thao tác nào bắt buộc phải kèm xác thực đa yếu tố (chọn hai).
Cụm từ quyết định nằm ở chính tên và phạm vi của tính năng: MFA-Delete là một thuộc tính của cấu hình versioning trên bucket, và nó chỉ bảo vệ đúng hai loại hành động — thay đổi trạng thái versioning của bucket và xoá vĩnh viễn một object version. Mọi phương án trong danh sách phải được soi qua đúng hai mệnh đề đó, chứ không phải soi theo cảm giác "thao tác này nguy hiểm hay không".
Điểm bẫy: đề dùng chữ "delete" trong tên tính năng khiến người học nghĩ nó phủ mọi thao tác ghi/xoá, hoặc ngược lại chỉ phủ đúng thao tác xoá. Cả hai cách hiểu đều trượt — nó vừa hẹp hơn (không đụng tới upload, không đụng tới thao tác đọc) vừa rộng hơn (chạm cả sang việc tắt versioning) so với trực giác.
✅ Vì sao đáp án đúng là đúng
A — Permanently delete an object version. Trên bucket đã bật versioning, lệnh delete thông thường chỉ đặt một delete marker, dữ liệu vẫn còn. Thao tác thật sự phá huỷ dữ liệu là xoá một version cụ thể bằng cách chỉ đích danh version ID. Đây chính là hành động MFA-Delete sinh ra để chặn, nên nó đòi MFA.
B — Suspending versioning. Nếu chỉ bảo vệ thao tác xoá version thì kẻ tấn công có thể đi vòng: tắt versioning trước, sau đó xoá thoải mái. Vì vậy MFA-Delete bảo vệ luôn việc thay đổi trạng thái versioning của bucket, mà suspend chính là một thay đổi trạng thái. Đây là mảnh ghép làm cho lớp bảo vệ khép kín.
Về mặt kỹ thuật, hai thao tác này yêu cầu bucket owner gửi kèm header x-amz-mfa gồm serial number của thiết bị MFA và mã sáu số hiện trên thiết bị, và request bắt buộc đi qua HTTPS.
❌ Vì sao các phương án còn lại sai
C — Listing deleted versions. Đây là thao tác đọc metadata (liệt kê các version và delete marker). MFA-Delete không can thiệp vào đường đọc; quyền xem danh sách version do IAM/bucket policy quyết định. Không mất dữ liệu nào khi liệt kê, nên không có lý do bắt MFA.
D — Enabling Versioning. Đây là phương án gần đúng nhất và cũng dễ nhầm nhất, vì bật versioning cũng là thay đổi trạng thái versioning. Nhưng lưu ý thứ tự: MFA-Delete chỉ tồn tại sau khi versioning đã được bật — bạn không thể có MFA-Delete trên một bucket chưa từng bật versioning. Trong ngữ cảnh câu hỏi ("sau khi đã bật MFA-Delete"), hành động còn lại có thể xảy ra là suspend, tức phương án B. Bật versioning ban đầu không bị MFA-Delete chi phối.
E — Uploading a new object version. Upload là thao tác thêm dữ liệu, không phá huỷ gì: version cũ vẫn nguyên vẹn, phiên bản mới chỉ chồng lên ở vị trí "current". Vì không có mất mát nào để phòng, MFA-Delete không đụng tới PutObject. Nếu muốn siết quyền ghi thì đó là việc của IAM policy chứ không phải của MFA-Delete.
📌 Điểm cần nhớ
- MFA-Delete bảo vệ đúng hai thao tác: xoá vĩnh viễn một object version, và thay đổi trạng thái versioning của bucket. Học thuộc đúng hai mệnh đề này là xử được cả họ câu hỏi.
- Nó là tiện ích của versioning, phải bật versioning trước; và nó không thay thế IAM policy — thao tác đọc, ghi, liệt kê đều nằm ngoài phạm vi của nó.
- Lý do bảo vệ cả việc suspend versioning là để bịt đường vòng: tắt versioning rồi mới xoá.
- Request cho hai thao tác đó phải kèm header
x-amz-mfa(serial + mã sáu số) và đi qua HTTPS; đây là việc của bucket owner với credential gốc, không phải của IAM user bất kỳ.
Your website is hosted on S3 and exposed through a CloudFront distribution and some users are said to experience a lot of 501 errors.
How can you analyze these errors and come up with a solution?
-
A
Enable S3 access logs and analyze using Inspector
-
B
Analyze the CloudFront access logs using Inspector
-
C
Enable S3 access logs and analyze using Athena
-
D
Analyze the CloudFront access logs using Athena
Xem giải thích
🧩 Phân tích nội dung câu hỏi
Đề mô tả một website tĩnh nằm trên S3, được phục vụ ra ngoài qua một CloudFront distribution, và người dùng đang gặp rất nhiều lỗi 501. Câu hỏi là: làm sao phân tích đống lỗi đó để tìm ra hướng xử lý.
Cụm từ quyết định nằm ở chỗ "exposed through a CloudFront distribution" và "some users are said to experience". Nghĩa là:
- Người dùng không nói chuyện trực tiếp với S3 — mọi request đều đi qua CloudFront. Muốn biết chuyện gì xảy ra với người dùng, phải nhìn ở lớp mà người dùng chạm vào, tức là CloudFront.
- Việc cần làm là phân tích log, không phải quét lỗ hổng bảo mật. Chi tiết này loại ngay những phương án chọn sai công cụ.
Bốn phương án là tổ hợp của hai trục: nguồn log (S3 access logs hay CloudFront access logs) và công cụ phân tích (Inspector hay Athena). Trả lời đúng đòi hỏi chọn đúng cả hai trục.
✅ Vì sao đáp án đúng là đúng
D — Analyze the CloudFront access logs using Athena.
CloudFront có thể được bật để sinh ra access logs (standard logs), ghi lại thông tin chi tiết về từng request mà CloudFront nhận được: thời điểm, edge location phục vụ, IP của client, URI, và quan trọng nhất ở đây là HTTP status code trả về. Log được CloudFront ghi vào một S3 bucket do bạn chỉ định.
Đây chính là nguồn dữ liệu duy nhất trong danh sách phương án nhìn thấy được lỗi 501 ở đúng lớp mà người dùng gặp. Có log rồi thì lọc theo status code, xem lỗi tập trung ở URI nào, edge nào, khoảng thời gian nào — đó là "analyze these errors and come up with a solution" mà đề yêu cầu.
Athena là công cụ hợp lý để đọc đống log đó: nó truy vấn trực tiếp dữ liệu nằm trong S3 bằng SQL, không cần bốc dữ liệu đi đâu khác. Log CloudFront vốn đã nằm sẵn trong S3, nên chỉ cần khai báo bảng rồi truy vấn.
Một lưu ý theo tài liệu AWS: access logs của CloudFront được giao theo cơ chế best-effort — một bản ghi có thể tới muộn, và trong trường hợp hiếm có thể không tới. Vì vậy AWS khuyến nghị dùng log để hiểu bản chất của các request, chứ đừng coi đó là bản kê khai đầy đủ tuyệt đối mọi request. Với bài toán chẩn đoán lỗi 501 thì như vậy là đủ.
❌ Vì sao các phương án còn lại sai
A — Enable S3 access logs and analyze using Inspector. Sai cả hai trục. Nguồn log sai (xem phân tích ở C) và công cụ cũng sai (xem phân tích ở B).
B — Analyze the CloudFront access logs using Inspector. Nguồn log đúng, nhưng công cụ sai — và đây là phần khiến phương án hỏng. Amazon Inspector là dịch vụ đánh giá bảo mật tự động: kiểm tra khả năng tiếp cận qua mạng của các EC2 instance và tình trạng bảo mật của ứng dụng chạy trên đó. Nó không phải công cụ truy vấn log, không đọc được CloudFront access logs cũng như S3 access logs. Chọn phương án này là nhầm bài toán phân tích log vận hành thành bài toán quét bảo mật.
C — Enable S3 access logs and analyze using Athena. Đây là phương án gần đúng nhất, và cũng là bẫy chính của câu hỏi: công cụ chọn đúng, chỉ nguồn log là sai. Vấn đề nằm ở chỗ request tới S3 đã bị proxy qua CloudFront, nên trong S3 access logs bạn không thấy được IP thật của người dùng cùng những thông tin quan trọng khác về phía client — cái bạn thấy là CloudFront đang gọi vào bucket. Tệ hơn nữa, CloudFront có cache: những request được phục vụ ngay tại edge từ cache sẽ không bao giờ đi tới S3, nên chúng hoàn toàn không xuất hiện trong S3 access logs. Kết quả là bức tranh bạn dựng lại được từ nguồn log này vừa thiếu chi tiết vừa thiếu một phần lớn lưu lượng — không đủ để chẩn đoán lỗi mà người dùng đang gặp.
📌 Điểm cần nhớ
- Khi có CDN đứng trước origin, muốn phân tích trải nghiệm của người dùng thì lấy log ở lớp mà người dùng chạm vào (CloudFront access logs), không phải log của origin.
- S3 access logs không thay thế được CloudFront access logs: thiếu thông tin phía client vì request bị proxy, và thiếu hẳn phần lưu lượng đã được cache tại edge.
- Athena là lựa chọn mặc định để truy vấn log đang nằm trong S3 bằng SQL — không phải chuyển dữ liệu đi nơi khác trước khi phân tích được.
- Amazon Inspector là dịch vụ đánh giá bảo mật, không phải công cụ phân tích log. Thấy Inspector xuất hiện trong một câu hỏi về đọc log là dấu hiệu loại trừ khá chắc chắn.
- Access logs của CloudFront giao theo cơ chế best-effort, hợp để hiểu bản chất lưu lượng hơn là để đối chiếu số liệu chính xác từng request.